Оформление
Древовидный набор данных - Справка FineReport | Разработка отчетов | Отчеты | Учебные пособия
набор данных деревьев
1. Обзор
1.1 Версия
| Версия FineBI |
|---|
| 5.0 |
1.2 Сценарии применения
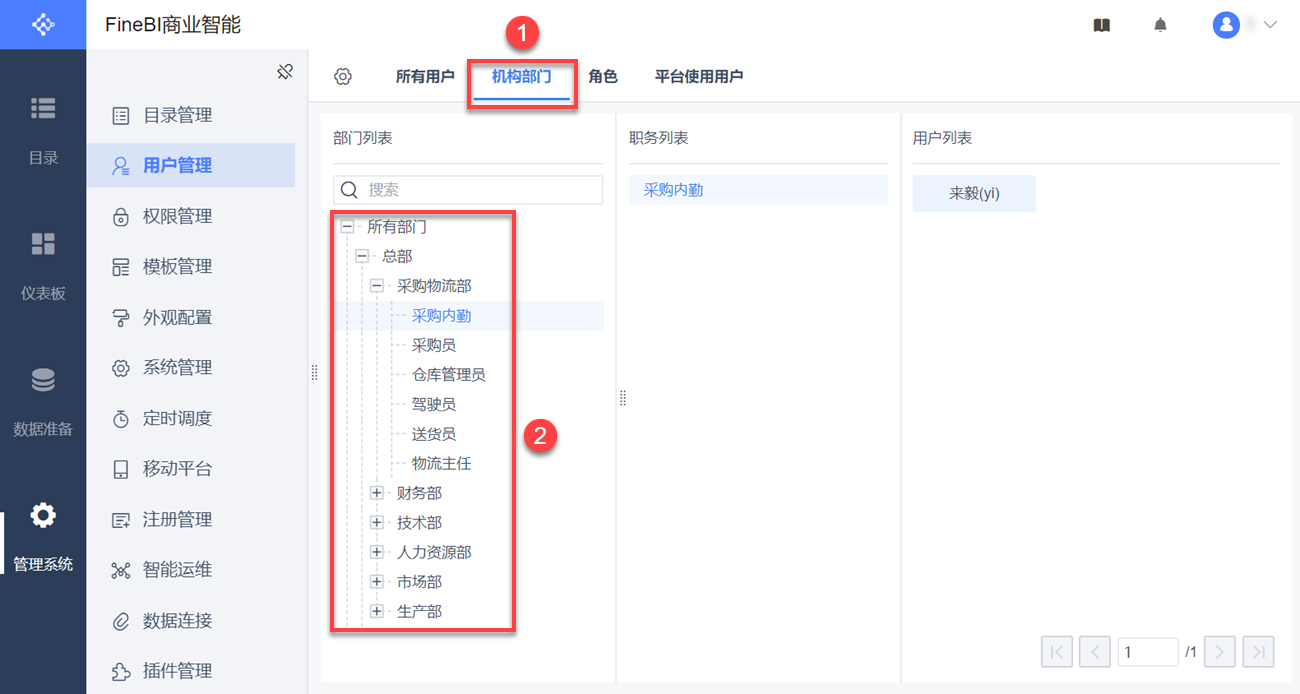
При импорте пользователей или синхронизации пользователей как одновременно импортировать/синхронизировать иерархию отделов? Это показано на рисунке ниже:
1.3 Функциональный профиль
В базе данных часто можно увидеть табличную структуру, таблица содержит ID и ID родителя два поля или определенную длину поля имеет определенную закономерность, эта табличная структура может представлять собой древовидный набор данных, через древовидный набор данных может быть сгенерирована древовидная иерархическая структура.
2. Примеры
2.1 Подготовка листов данных
1) Нажмите, чтобы скачать таблицу с информацией: Сектор компании.xls
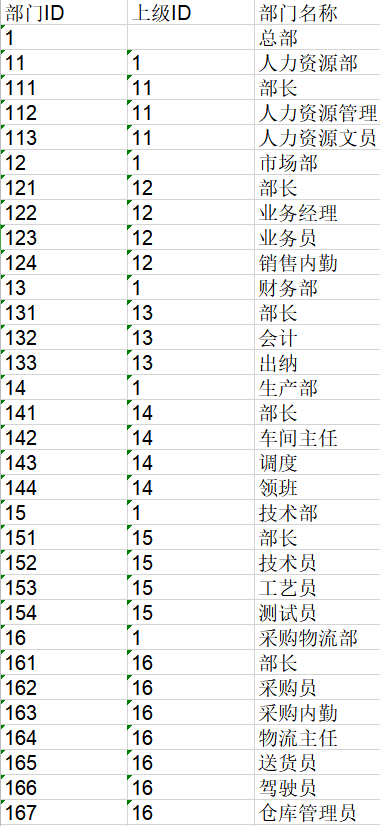
Информация о таблице приведена ниже:
2) Добавьте таблицу "Отдел компании" в собственную базу данных пользователя, либо создайте новую таблицу с информацией о пользователе в собственной базе данных.
2.2 Новый набор данных SQL
Администратор входит в Data Decision System, нажимает "Management System > Data Connections > Server Dataset > SQL Dataset", называет набор данных "Company Departments", вводит SQL-запрос и нажимает "Save". Как показано на рисунке ниже:
Оператор SQL для:
select *from company sector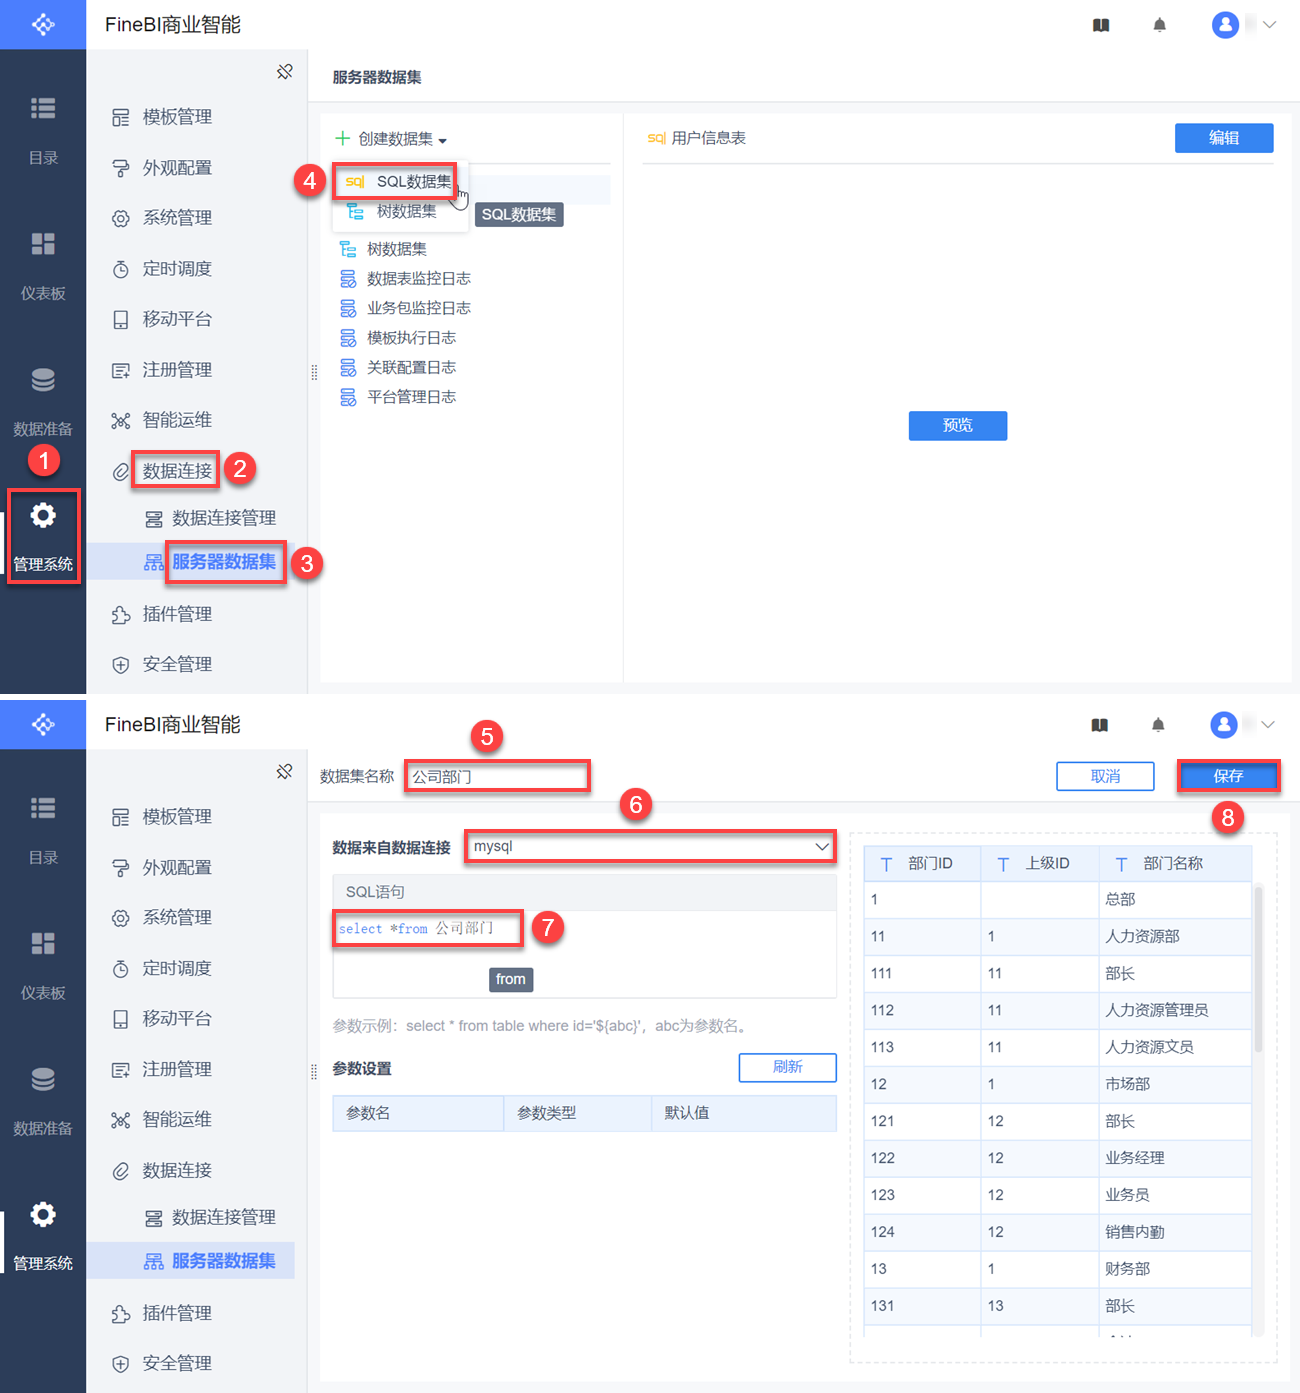
2.3 Новый набор данных о деревьях
2.3.1 Метод 1: Построение дерева на основе родительского поля с метками в выбранном наборе данных
1) Нажмите "Tree Dataset", имя набора данных - "Department Tree", исходное поле с меткой - "Department ID", а родительское поле с меткой - "Parent ID", как показано на рисунке ниже:
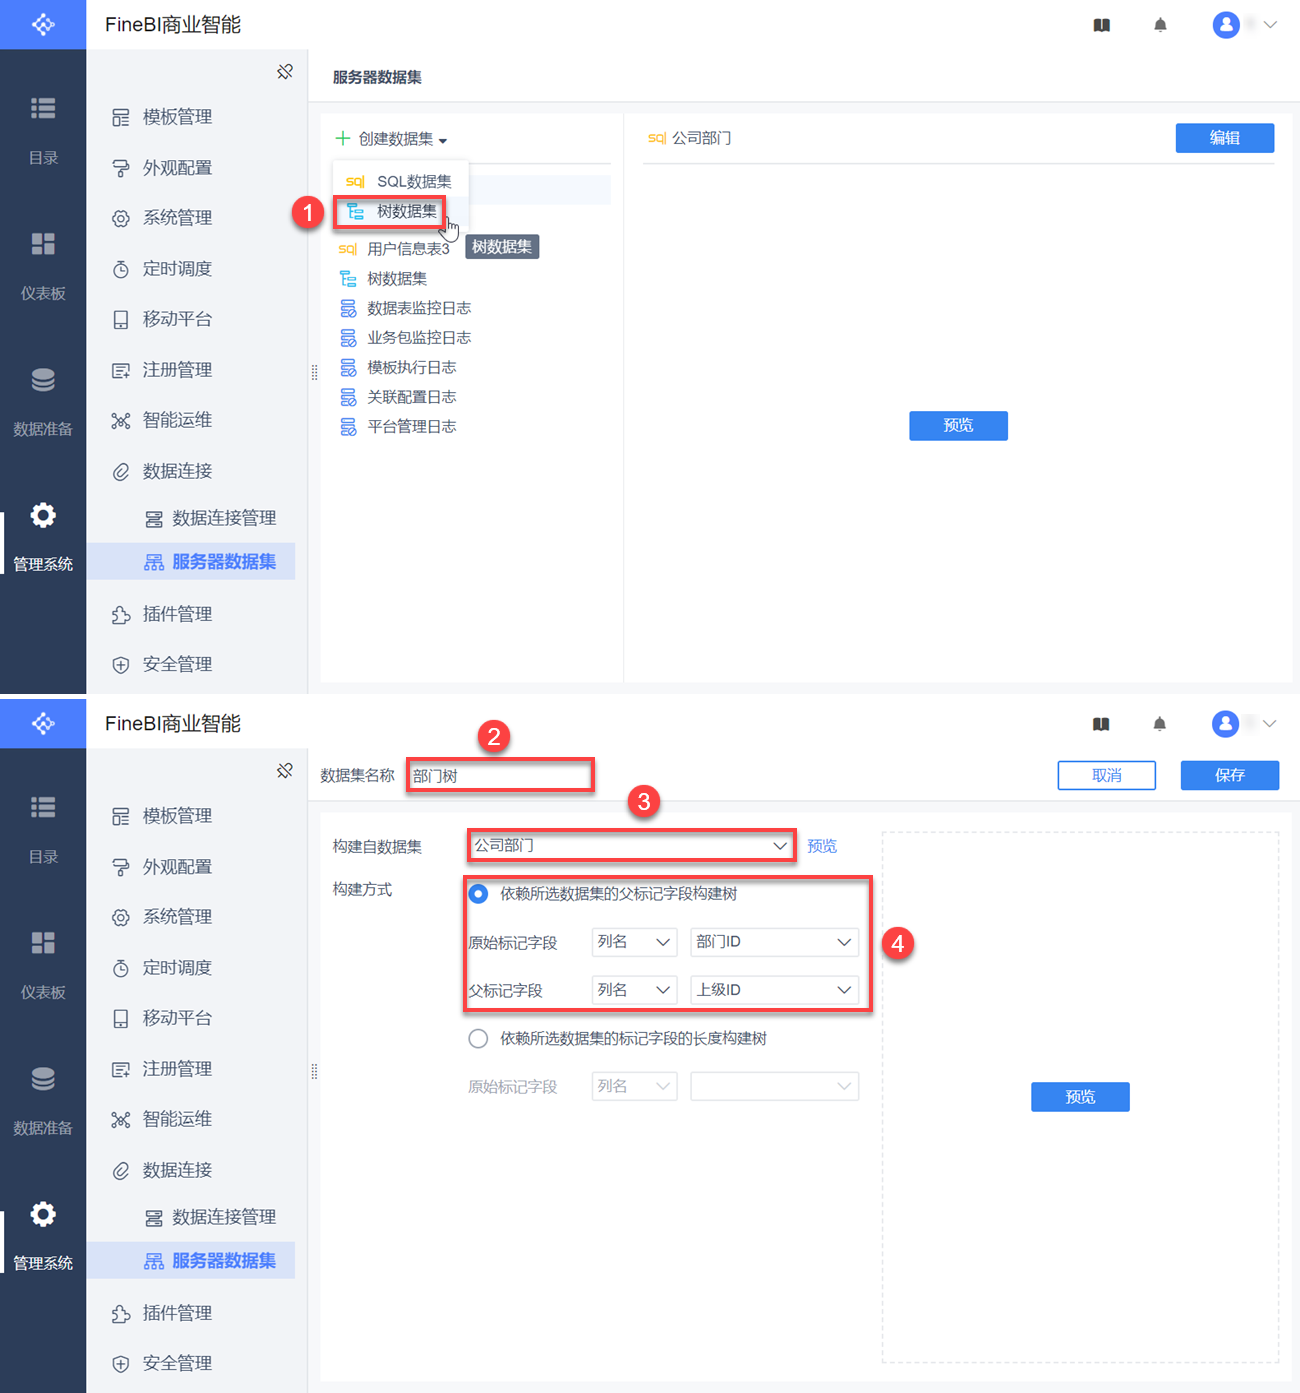
Набор данных дерева получен из набора данных SQL, созданного в разделе 2.2 этого документа. "Отдел компании" имеет идентификатор отдела и идентификатор родителя, поэтому дерево может быть построено с использованием родительских полей с метками, которые зависят от выбранного набора данных.
Важно отметить, что в этом случае необходимо иметь уникальный корневой узел (т.е. узел с нулевым "родительским идентификатором"); если его нет, дерево не будет корректно проиндексировано при построении.
2) Нажмите кнопку "Предварительный просмотр", чтобы увидеть данные, как показано ниже:
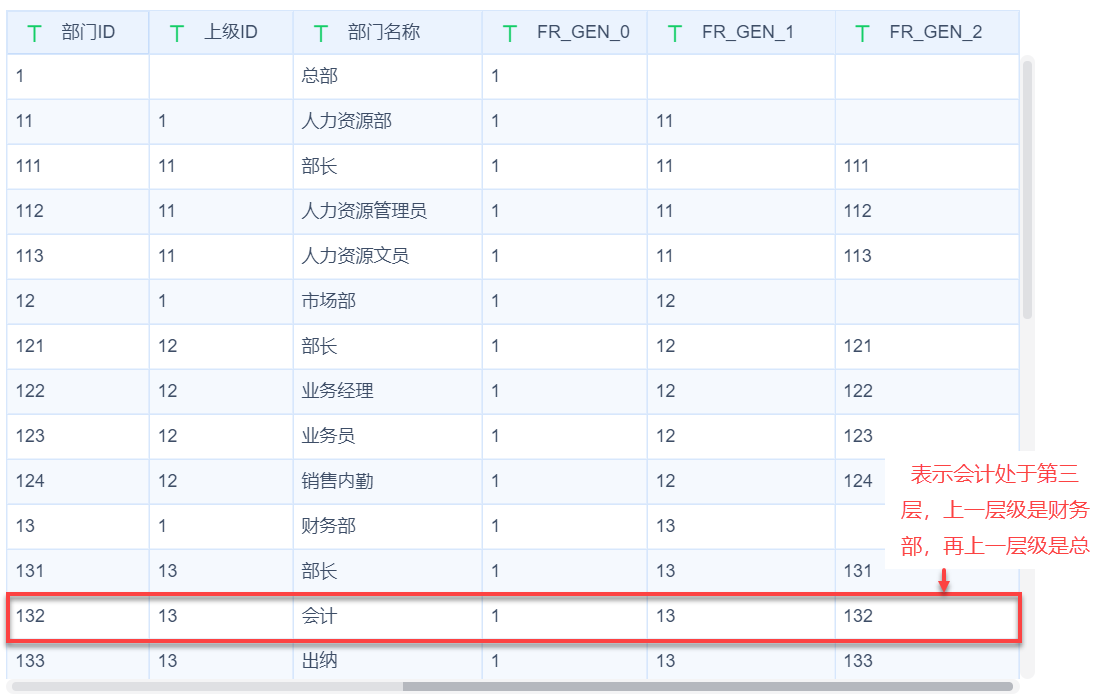
Вы видите, что в наборе данных есть еще три поля: FR_GEN_0 представляет первый уровень древовидной структуры, FR_GEN_1 представляет второй уровень древовидной структуры, а FR_GEN_2 представляет третий уровень древовидной структуры.
3) Нажмите кнопку "Сохранить", чтобы сохранить созданный набор данных деревьев.
2.3.2 Метод 2: Построение дерева на основе длины маркированных полей выбранного набора данных
1) Нажмите "Tree Dataset", имя набора данных - "Departmental Tree", и выберите "Departmental ID" для исходного поля разметки, как показано на следующем рисунке:
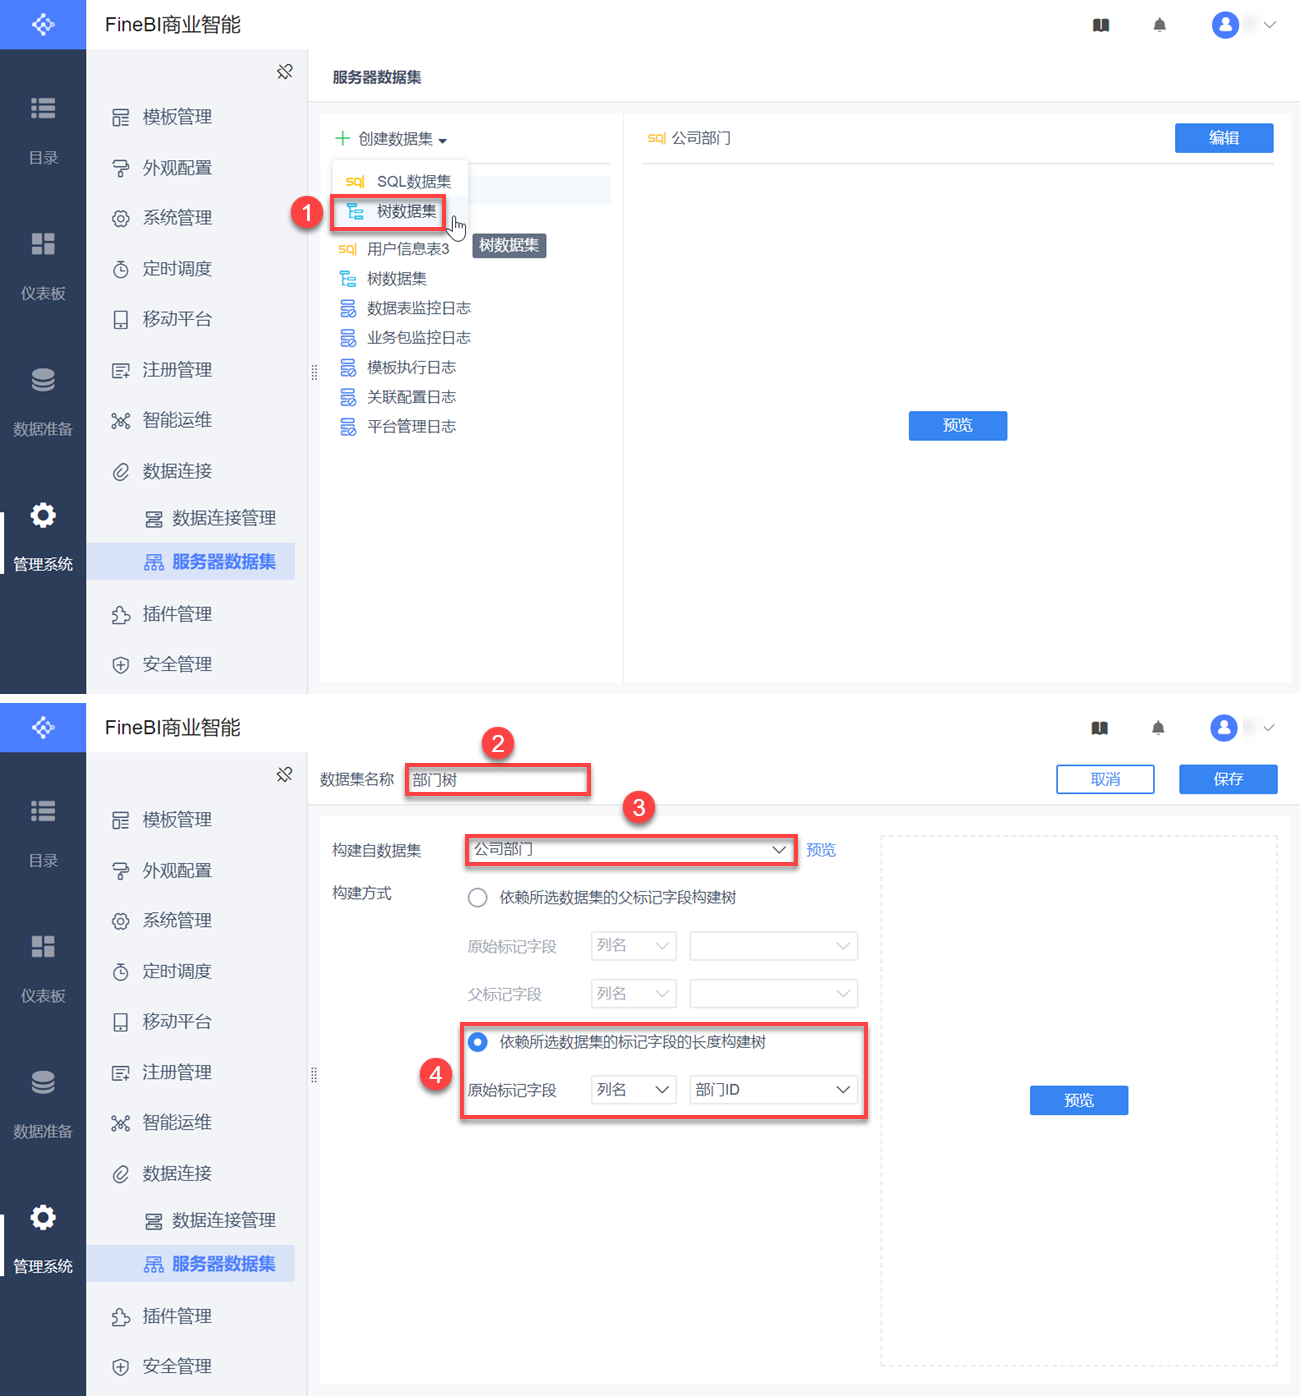
Поля в таблице данных не имеют родительских полей; вместо этого их уровень различается длиной поля. Поле Department ID для отделов компании имеет непостоянную длину полей, но существует определенная закономерность: первое число до первого уровня указывает на Department ID отдела первого уровня, второе число до второго уровня указывает на Department ID отдела второго уровня и так далее.
Примечание: ID отдела, ID родительского отдела и название отдела - это три поля для построения дерева. На практике ID отдела и название отдела должны соответствовать друг другу, и не может быть случаев, когда ID отдела совпадают.
2) Нажмите кнопку "Предварительный просмотр", чтобы увидеть данные, как показано ниже:
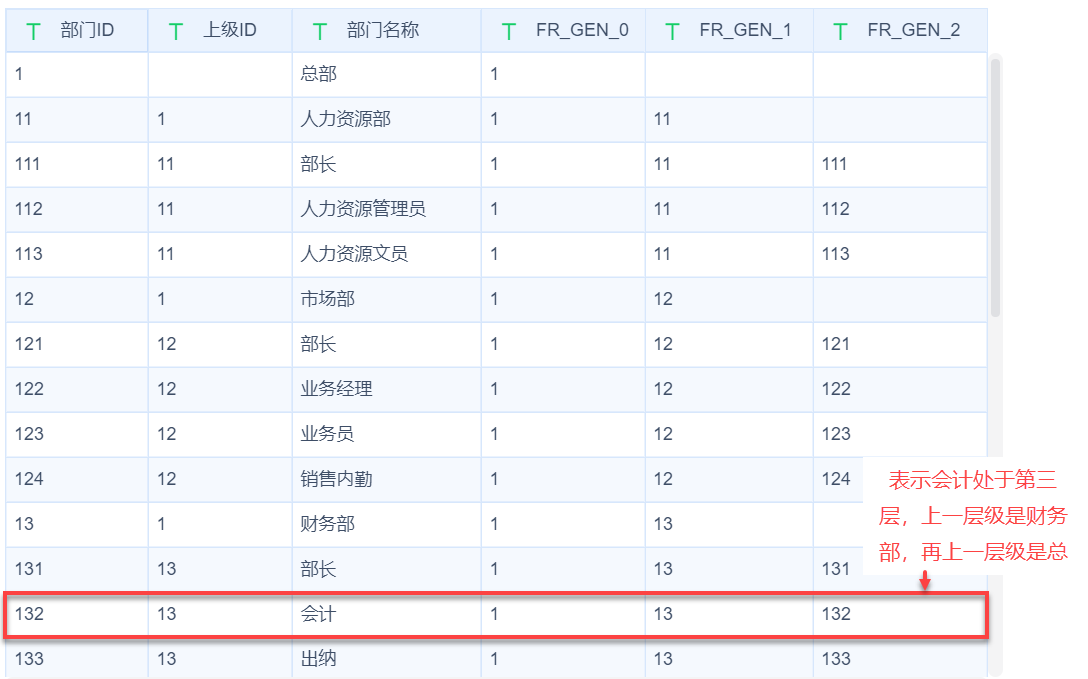
Вы видите, что в наборе данных есть еще три поля: FR_GEN_0 представляет первый уровень древовидной структуры, FR_GEN_1 представляет второй уровень древовидной структуры, а FR_GEN_2 представляет третий уровень древовидной структуры.
3) Нажмите кнопку "Сохранить", чтобы сохранить созданный набор данных деревьев.
3. Требования к листу данных для набора данных spanning tree
3.1 Исходное поле тега, родительское поле тега является числовым
3.1.1 Листы данных
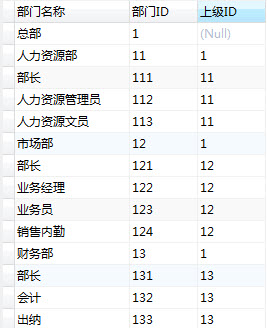
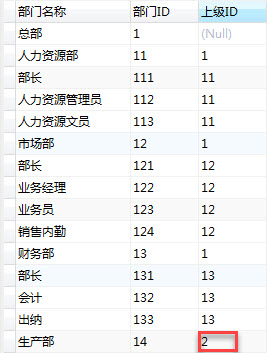
Это полный древовидный набор данных, построенный с использованием 'Department ID' в качестве исходного поля с меткой и 'Parent ID' в качестве родительского поля с меткой.
Первая строка означает, что тег штаб-квартиры равен 1, а родительский тег пуст, что означает, что это корневой отдел и у него нет родительского отдела. Обычно, если у отдела нет родительского отдела, то тег родительского отдела пуст. Вторая строка означает, что исходный тег "Отдел кадров" - 11, а его родительский отдел - это отдел, помеченный 1 (и тогда вы можете запросить, что его родительский отдел - это штаб-квартира, основываясь на этом теге).
Просмотрев этот набор данных, вы сможете получить всю информацию об отделах и должностях; в соответствии с "ID родителя" перейдите к столбцу "ID отдела", чтобы найти соответствующее название отдела, и вы сможете построить родительский отдел.
3.1.2 Особые указания
Все маркеры, встречающиеся в "Superior ID" (кроме пустого), должны найти свои соответствующие маркеры в "Department ID". Вы можете видеть, что все "Superior ID" на рисунке выше могут найти свои соответствующие значения в "Department ID".
Если произошел следующий случай: "Superior ID" равен 2, но в "Department ID" нельзя найти информацию об отделе, которая равна 2, поэтому нет возможности построить информацию об отделе, у которой "Superior ID" равен 2, и тогда дерево считается неполным. Если вы синхронизируете набор данных, содержащий информацию о пользователе, действие синхронизации возвращается напрямую, и операция синхронизации не выполняется.
3.2 Поле оригинальной маркировки, поле родительской маркировки китайскими иероглифами
3.2.1 Листы данных
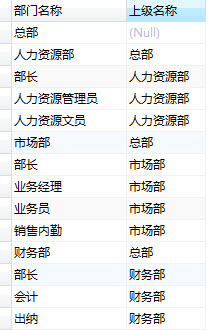
При построении древовидного набора данных исходным полем тега является 'Department Name', а полем родительского тега - 'Parent Name'.
3.2.2 Особые указания
Все лексемы, встречающиеся в "Имени начальника" (за исключением пустых), должны иметь соответствующие лексемы в "Имени отдела", иначе дерево будет считаться неполным. Если вы синхронизируете набор данных, содержащий информацию о пользователе, действие синхронизации возвращается напрямую, без операций синхронизации.
3.3 Исходное поле маркера, родительское поле маркера - буквенное
3.3.1 Листы данных
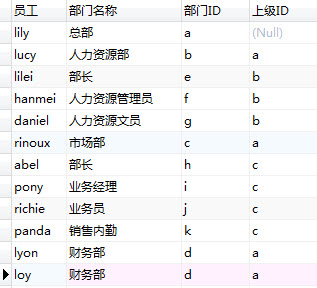
Древовидный набор данных построен с "Идентификатором отдела" в качестве исходного поля с меткой и "Идентификатором родителя" в качестве родительского поля с меткой.
Также необходимо убедиться, что столбец "ID родителя" можно найти в столбце "ID отдела", иначе синхронизация также будет отклонена.
3.3.2 Особые указания
Убедитесь, что набор данных дерева является правильным:
1) Любое значение, появляющееся в родительском поле тега (за исключением нуля), найдет соответствующее значение в исходном поле тега.
(2) Строки с одинаковым полем исходного тега должны иметь одинаковые два столбца для названия отдела и родительского тега, как, например, последние две строки в таблице данных выше.
3) Строки с одинаковым родительским тегом и названием отдела должны иметь одинаковый столбец исходного тега, как, например, последние две строки в таблице данных выше.
Невозможно сформировать древовидный набор данных:
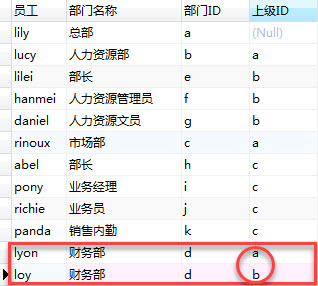
1) Определенный отдел с двумя родительскими отделами явно не является древовидной структурой. Это показано на рисунке ниже:
2) Также неправильно, если тегу соответствует другое название отдела, это также приведет к отказу в синхронизации.
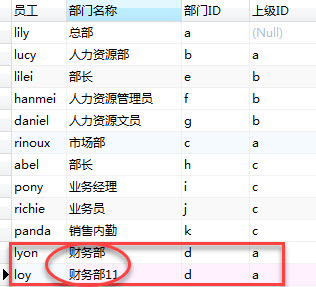
3) Это означает, что если родительский отдел определен и название отдела уникально, то тег отдела также уникален. Ниже приведен пример ошибки:
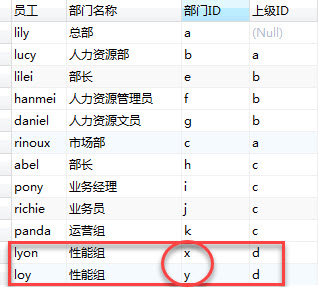
Можно иметь одинаковые названия отделов, например, если в отделе продаж есть отдел под названием Performance Group, отдел исследований и разработок также может иметь отдел под названием Performance Group. Но когда определяется родительский отдел, имя отдела не может быть продублировано.
Например: lyon и loy находятся в отделе performance group, а родительский отдел имеет маркировку d, то это показывает, что два человека в одном отделе, тогда маркировка отдела должна быть одинаковой, на рисунке выше у двух сотрудников маркировка отдела не совпадает, тогда это также сообщит об ошибке, отказано в синхронизации. Т.е. в случае, когда родительский отдел идентифицирован, отдел может быть однозначно идентифицирован на основе названия отдела.
(4) На практике также существует ситуация взаимного подчинения, такая структура или данные иногда появляются в некоторых компаниях с плоским менеджментом, то есть отдел А является начальником отдела Б, а отдел Б - начальником отдела А. Такие два отдела также могут потерпеть неудачу при организации синхронизации, но это бывает редко.
4. условия
Поля типа 0,,0000000 не должны появляться в полях оригинальных и родительских тегов, так как эти теги будут разобраны как 0, который является зарезервированным полем в программе и является идентификатором всех отделов, поэтому старайтесь избегать его.
При построении древовидной структуры, если у отдела нет родительского отдела, то родительский отдел остается пустым, а не просто записывается.