Оформление
Параметры BI/Spider - Справка FineReport | Разработка отчетов | Использование отчетов | Учебные пособия
Параметры BI/Spider
1. Обзор
1.1 Версия
| Версия FineBI | Функциональные изменения |
|---|---|
| 6.0 | - |
| 6.0.2 | Логика распознавания типов данных оптимизирована для более точного определения битов данных |
| 6.0.3 | Добавлен BI-параметр "Интеллектуальная интерпретация данныхДобавлен новый BI-параметр "Extract Query Timeout"."Параметры паука" переименованы в "Параметры извлечения". |
| 6.0.4 | 1) Новые параметрыДобавлен BI-параметр "Оставшееся дисковое пространство для экспорта в Excel".Добавлен параметр извлечения "Интервал времени обновления высокой производительности".2) Удаление параметровУдалите параметр извлечения "Spark Driver Port".Удалите параметр извлечения "Порт Spark blockManager".Удалите параметр извлечения "Spark Dynamic Tuning".(3) Оптимизация классификации параметров, корректировка классификации некоторых параметровНастроены параметры "Ограничение на количество одновременных потоков, экспортируемых из таблицы деталей" и "Количество потоков для расчета нескольких показателей" в BI Parameter-Advanced Tuning Parameter.Настройте параметры "уровень вывода журнала искр" и "дата режима lite" на параметр извлечения - базовый параметр.Настройте параметры "spark local mode temporary file path" и "incremental update data block organisation plan" в параметрах извлечения - advanced tuning parameters. |
| 6.0.5 | BI-параметр "Интеллектуальная интерпретация данных" по умолчанию выключен. |
| 6.0.8 | 1) "Параметр извлечения" переименован в "Параметр паука".2) Новые параметрыДобавлен параметр Spider "Активный цикл доступа к данным (дни)Добавлен параметр Spider "Период активности создания данных (дни)".Добавлен параметр Spider "Время глобальной проверки активности данных".3) Удаление параметровУдаление параметра Spider "Analyse user self-help dataset disk occupancy size (cell)". |
| 6.0.9 | 1) Добавьте ограничения для необоснованных вычислений, после группировки и после объединения слева и справа количество данных слишком велико, тогда вычисления будут прерваны при выполнении в компоненте/панели.2) Удалите BI-параметр "Количество потоков для расчета мультииндикаторов". |
| 6.0.14 | Новый параметр "Manual Preview Alert (sec)" добавлен в раздел "BI Parameters > Advanced Tuning Parameters". |
1.2 Функциональный профиль
FineBI предоставляет функцию настройки некоторых параметров BI и параметров настройки в управлении системой, что удобно для руководства системы и исполнителей проектов, чтобы легко и быстро понять текущую конфигурацию системы и выполнить быстрые настройки на интерфейсе.
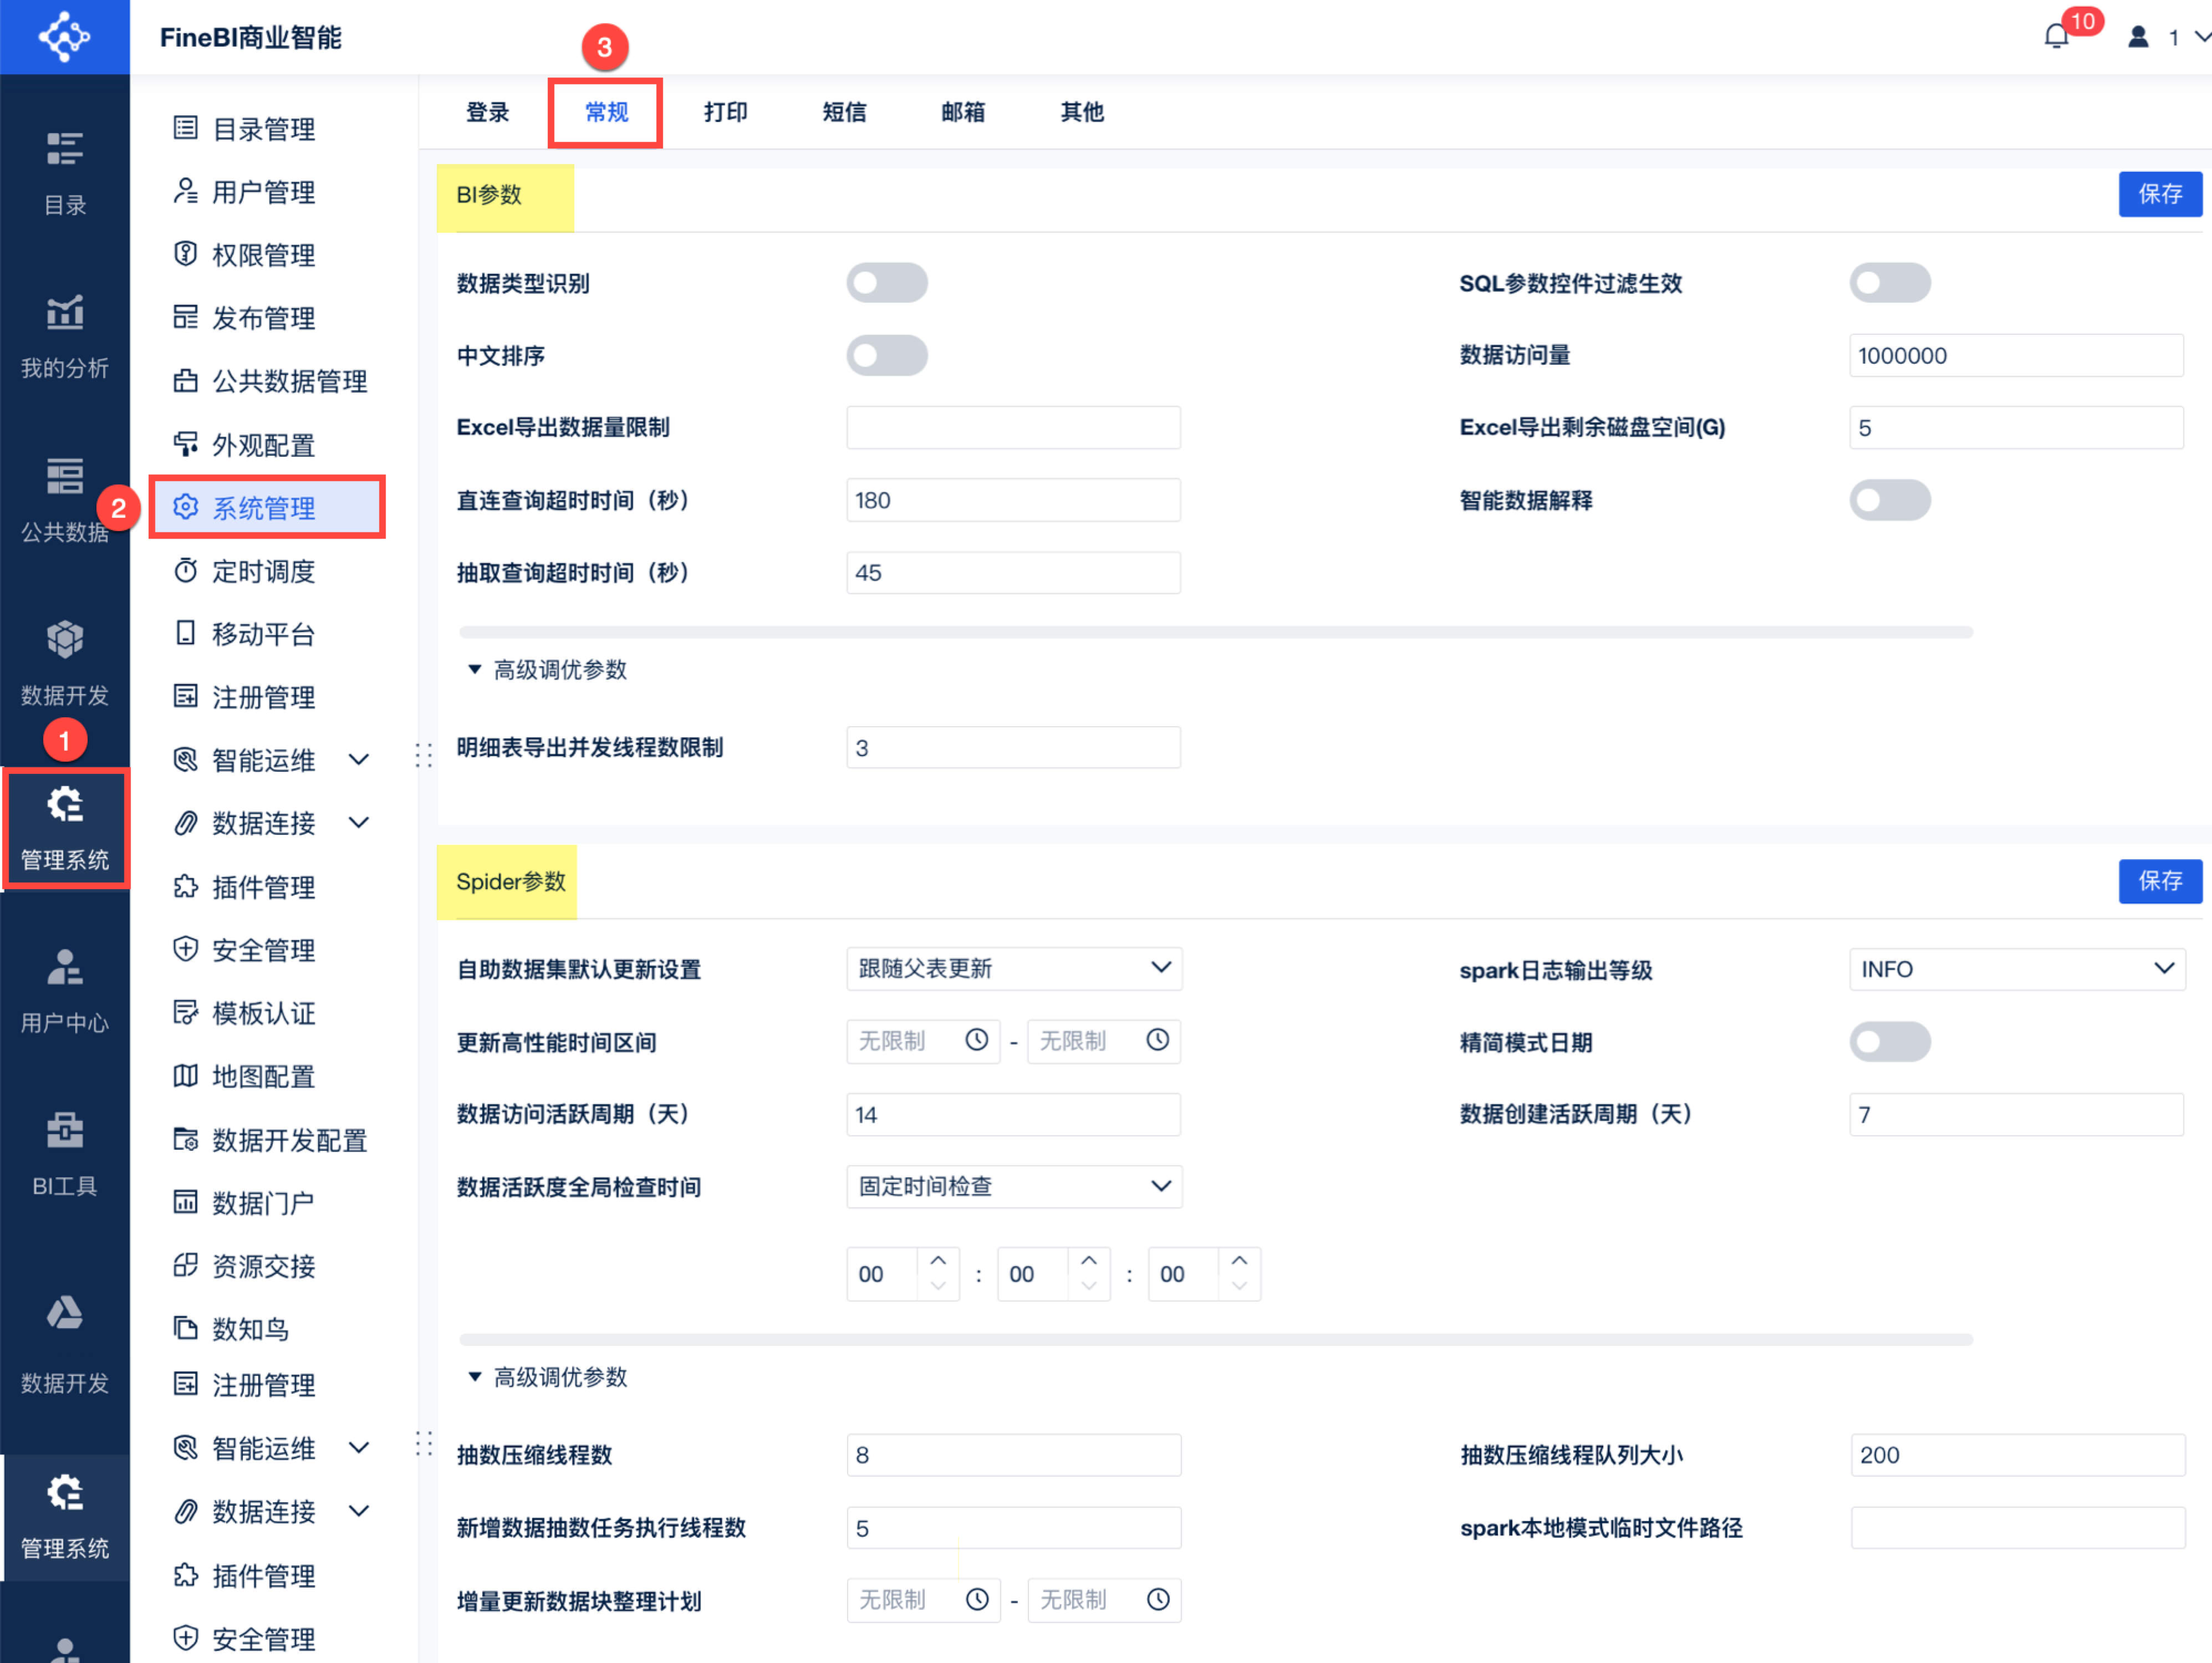
Администратор входит в систему FineBI и переходит в раздел "System Management > Управление системой > Общие", где отображается страница настройки параметров BI и параметров извлечения. Как показано на следующем рисунке:
2. параметры BI
Примечание: Параметр BI действует только на функцию FineBI и не влияет на FineReport.
2.1 Основные параметры
| параметрический | определить | значение по умолчанию | Является ли модификацияНеобходимо перезапустить проект |
|---|---|---|---|
| распознавание типов данных | 1) Независимо от того, включена эта функция или нет, поля всегда распознаются как числовые типы, если в них есть несколько десятичных знаков.(2) Если функция распознавания типа данных не включена, более 15 бит распознаются как текстовый тип, а менее или равные 15 бит - как числовой тип.3) После включения функции распознавания типа данных он всегда распознается как числовой тип (double), а эффективная точность double составляет 15 бит (2^52), поэтому, когда длина значения превышает 15 бит, точность может быть потеряна.4) Таблицы, добавленные без включенных параметров (напрямую подключенные и распределенные)😗 Если таблица не редактировалась, включите перезапуск параметров, войдите в интерфейс редактирования таблицы, можно получить числовой тип поля, повторное сохранение возможно. * Если таблица редактируется (в 5.1.5 и более поздних версиях это делается с помощью преобразования типа поля), то после перезапуска с включенным параметром вход в экран редактирования таблицы по-прежнему будет иметь текстовый тип и больше не будет считываться как значение. | свертывание | быть |
| Действует фильтрация управления параметрами SQL | Эффективны ли одновременно функция привязки параметров SQL и функция фильтрации.По умолчанию выключен, что означает, что он не действует | свертывание | засорение |
| Китайская сортировка | Использовать ли китайскую сортировкуПо умолчанию выключено, означает отсутствие китайской сортировкиПри включении этой функции таблица, из которой были извлечены данные, должна быть перерисована.Дополнительную информацию см. в разделе: Сортировка Раздел 1.4 | свертывание | быть |
| Доступ к данным | Объем доступа к данным ограничивает количество строк данных, которые могут быть считаны в память сервера. Не во всех сценариях вычислений с большим объемом данных все данные считываются в память. Движок FineBI Spider имеет интеллектуальные политики использования памяти:* Вычисления в компоненте/панели прерываются, когда количество строк данных после выполнения группированной сводки превышает [установленное значение]. * При меньшей таблице данных в левом/правом объединении, в которой сгруппированы связанные поля, превышающие количество строк [Set Value], расчет в компоненте/панели будет прерван. Слишком низкие значения конфигурации повлияют на точность расчетов данных.Чрезмерная конфигурация и риск простоя системы.Единица измерения: рядыНастраиваемый интервал: [0, 10000000].Рекомендуемый диапазон настройки: [10000, 1000000], рекомендуется сохранить значение по умолчанию | 1,000,000. | быть |
| Ограничение объема экспортируемых данных Excel | Пользователи могут превысить лимит объема данных при экспорте в Excel, чтобы облегчить пользователю установку этого параметра, при превышении лимита экспорта будет выдаваться сообщение об ошибке.Единица измерения: ячейка (строка*столбец)Диапазон конфигурации: 0-2000000000Рекомендуемый диапазон конфигурации: 0-10000000 | незанятый | засорение |
| Экспорт Excel оставшегося дискового пространства (G) | При экспорте Excel выполняется проверка места на диске, и если объем дискового пространства меньше предельного значения, процесс экспорта прерывается. Предотвращает простои из-за переполненных дисков.После срабатывания этого ограничения экспорт завершится неудачей, а во всплывающем окне системы появится сообщение об ошибке: текущий объем экспортируемых данных слишком велик и на диске недостаточно места. Сработал механизм защиты системы, экспорт прерван. Пожалуйста, своевременно очищайте дисковое пространство, ограниченное параметром [Проверка дискового пространства при экспорте Excel], ограничение дискового пространства: XXGДиапазон конфигурации: 5 ~ неограниченно | 5 | засорение |
| Таймаут запроса прямого соединения (секунды) | Если в приборной панели слишком много компонентов, время запроса компонента будет слишком большим, или время запроса компонента в приборной панели будет слишком большим, в результате чего последующие BI-запросы будут блокироваться, что можно легко принять за простой продукта.В это время вы можете установить таймаут для прямого запроса, и все запросы данных в реальном времени будут прерваны по истечении таймаута, чтобы предотвратить блокирование нормальных запросов аномально медленными запросами.Компонент возвращает следующую ошибку: Время запроса компонента превысило Xmin, запрос был прерван.Единица измерения: секундыРекомендуемый диапазон конфигурации: 10-300Область применения: все запросы BI Direct, кроме получения структуры таблицы | 180 | засорение |
| Интеллектуальная интерпретация данных | Контролирует, способен ли компонент к интеллектуальной интерпретации данных, если он не настроен активно; по умолчанию выключен.Эта настройка вступает в силу после установки плагина Data Interpretation.В закрытом состоянии интерпретация данных, настроенная вручную, может быть запущена только во избежание неправильного использования интерпретаций данных | свертывание | Засорение |
| Таймаут запроса на извлечение (секунды) | Если в приборной панели слишком много компонентов, время запроса компонента будет слишком большим, или время запроса компонента в приборной панели будет слишком большим, в результате чего последующие BI-запросы будут блокироваться, что можно легко принять за простой продукта.В это время вы можете установить таймаут запроса на извлечение, все извлеченные данные будут прерваны после завершения запроса, чтобы предотвратить блокирование нормальных запросов аномальными медленными запросами.Компонент возвращает следующую ошибку: Время запроса компонента превысило xxx, запрос прерванЕдиница измерения: секундыРекомендуемый диапазон конфигурации: 10-300 | 45 | Засорение |
2.2 Дополнительные параметры настройки
| параметрический | определить | значение по умолчанию | Нужно ли перезапускать проект после внесения изменений |
|---|---|---|---|
| Ограничение на количество одновременных потоков, экспортируемых из расписания | Когда несколько пользователей одновременно экспортируют данные Excel с большим объемом, количество параллельных операций может быть превышено, что негативно скажется на работе пользователей, поэтому данный параметр предназначен для установки количества пользователей, которые будут выполнять экспорт подробных таблиц одновременно. Если лимит экспорта превышен, продавцу придется подождать. Диапазон конфигурации: 1-10 Рекомендуемый диапазон настройки: 1-5, рекомендуется оставить значение по умолчанию | 3 | быть |
| Ручное предупреждение о предварительном просмотре (секунды) | Единица измерения - секунды, по умолчанию - пусто, пусто означает, что параметр ручного предварительного просмотра не включен.После настройки этого параметра все компоненты, запрашивающие данные, превышают установленное время запроса, предлагая пользователю открыть ручной предварительный просмотр, но не обязывая его открывать. Снижение нагрузки на движок при запросахПараметры не требуют перезагрузки и вступают в силу сразу после настройки. | незанятый | Засорение |
3. параметры паука
Примечание: Параметр извлечения действует только на функцию извлечения FineBI и не влияет на данные FineReport и FineBI в реальном времени.
3.1 Основные параметры
| параметрический | определить | значение по умолчанию | Нужно ли перезапускать проект после внесения изменений |
|---|---|---|---|
| Параметры обновления по умолчанию для наборов данных Self-service | Следует ли обновление отдельной таблицы набора данных Self-service за обновлением родительской таблицыДополнительную информацию см. в разделе: Обновления листов данных Self-service | Следите за обновлениями родительского стола | быть |
| Уровни выходного сигнала журнала искр | Уровень вывода журнала Spark, стандартный поток вывода, вывод в файл catalina.out в Tomcat или в файл nohup в BI.Варианты: INFO, WARN, ERROR, DEBUG.* INFO: печатает классы ошибок и основные журналы выполнения * WARN: выводит сообщение типа предупреждения или напоминания. * ERROR: печатает только журналы типов ошибок * DEBUG: Печать всех журналов | INFO | быть |
| Обновление временных интервалов высокой производительности | Неограниченное обновление заполненности ядра пула ресурсов за настроенный период времени.Чтобы не влиять на работу пользователей, рекомендуется настраивать его на период времени, когда система не занята и задачи обновления выполняются часто.Примечание: Вступает в силу после перезапуска проекта BI | незанятый | засорение |
| Дата в режиме Lite | Если включен режим Lite, то при извлечении данных из полей даты заранее генерируется только небольшое количество типов группировок, что ускоряет генерацию и сокращает занимаемое пространство. Несгенерированные подгруппы могут привести к снижению производительности при выполнении вычислений. | свертывание | Да (и данные должны быть обновлены) |
| Активный цикл доступа к данным (дни) | Непрерывный период активности после обращения к набору данныхАктивным считается набор данных с одним из двух следующих условий: ● Приборные панели/компоненты, созданные на основе наборов данных , которые редактируются или к которым осуществляется доступ в течение x дней ● Подтаблица набора данных, отредактированная и сохраненная в течение x днейЕдиница измерения: дни | 14 | быть |
| Активный цикл создания данных (дней) | Непрерывный активный период после создания набора данныхНабор данных считается активным в течение x дней после создания и неактивным после этого.Единица измерения: дни | 7 | быть |
| Время глобальной проверки активности данных | Контрольное время для определения активного состояния набора данных.Доступ к наборам данных, их создание будут единообразно проверяться в это время, обновляя их активный статус, так что часть наборов данных будет установлена как не извлекаемые.Дополнительно: :: Проверка по фиксированному времени: проверка в XXX каждый день, задайте формат hh:mm:ss :: Глобальное обновление предварительных проверок заданий | Проверка с фиксированным временем00:00:00 | быть |
3.2 Дополнительные параметры настройки
| параметрический | определить | значение по умолчанию | Является ли модификацияНеобходимо перезапустить проект |
|---|---|---|---|
| Количество резьбовых соединений для прокачки | Количество потоков нарезки (сжатия и записи) при извлечении данныхВ случаях, когда память невелика (не более 4 Гб) и не может быть увеличена, поток может быть настроен на снижение нагрузки на памятьСлишком низкая конфигурация приведет к замедлению обновления данных.Конфигурация слишком высока и может повлиять на пропускную способность других задач при обновлении данныхРекомендуется сохранить значение по умолчанию 8.Рекомендуемый интервал: [4, 16] | 8 | быть |
| Число подкачки для сжатия размера очереди потоков | Длина очереди необработанных фрагментов при извлечении данныхВ случае если память очень мала (не более 4 Гб) и нет возможности ее расширить, можно уменьшить длину очереди, чтобы снизить нагрузку на памятьСлишком низкая конфигурация замедлит обновление данныхКонфигурация слишком высока и может повлиять на пропускную способность других задач при обновлении данныхРекомендуется сохранить значение по умолчанию 200.Рекомендуемый диапазон: [100, 200] | 200 | быть |
| Количество потоков, добавленных в задачу извлечения данных | Количество потоков, в которых одновременно выполняется задача подкачки для добавления новых данных. Если память очень мала (не более 4 Гб) и не может быть увеличена, количество потоков может быть изменено в сторону уменьшения, чтобы снизить нагрузку на память. При слишком высокой конфигурации обновление данных может повлиять на пропускную способность других задач. Рекомендуется оставить значение по умолчанию 5 Рекомендуемый диапазон: [1, 5]. | 5 | быть |
| Путь к временному файлу в локальном режиме Spark | Spark записывает временные файлы в каталог, необходимо выделить достаточно места, изменение пути монтирования SSD может улучшить производительность корреляции обработки Spark, запросов SparkSqlПримечание: Этот параметр не действует для кластерной версии и должен быть настроен на стороне сервера. | null (на самом деле /tmp в Linux) | быть |
| Инкрементное обновление плана свертки блоков данных | В течение этого периода времени задачи инкрементного обновления не выполняют операции слияния, что повышает скорость инкрементных обновлений Формат hh:mm:ss-hh:mm:ss Пример 10:10:10-12:12:12 | свертывание | быть |