Оформление
Принципы инженерного развертывания - FineReport Справочная документация|Разработка отчетов|Использование отчетов|Учебные пособия
Принципы инженерного развертывания
Описание
В этой статье дается краткое описание:
1) Необходимость инженерного развертывания/обоснование развертывания
2) Введение/различие/сценарии применения/компоненты автономного и кластерного оборудования
3) Разница между различными методами развертывания, что такое контейнерное развертывание?
Принципы инженерного развертывания
Почему я не могу использовать локальный FineBI, а должен развернуть проект на сервере?
Вопрос: Почему пользователям нужно разворачивать проект FineBI на стороне сервера, когда они могут установить FineBI непосредственно на свои компьютеры?
Ответ: Для формальных корпоративных проектов необходимо иметь несколько разработчиков, подключенных к одному проекту, и несколько зрителей, имеющих доступ к одной и той же системе на разных компьютерах.
Поэтому необходимо развернуть проект на сервере, чтобы разные разработчики и зрители могли получить доступ к проекту на своих компьютерных терминалах.
Почему рекомендуется развертывать проекты в промежуточном ПО?
Middleware - это программный слой, который находится между операционной системой и приложением и поддерживает связь и взаимодействие между приложениями.
Чтобы добиться большей доступности и стабильности проекта, FineBI обычно развертывается в промежуточном ПО.
Развертывание в промежуточном ПО может обеспечить следующие преимущества:
- Серверы приложений могут обеспечить лучшую безопасность: серверы приложений могут контролировать и управлять протоколами передачи данных и веб-безопасностью, а также использовать протоколы шифрования, такие как протокол HTTPS, для обеспечения безопасности передачи данных.
- Серверы приложений могут обеспечить более высокую производительность: серверы приложений могут балансировать нагрузку запросов, чтобы обеспечить эффективную работу системы, несмотря на высокую нагрузку.
- Серверы приложений обеспечивают лучшую масштабируемость: использование серверов приложений позволяет легко расширять систему и предоставлять выделенные ресурсы для различных приложений, обеспечивая тем самым стабильность работы приложений.
- Серверы приложений могут обеспечить более высокую доступность: серверы приложений могут обеспечить высокую доступность и механизмы отказоустойчивости, чтобы максимально повысить доступность системы.
Поэтому развертывание FineBI в промежуточном ПО обеспечивает лучшую безопасность, производительность, масштабируемость и доступность, что гарантирует стабильность и высокую доступность.
Как работает серверная техника
Принцип развертывания проектов на сервере заключается в развертывании проектов FineBI на стороне сервера веб-приложений.
- Пользователь формирует запрос на представление на стороне клиента и отправляет его на сторону сервера веб-приложения.
- Сервер веб-приложений передает результаты вычислений FineBI обратно клиенту.
- При вычислении результатов FineBI будет выполнять операции чтения и записи в базу данных.
Кластер против автономного развертывания
Что такое кластеры и автономное развертывание?
Автономное развертывание
Просто хорошо развернутый проект.
Кластеризация
Кластер (cluster) - это несколько одинаковых проектов для предоставления одного и того же сервиса, эти отдельные проекты являются узлом кластера (node).
Основываясь на горизонтальной масштабируемости кластера, пользователи могут увеличивать количество узлов, чтобы параллельность росла линейно, что позволяет добиться высокой производительности поддержки параллельности.
В то же время вы можете создавать резервные копии нескольких проектов, чтобы избежать потерь, связанных с остановкой системы из-за недоступности одной машины (перерыв в работе, потеря данных/шаблонов), и обеспечить стабильную работу системы в течение 7*24 часов.
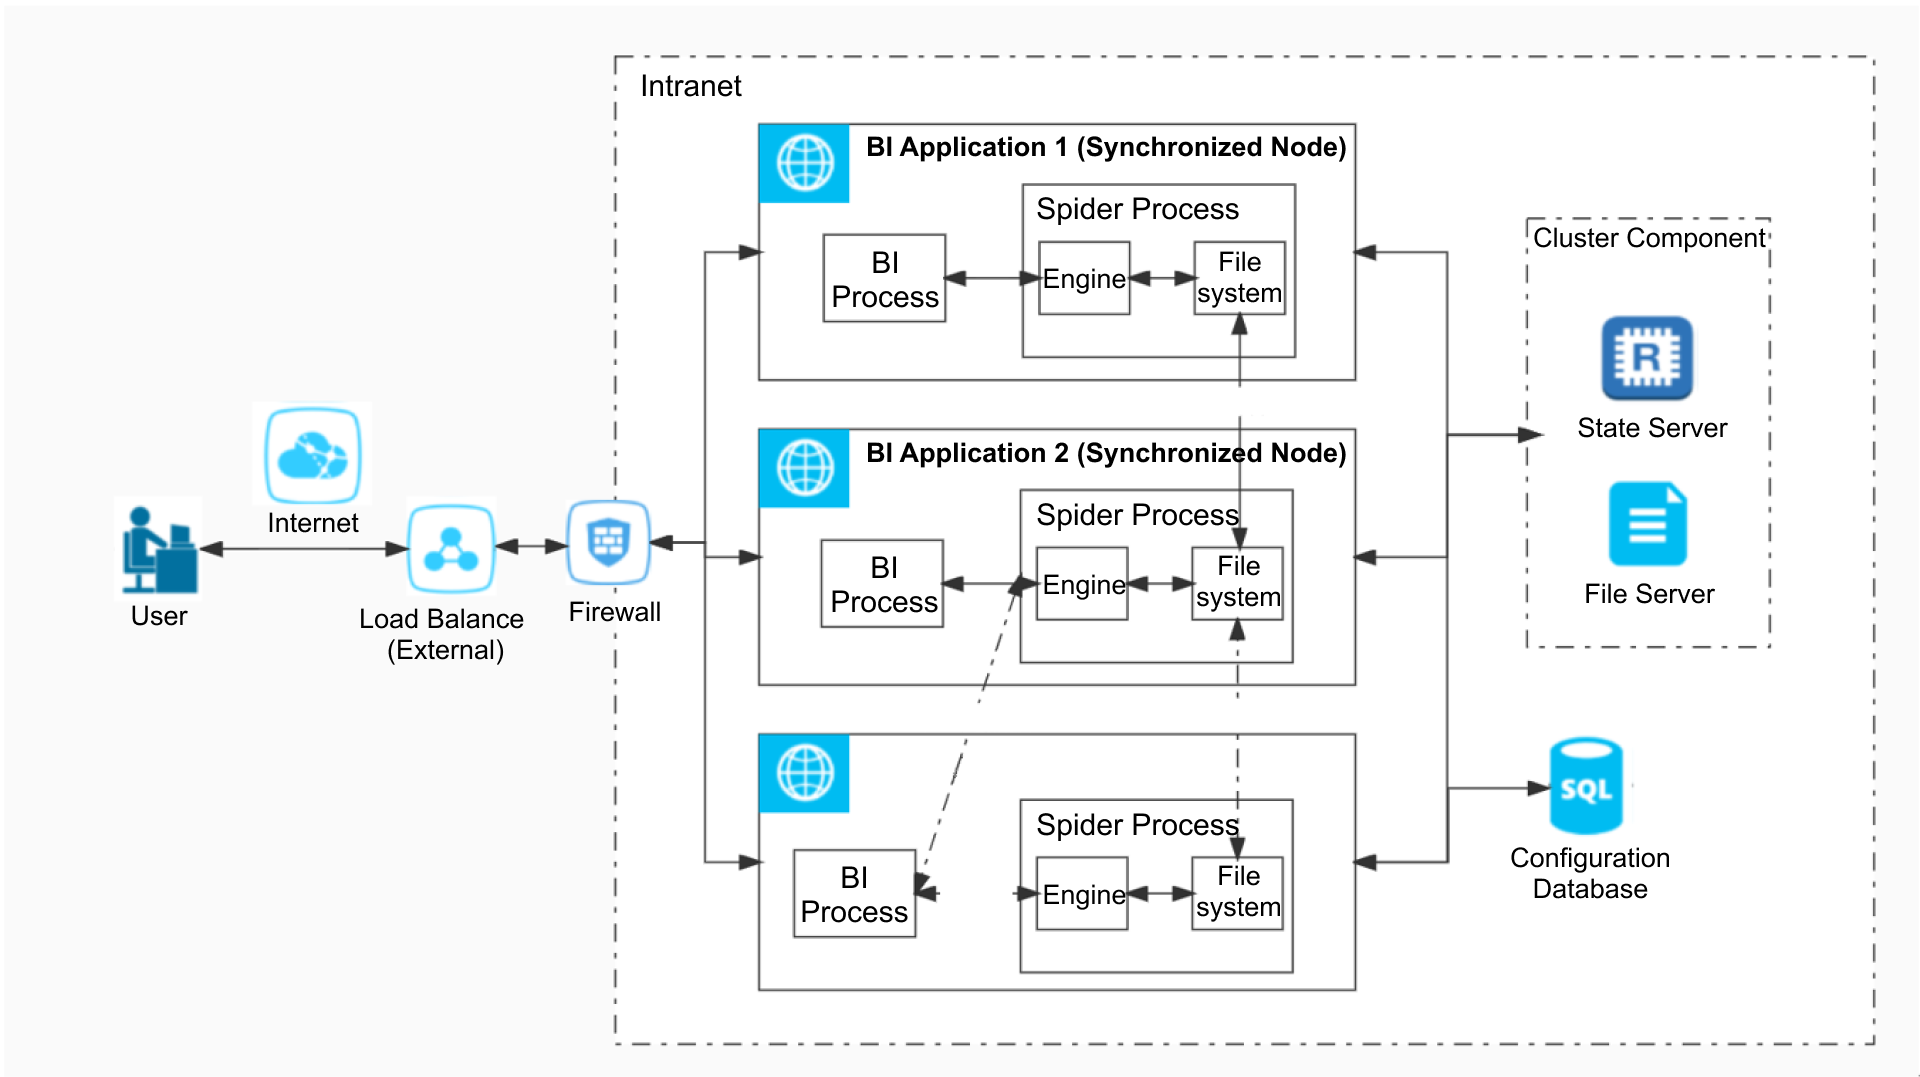
Преимущества кластеризации
Обладая такими преимуществами, как высокая доступность, высокая производительность, простота управления, масштабируемость и безопасность, Cluster подходит для создания и управления отчетами на уровне предприятия и может помочь предприятиям лучше управлять и контролировать производительность и эффект от хранения, создания и обмена данными отчетов.
| Преимущество | Описание |
|---|---|
| Высокая доступность | Кластеризация включает в себя несколько узлов, чтобы разделить нагрузку по обработке запросов с помощью нескольких компонентов, таких как узлы кластера, балансировщики нагрузки, серверы состояний и другие компоненты, работающие вместе.Когда один из узлов кластера выходит из строя, балансировщик нагрузки автоматически перенаправляет запросы на другие доступные узлы, чтобы обеспечить высокую доступность системы. |
| Параллелизм | Кластеризация позволяет параллельно обрабатывать несколько задач по созданию дашбордов и вычислению данных на нескольких узлах, что обеспечивает распределенную обработку задач.Горизонтальное масштабирование кластера позволяет ускорить вычисление данных и создание дашбордов, что повышает общую производительность.Чем больше количество узлов, тем выше поддерживаемый параллелизм. |
| Легко управлять | Cluster предоставляет полную платформу управления, включая мониторинг, настройку, развертывание и автоматическое устранение неисправностей узлов кластера, что позволяет значительно снизить сложность и риск обслуживания и эксплуатации кластера, а также помогает предприятиям лучше управлять и поддерживать свои системы.* Простая визуальная настройка, 80% настроек можно выполнить на платформе. * Поддержка горячего развертывания, добавление и удаление узлов без перезапуска кластера, просто скопируйте файл узла. * Мониторинг в реальном времени состояния работы каждого узла, простоя узла, несоответствия времени между узлами и т.д. может быть своевременно предупрежден. * Информация о конфигурации платформы, изменение и обновление файлов ресурсов могут быть синхронизированы между узлами в режиме реального времени. * В случае несоответствия пакетов JAR на разных узлах сравнение может быть автоматически обнаружено и предупреждено при запуске. |
| Высокая масштабируемость | Основываясь на хорошем архитектурном дизайне, веб-кластер обладает хорошей горизонтальной масштабируемостью. Кластер может быстро увеличивать количество узлов кластера, так что параллелизм имеет тенденцию расти линейно, чтобы справиться с пиковым периодом и колебаниями трафика, так что для достижения масштабируемости и эффективности системы. |
Разница между кластером и автономной системой / Какую проблему решает кластер?
Если сравнить кластеры и автономное развертывание с группой такси, принимающих гостей, то их различия можно объяснить следующим образом:
1) Решение проблем с высокой нагрузкой
Автономная машина похожа на такси, которое принимает заказы от пассажиров, но если количество заказов становится очень большим, то мощности такси могут не выдержать, и возникнет узкое место в производительности.
В этот момент вам нужно несколько такси, чтобы разделить работу по обработке заказов. И эти такси могут быть сформированы в виде таксопарка, называемого кластером.
Это позволит вам распределять пассажиров по разным автомобилям и доставлять их в пункты назначения одновременно, повышая тем самым эффективность вашего сервиса.
2) Решение проблем высокой доступности
Однако простое увеличение количества транспортных средств решает только проблему высоких инженерных нагрузок и не является достаточным для обеспечения высокой доступности.
Вам также нужна хорошая система управления автопарком, чтобы обеспечить бесперебойную работу каждого транспортного средства и одинаковое качество услуг и обслуживания клиентов.
В кластерной схеме это означает, что вам нужно объединить несколько серверов для таких функций, как балансировка нагрузки, базы данных конфигурационной информации, серверы состояния и файловые серверы.
Эти компоненты обеспечивают высокую доступность кластера и стабильное обслуживание.
3) Резюме
Основное отличие кластера от отдельной машины - это общие ресурсы и совместная работа.
Кластеризация, при которой несколько проектов взаимодействуют друг с другом для совместного использования данных и задач, обеспечивает лучшую масштабируемость и более высокую производительность.
В автономной машине все ресурсы используются исключительно, и ни о какой масштабируемости или динамичности не может быть и речи.
В заключение следует отметить, что кластерный дизайн - это эффективное решение для повышения нагрузочной способности и доступности системы, а также обеспечения ее стабильности и согласованности.
Зачем кластерам нужны многоклассовые компоненты?
При создании кластера важно отметить, что это не простая и легкая задача.
Для того чтобы обеспечить бесперебойный и бесшумный сервис, необходимо повысить качество обслуживания и собрать отличный автопарк.
Нам нужно подумать о том, как создать хороший парк транспортных средств, и это то, чем должна заниматься кластерная архитектура.
| Элементы | Пояснения |
|---|---|
| Инженерные узлы | Узел кластера - это такси.Если такси ломается, на его место автоматически подбираются другие, чтобы весь автопарк оставался в рабочем состоянии.В кластере не используется концепция главного узла, а в качестве базового узла используется только первый узел, присоединившийся к кластеру. Каждый узел предоставляет услуги и выполняет операции управления в равной степени.Каждый узел представляет собой проект, который может работать независимо и отвечает за обработку запросов пользователей, выполнение задач по созданию отчетов и управление работой других компонентов. Узлы кластера взаимодействуют и сотрудничают друг с другом с помощью ряда сетевых протоколов и сервисов. |
| Балансировщик нагрузки | Балансировщик нагрузки - это как диспетчерский центр для таксопарка, используемый для координации и распределения всех работ и запросов. При приеме клиентов балансировка нагрузки служит единым порталом, который берет на себя взаимодействие с клиентами, избавляя их от необходимости обращаться к водителям по одному.При кластеризации распределение нагрузки используется для распределения задач между отдельными узлами, чтобы они могли работать более эффективно. Балансировщик нагрузки распределяет нагрузку между всеми узлами, гарантируя, что каждый узел получает достаточно задач и остается занятым. |
| Внешняя база данных | Библиотека конфигурации, внешняя база данных FineDB, - это аналог DMV для таксопарка. Он хранит и поддерживает информацию обо всех транспортных средствах и водителях, предоставляя каждому водителю одинаковые сведения о декоре автомобиля, расценках и маршрутах поездок. Таким образом, каждый автомобиль обеспечивает клиенту одинаковые впечатления от поездки.В кластере хранилище конфигурации используется для хранения и поддержания информации о конфигурации и параметров для всех узлов, которые должны быть установлены соответствующим образом, чтобы узлы кластера работали согласованно. |
| Сервер | Сервер - это как центр управления парком такси.Он отвечает за мониторинг и поддержание общего состояния автопарка, включая местоположение транспортных средств и водителей, а также ход обслуживания.В кластере сервер состояния выполняет аналогичные задачи. Он следит за рабочим состоянием каждого узла и кластера в целом, записывает журналы и сообщения об ошибках, координирует межузловое взаимодействие и распределение задач. |
| Файловый сервер | Файловый сервер похож на хранилище для парка такси.В нем хранятся все документы, связанные с автопарком, включая записи о техническом обслуживании автомобилей, страховые полисы, данные о местонахождении транспортных средств и многое другое.В кластере файловые серверы используются для хранения и совместного использования файловых ресурсов и данных, необходимых в кластере, чтобы каждый узел мог получить к ним доступ и использовать их. |
Архитектура кластера FineBI очень гибкая и может быть настроена в соответствии с различными требованиями и характеристиками бизнеса. Если вы хотите открыть кластер, вы должны соответствовать как минимум следующим условиям:
(1) Существует более 1 инженерного узла
2) Узел сконфигурирован с внешней базой данных
3) Узел сконфигурирован с сервером
4) Если имеется более 2 инженерных узлов, сервер профилей должен быть настроен
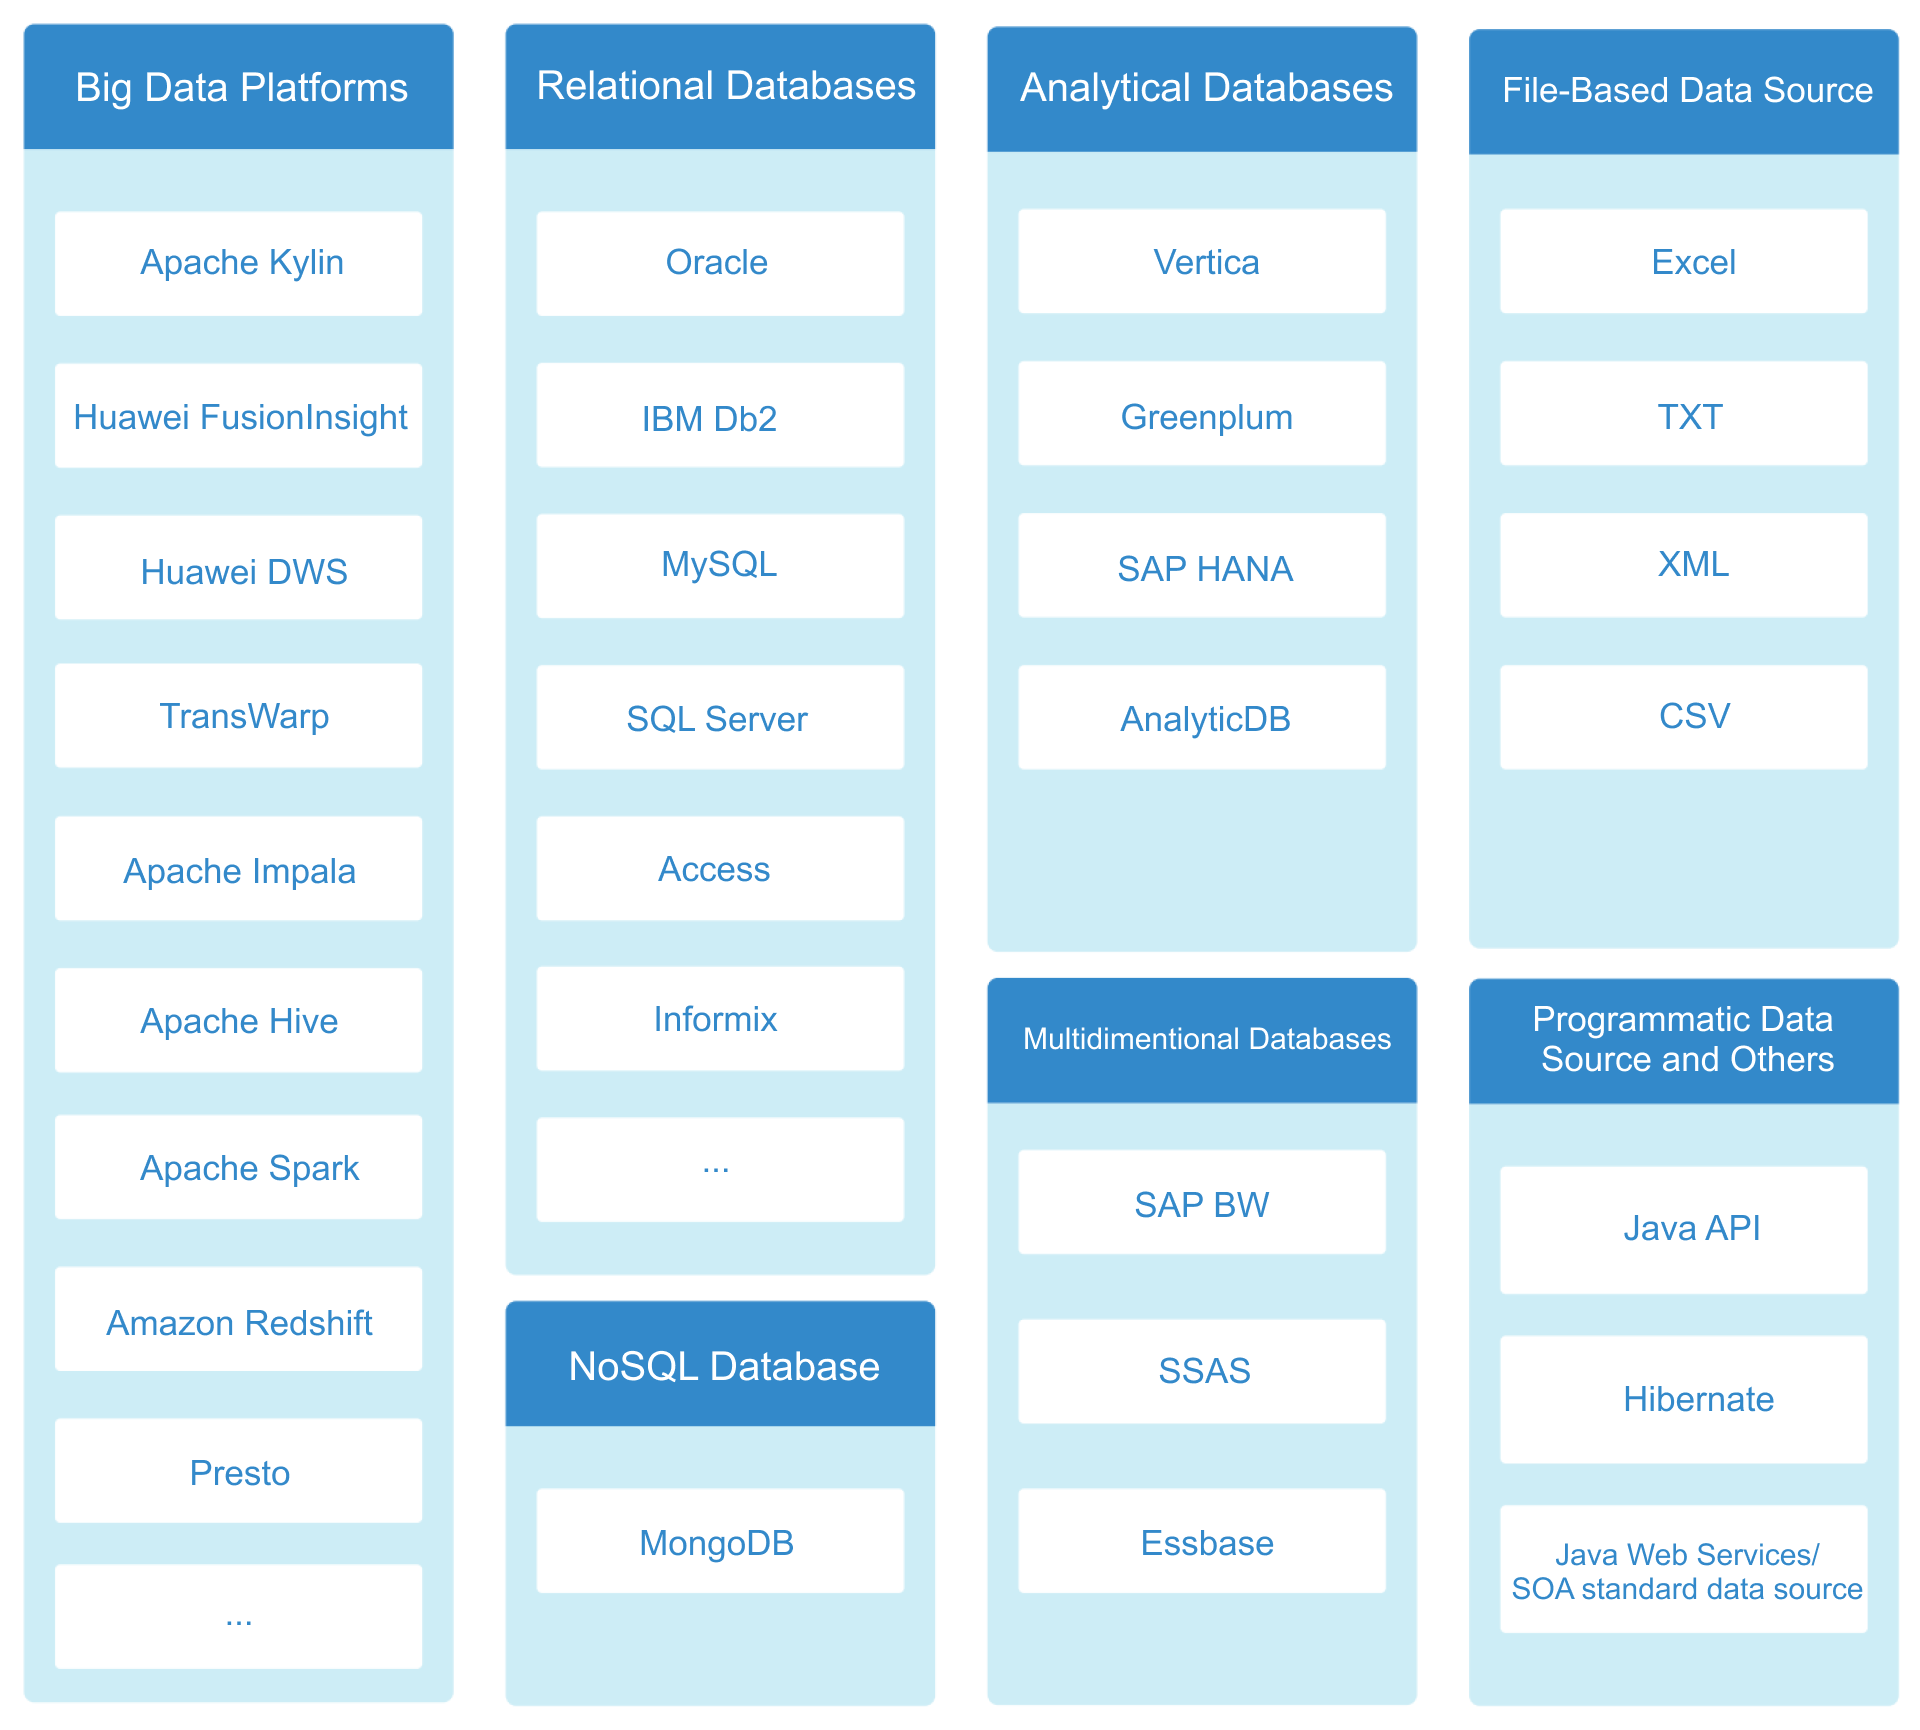
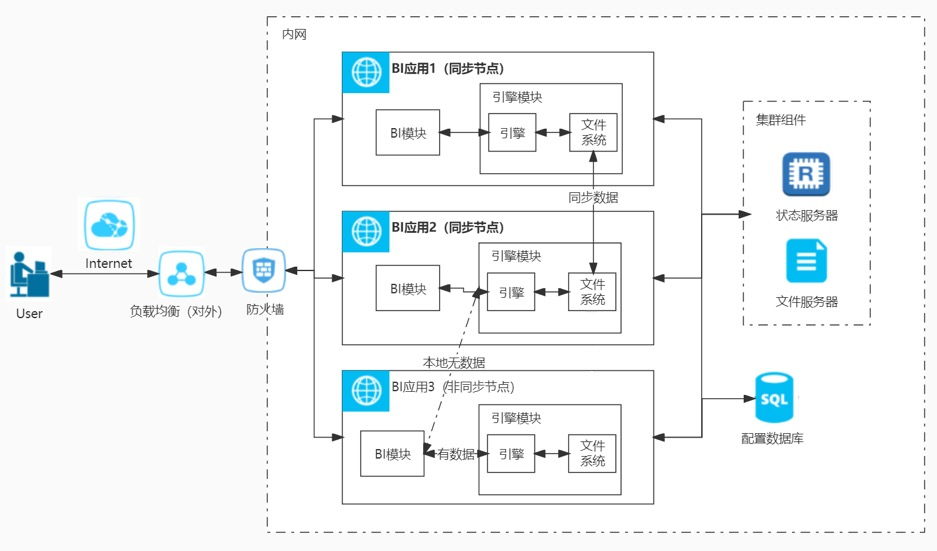
Кластеры Spider в сравнении с кластерами Direct
Что такое Spider кластеры и кластеры Direct?
Кластеры Direct:
- Проекты FineBI используют только напрямую подключенные данные, а не извлеченные.
Spider кластеры:
- Проект FineBI 6.0 с новым кластером развертывания и извлеченными данными, используемыми в проекте.
- FineBI5.x горячий резерв проект обновлен FineBI6.0, горячий резерв отменен после обновления, рекомендуется настроить на извлечение кластера
Преимущества Spider кластеров
1) Высокая доступность бизнеса
Характеристики программы:
Кластер состоит из нескольких синхронных и асинхронных узлов, и пока жив синхронный узел, он может предоставлять полные данные и обеспечивать высокую доступность запросов к данным.
Если во время выполнения обновления данных происходит сбой (простой или ложная смерть узла), текущая задача возвращается в состояние, предшествующее выполнению, и повторно выполняется с помощью механизма восстановления, чтобы обеспечить высокую доступность службы обновления.
Характерная производительность:
По сравнению с горячим резервированием, переключение узлов при выходе из строя узла в кластере извлечения не занимает много времени, что сокращает время недоступности.
Кроме того, кластеры 6.0 поддерживают высокую доступность для операций обновления, обеспечивая механизм восстановления исключений для задач обновления.
2) Высокая параллельность запросов
Характеристики программы:
Несколько узлов одновременно предоставляют услуги запросов, достигается балансировка нагрузки, параллельность запросов увеличивается примерно линейно с ростом числа узлов, и обеспечивается горизонтально масштабируемая возможность запросов.
Характерная производительность:
При извлечении запросов из кластера достигается истинная балансировка нагрузки, а одновременная производительность может увеличиваться линейно с ростом числа узлов.
Схема кластеризации извлечения оптимизирует количество параллельных операций не отдельных узлов, а в целом.
Повышение производительности схемы кластеризации с извлечением снижается при увеличении числа узлов на нецелое число.
Примечание: В следующей таблице приведены шесть сценариев, показывающих производительность запросов при различных узлах и числе параллельных операций. Эти сценарии используются только в качестве тестовых, при реальном развертывании количество узлов не рекомендуется более 5, количество параллельных запросов превышает поддержку 140.
В реальной конфигурации необходимо выбрать оптимальное количество узлов, основываясь на высокочастотных сценариях пользователя (просмотр панели управления/анализ самообслуживания), подробнее см. в разделе: Варианты инженерного развертывания.
| Количество узлов - Параллелизм | Многократное повышение производительности по сравнению с автономной системой |
|---|---|
| Один узел - 10 одновременных | - |
| 4 узла - 40 одновременных | 3.6 |
| 7 узлов - 70 параллельных операций | 6.7 |
| Один узел - 20 одновременных | - |
| 4 узла - 80 параллельных операций | 3.6 |
| 7 узлов - 140 одновременных | 6.1 |
3) Повышение производительности обновления
Характеристики программы:
Производительность обновления может быть улучшена за счет добавления большего количества узлов, а время, затрачиваемое на обновление, нелинейно уменьшается с увеличением количества узлов.
Характерная производительность:
Производительность обновления многотабличной задачи обновления показывает нелинейную тенденцию к увеличению, а затем к уменьшению с увеличением числа узлов (из-за механизма синхронизации данных).
Схема кластеризации с извлечением не оптимизирует производительность обновления и пропускную способность отдельных узлов, а оптимизирует все в целом.
Из-за механизма синхронизации данных производительность обновления одной таблицы на нескольких узлах снижается по сравнению с одним узлом.
Из-за механизма синхронизации данных улучшение производительности глобальных обновлений будет снижено на 4 узлах по сравнению с 3 узлами. Поэтому количество узлов в развертывании не рекомендуется превышать 5 (по сравнению с автономной системой улучшение все еще относительно велико).
Примечание: В реальной конфигурации необходимо выбрать оптимальное количество узлов в зависимости от использования пользователями высокочастотных сценариев (просмотр дашбордов/самостоятельная аналитика), подробнее см. раздел: Выбор сценария развертывания.
| Количество узлов | Процент улучшения производительности глобального обновления по сравнению с автономным развертыванием |
|---|---|
| 1 узел | - |
| 2 узла | 31 процент |
| 3 узла | 39 процентов |
| 4 узла | 37 процентов |
Как работают кластеры экстракции
1) Обновление расписания
- Запросы на обновление данных могут быть сбалансированно направлены всем узлам.
- Все узлы могут предварительно обработать задачу обновления, сохранив информацию о ней в очереди задач.
- Все синхронизированные узлы могут взять на себя подзадачу обновления набора данных и выполнить фактическое извлечение.
- Набор данных будет синхронизирован с другими синхронизированными узлами после завершения извлечения на одном узле, и набор данных будет считаться обновленным только после завершения синхронизации.
2) Синхронизация данных
Синхронизация узлов:
- Состояние файлов данных на узлах этого класса поддерживается в актуальном состоянии, т. е. обеспечивается высокая согласованность данных. В процессе обновления необходимо убедиться, что синхронизация данных на узлах этого класса завершена, прежде чем обновление будет считаться успешным.
- Этот класс узлов необходим для обеспечения высокой доступности и является рабочей лошадкой при высоком параллелизме запросов и обновлений.
Несинхронизированные узлы:
- До версии 6.0.8 этот тип узла поддерживал запросы с высоким параллелизмом. Файл данных на узле может быть не самым последним, через механизм синхронизации, постепенно обновляя данные на узле до того же состояния, что и на синхронном узле.
- В версиях 6.0.8 и более поздних этот тип узлов поддерживает пересылку запросов. Эти узлы работают как узлы запросов, которые не используют функциональность движка, не хранят извлеченные данные локально и выполняют только пересылку запросов.
3) Пересылка запросов
- Запросы на получение данных могут быть сбалансированно направлены всем узлам;
- Если статус данных узла, возвращаемых библиотекой конфигурации, является актуальным, запрос обрабатывается этим узлом;
- В версияхдо6.0.8, если узел отстает по данным, BI внутренне пересылает запрос на узел с последними данными и запускает синхронизацию данных на этом узле.
- В версиях6.0.8 иболее поздних все запросы направляются на узел с самыми свежими данными, и нет необходимости обновлять данные на несинхронизированных узлах.
Контейнерное развертывание в сравнении с традиционным
Что такое контейнерное и традиционное развертывание?
Традиционное развертывание:
Пользователи могут подготовиться самостоятельно или воспользоваться пакетом развертывания, упакованным FanRuan для создания наиболее распространенной структуры проекта, т.е. "проект FineBI + среда jdk + промежуточное ПО tomcat".
Контейнерное развертывание:
Процесс "контейнеризации" приложения заключается в том, что оно запускается в контейнере Docker или аналогичной технологии, в котором заключено окружение операционной системы и приложение (полный образ системы).
Это основа для того, чтобы архитектура приложения оставалась "облачной".
Преимущества контейнерного развертывания
Контейнерные развертывания позволяют значительно сократить расходы клиентов на обслуживание и ресурсы по сравнению с традиционными архитектурами развертывания.
1) Низкие эксплуатационные расходы
- Среды каждого проекта изолированы друг от друга, с небольшой зоной влияния в случае аномалии.
- Простота обновления, аварийного восстановления и отката.
2) Низкая стоимость ресурсов
- Управление несколькими кластерами, многопользовательские услуги, микросервисы, более высокая степень использования ресурсов.
- Масштабирование эластичности ресурсов.
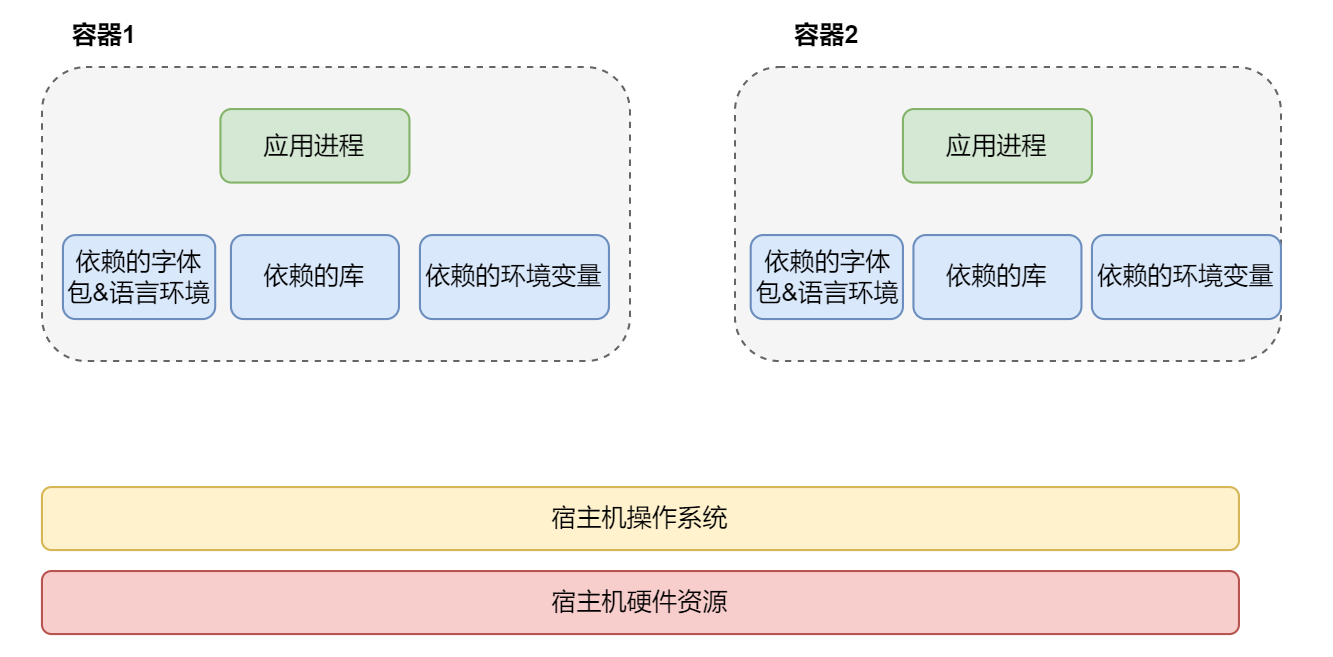
Различия между контейнерным и традиционным развертыванием
Контейнеры обеспечивают следующие преимущества на протяжении всего жизненного цикла приложения: изоляция, переносимость, гибкость, масштабируемость и управляемость.
Самое важное преимущество заключается в том, что он обеспечивает изоляцию между разработкой и операциями.
| Требования | Традиционное развертывание | Развертывание в контейнерах |
|---|---|---|
| Начальная конфигурация JVM | Вам нужно вручную изменить конфигурационный файл Tomcat или соответствующий конфигурационный файл других контейнеров.Большинство пользователей могут быть настроены не полностью, что приводит к последующим аномалиям в работе предприятия | По умолчанию все часто используемые параметры jvm были настроены в образе, чтобы избежать проблем, вызванных большинством параметров jvmОграничение памяти Xmx может быть настроено отдельно в yaml-файле |
| Балансировка нагрузки | Требуется отдельная установка Nginx или другого программного обеспечения для загрузки с настройкой переадресацииЕсть пользователи, у которых может отсутствовать множество конфигураций, что приводит к аномалиям в некоторых операцияхВы можете настроить архитектуру высокой доступности keepalived+nginx по своему усмотрению. | При развертывании одним щелчком мыши по умолчанию автоматически устанавливается и настраивается nginx (другие загрузки не поддерживаются).Избегайте проблем, вызванных неправильной или отсутствующей конфигурацией, созданной самими клиентами |
| Требования к оборудованию | Рекомендуется, но не обязательно | Обязательный минимум 500 Гб дискового пространства и 16 Гб оперативной памяти для всех узлов.Предотвращает развертывание проектов в неподходящих аппаратных средах, что может привести к скрытым проблемам |
| Требования к компонентам | Никаких ограничений, все компоненты, поддерживаемые продуктом, могут быть настроены. | Без ограничений, можно настроить все компоненты, поддерживаемые продуктомОдновременная поддержка развертывания mysql, redis и minio |
| Требования к операционной системе | В основном неограниченно | Системы Linux, поддерживающие архитектуру amd64Centos 7.3 и ниже не поддерживаются.Не поддерживается ubuntu18 и нижеПредотвращение проблем с работой проекта из-за низких версий операционной системы |
| Требования к брандмауэру | Вам нужно открыть порты, используемые соответствующими серверами. | Порты, используемые всеми компонентами на всех узлах, должны быть открыты, иначе их нельзя будет развернутьОбеспечьте, чтобы проект не работал с перебоями из-за проблем с портом |
| Автономное развертывание | Не настраивая внешние библиотеки и другие компоненты, загрузите пакет развертывания и запустите его напрямую!В противном случае вам придется отдельно настраивать внешние библиотеки и компоненты, а также необходимое окружение, например, jdk. | Пользователи с локальным корнем могут развертывать систему одним щелчком мыши. Поддержка развертывания после настройки соответствующей информации об узлах и компонентах в yaml-файле. Поддержка настройки оригинальных компонентов пользователя через yaml-файл. |
| Права доступа | Необходимость защиты прав доступа к файлам | Обычным пользователям нужны привилегии sudo (не обязательно, если docker уже установлен и пользователь входит в группу пользователей docker).cptarrmgroupaddgpasswdгруппыдокердsystemctl (требуется для самозапуска службы docker, не является обязательным) |
| Изменения конфигурации веб-контейнера | Перезапустите tomcat после изменения конфигурационных файлов в каталоге tomcat. | Модификации фронтальной части могут быть реализованы через платформу O&M |
| Изменение параметров jvm | Измените соответствующий файл напрямую | Модификации фронтальной части могут быть реализованы через платформу O&M |
| воздействие на окружающую среду | На использование влияют различные среды, такие как: jdk, glibc, системные шрифты, системный язык, системное время и т.д. Это может вызвать определенные проблемы в работе. | Все приложения FR/BI развертываются с помощью контейнеров docker, что позволяет создать единую среду и практически не влияет на окружающую среду, пока развертывание может поддерживаться |