Оформление
Методология анализа требований - модель KANO
1. Обзор
1.1 История вопроса
Ли Лей студентов в качестве продукта, часто сталкиваются с очень большим количеством требований продукта, развитие студентов занят занят, пользователь, кажется, хотят все. Ресурсы на разработку продукта ограничены, как мы можем выловить реальные потребности пользователей? Отдать высокий приоритет действительно важным потребностям?
Ли Лэй решил внедрить "модель KANO" для систематического объединения требований, анализа и уточнения требований с целью повышения эффективности.
1.2 Аналитический процесс
Модель KANO: полезный инструмент для классификации и приоритизации пользовательских требований, основанный на анализе влияния пользовательских требований на удовлетворенность пользователей, отражающий нелинейную связь между производительностью продукта и удовлетворенностью пользователей.
Ли Лей провел исследование около 100 пользователей и, используя модель KANO, построил диаграмму из четырех квадрантов, как показано ниже:
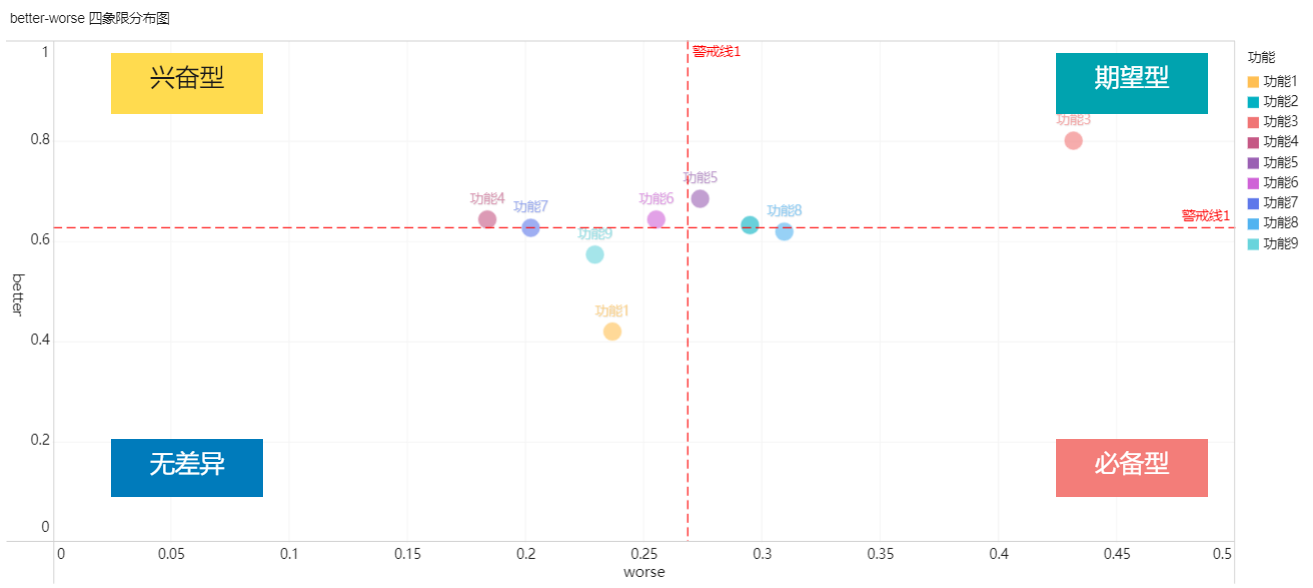
Четыре квадранта соответствуют четырем типам потребностей, которые распределяются по приоритетам следующим образом: необходимые > желаемые > возбуждающие > недифференцированные.
- Насущные потребности (must-have): т.е. часто называемые болевыми точками. Для пользователей эти потребности должны быть удовлетворены в обязательном порядке. Когда эти потребности не удовлетворяются, удовлетворенность пользователей значительно снижается. Это основные требования и обязательные функции продукта.
- Ожидаемый спрос (должен быть): когда этот спрос обеспечивается, удовлетворенность пользователей возрастает; когда он не обеспечивается, удовлетворенность пользователей снижается. Обычно используется в качестве фокуса для сравнения конкурирующих продуктов.
- Требования, основанные на волнении (могут быть): неожиданные функции продукта, которые превосходят ожидания пользователей и, как правило, приводят к повышению лояльности. Их непредоставление не снижает удовлетворенность пользователей.
- Недифференцирующие требования (могут отсутствовать): требования, которые просто не волнуют пользователей и не оказывают никакого влияния на пользовательский опыт. Старайтесь избегать такого типа требований.
1.3 Анализ результатов
Ли Лей поделился созданной им панелью с коллегами и решил добавить "Функцию 2, Функцию 3, Функцию 5, Функцию 8" для этого обновления функций. Благодаря поддержке данных все согласились с его решением, а редкая ситуация, когда в прошлом не было споров о том, какую функцию добавить, повысила эффективность работы.
1.4 Получение приборной панели
Ссылка на онлайн-превью приборной панели: шаблоны KANO, которые вы можете сохранить, чтобы ознакомиться с шагами внутреннего редактирования или потренироваться самостоятельно.
2. Способы реализации
2.1 Разработка анкеты для исследования
Каждая функция в анкете KANO должна содержать как прямые, так и обратные вопросы, например:
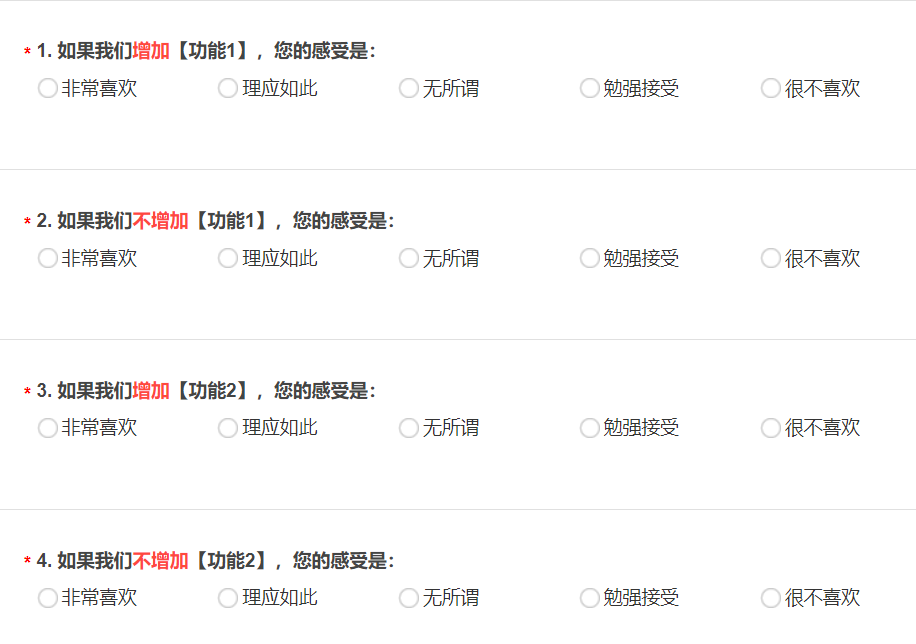
Данные были очищены после проведения исследования, и в данном случае очищенные данные были загружены: kano raw data.xlsx
2.2 Обработка данных
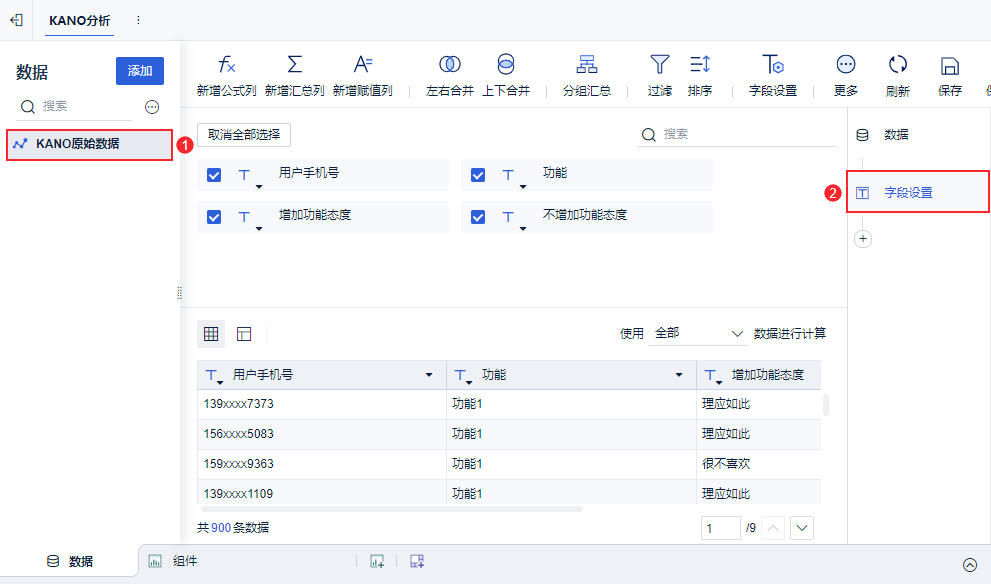
1) Создайте тему анализа "KANO Analysis", добавьте "KANO Raw Data" и нажмите "Field Settings", чтобы отметить все поля, как показано на рисунке ниже:
(2) Добавьте новый столбец формул, "Merge Attitude", чтобы объединить "Add Function Attitude" с "No Function Attitude", как показано на следующем рисунке:
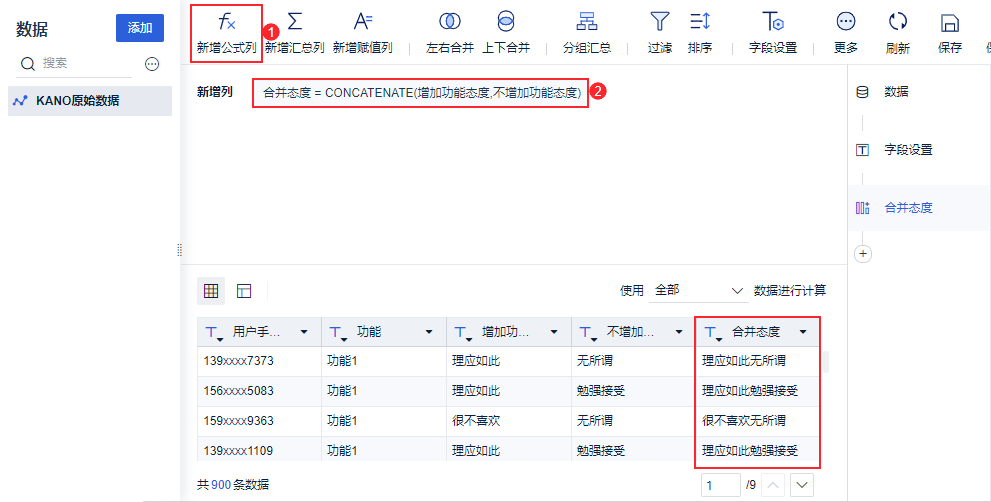
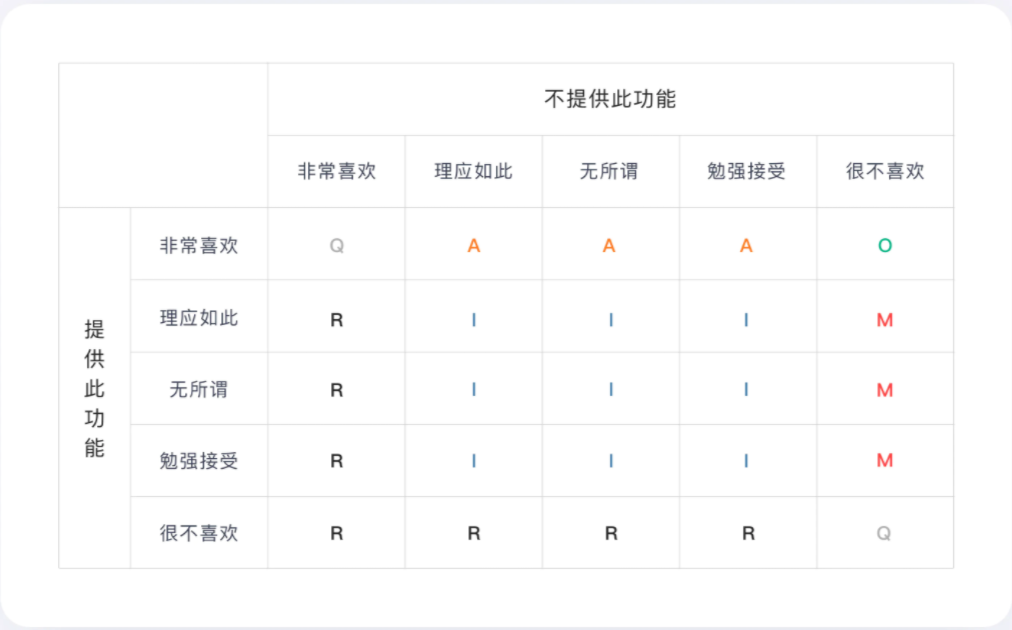
В соответствии с отношением пользователей к "добавлению функций" и "не добавлению функций", мы можем определить, какие именно функции необходимы пользователям, с помощью следующей таблицы.
М: базовые (основные) потребности; О: потребности в ожидании (желании); А: потребности в возбуждении (гламуре)
I: недифференцированный спрос; R: обратный (инверсный) спрос; Q: сомнительные результаты
3) На предыдущем шаге мы уже знаем, как найти тип требования, теперь нужно найти суждение в таблице анализа и добавить колонку типа, как показано ниже:
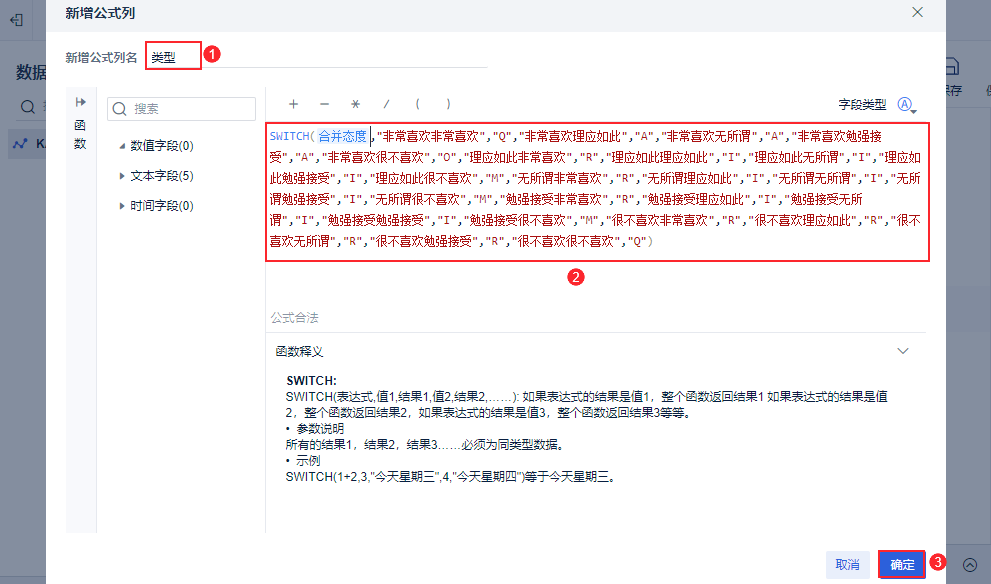
Поскольку формула очень длинная, пользователь может скопировать следующее непосредственно в столбец формул и заменить "отношение слияния" на свое собственное поле, используя функцию переключателя:
SWITCH (комбинированные установки, "очень нравится, очень нравится", "Q", "очень нравится, как должно быть", "A", "очень нравится, все равно", "A", "очень нравится, принимаю неохотно ", "А", "очень нравится очень мало", "О", "заслуженно так очень нравится", "Р", "заслуженно так заслуженно", "И", & quot;заслуженно так равнодушен", "И", "заслуженно так неохотно принимаю", "И", "заслуженно так очень не нравится", "М", "равнодушно очень нравится", "Р ", "мне все равно, что оно заслуживает", "И", "мне все равно, что оно неважно", "И", "мне все равно, что оно принимает неохотно", "И", "мне все равно, что оно очень не нравится",& quot;М", "Неохотно принимает очень", "Р", "Неохотно принимает как должно", "И", "Неохотно принимает неважно", "И", "Неохотно принимает едва ли. Принял", "И", "Едва принял Очень не понравилось", "М", "Очень не понравилось Очень понравилось", "Р", "Очень не понравилось Заслуженно", "Р", & quot;Очень не понравилось не имеет значения", "Р", "Очень не понравилось принимает с неохотой", "Р", "Очень не понравилось очень сильно", "Q")
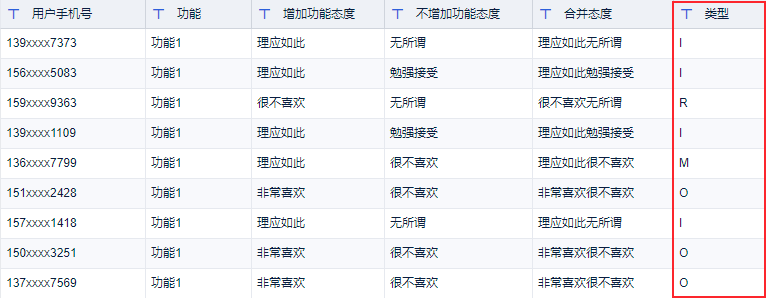
Эффект показан ниже:
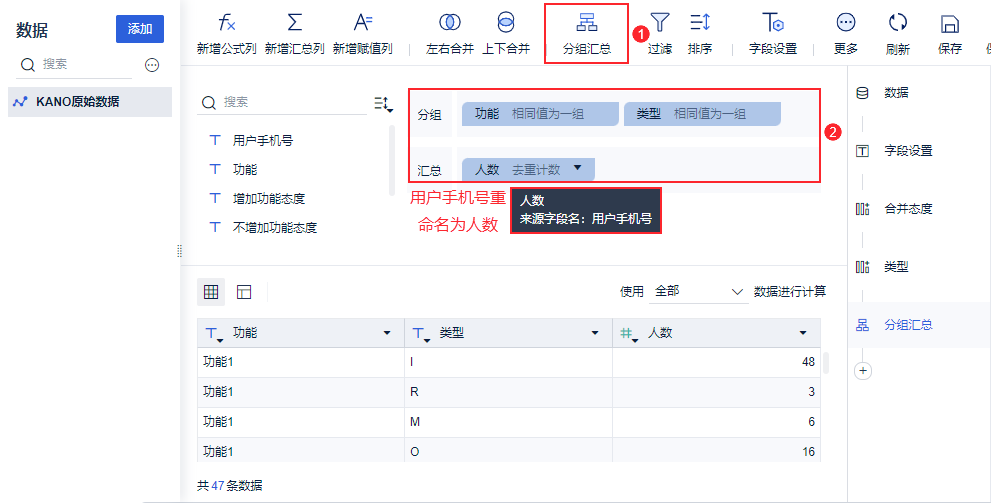
4) Добавьте "Сводку по группам", чтобы получить количество людей по каждой из функций с различными типами спроса, как показано ниже:
Например, 48 участников считали, что "Функция 1" - это недифференцированная потребность.
5) Поскольку некоторые пользователи пропускают вопросы в процессе исследования, количество людей, принявших участие в исследовании, для каждой функции различно. Добавьте новый столбец "Количество участников", как показано ниже, чтобы узнать количество участников для каждой функции.
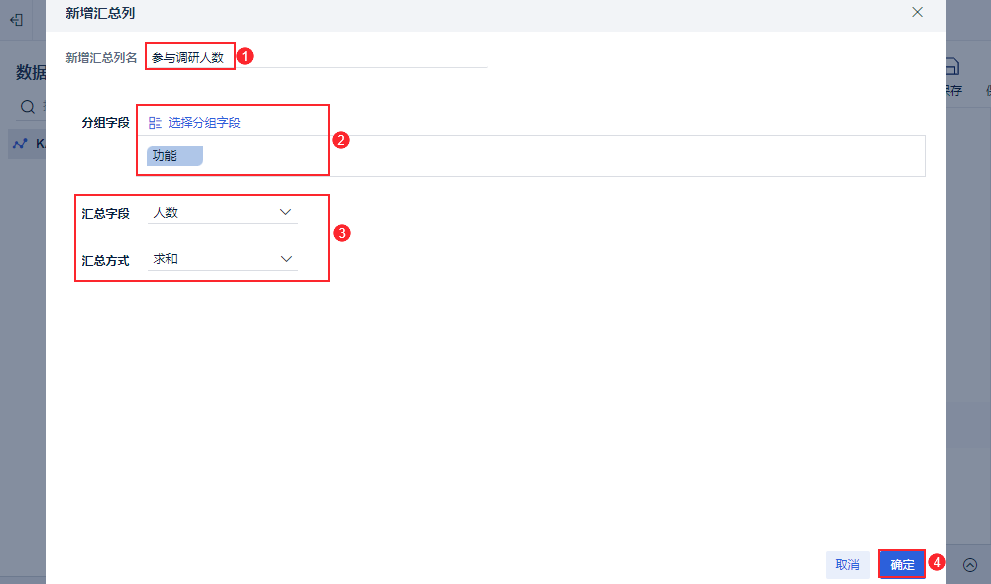
6) Рассчитайте процент, чтобы найти долю от числа участников исследования для каждого типа спроса.
Например, процент "людей первого типа" в "Функции 1" от числа участников "Функции 1" составляет 0,48, как показано на рисунке ниже:
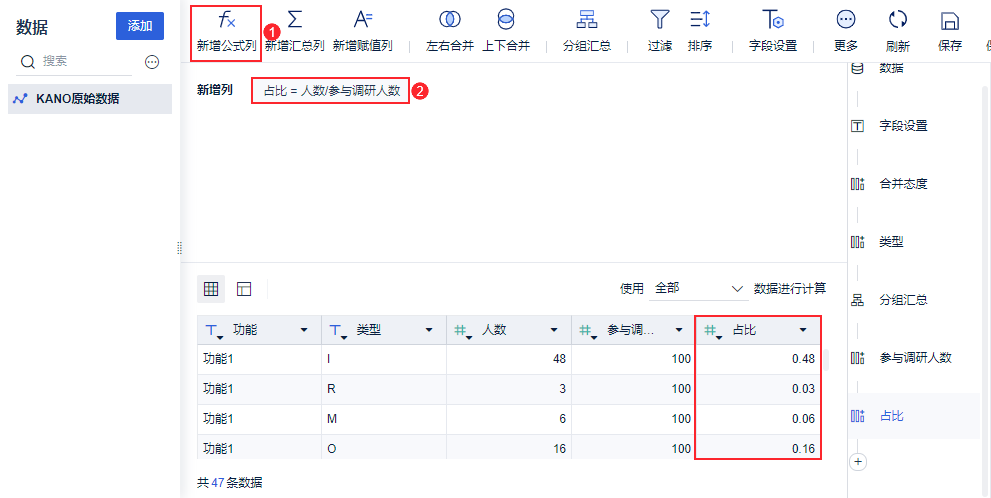
2.3 Производство компонентов
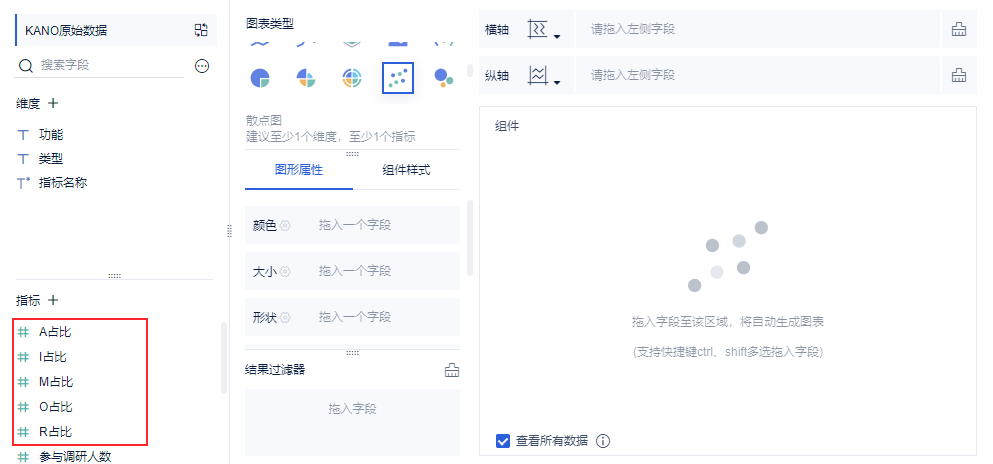
1) Скопируйте 5 полей "Процент", как показано ниже:
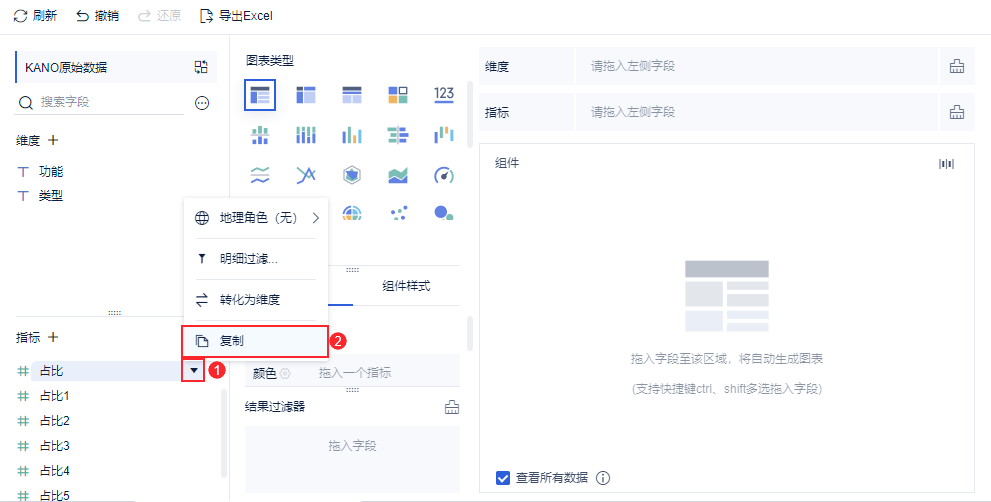
2) Выполните детальную фильтрацию на реплицированном поле "Процент от" с условием фильтрации, что тип принадлежит A. И переименуйте его в "A Percentage". Как показано на рисунке ниже:
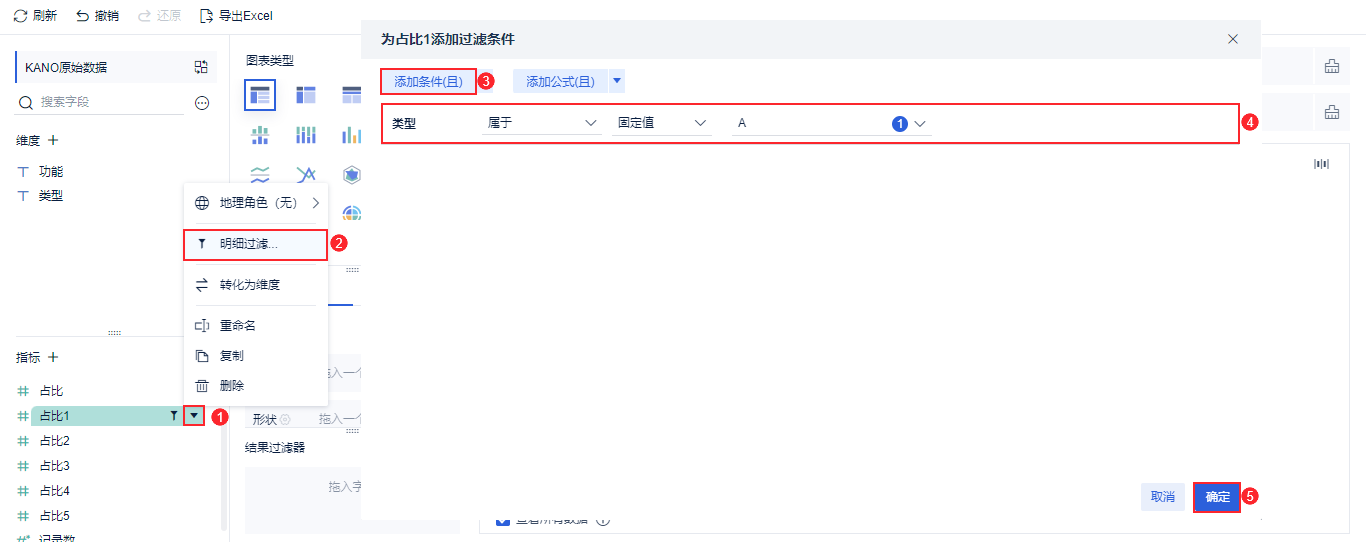
Таким же образом подробно фильтруется поле "Процент от" других реплик, а типы фильтруются отдельно и переименовываются, как показано на следующем рисунке:
3) Используйте коэффициент "лучше-хуже", как показано ниже:
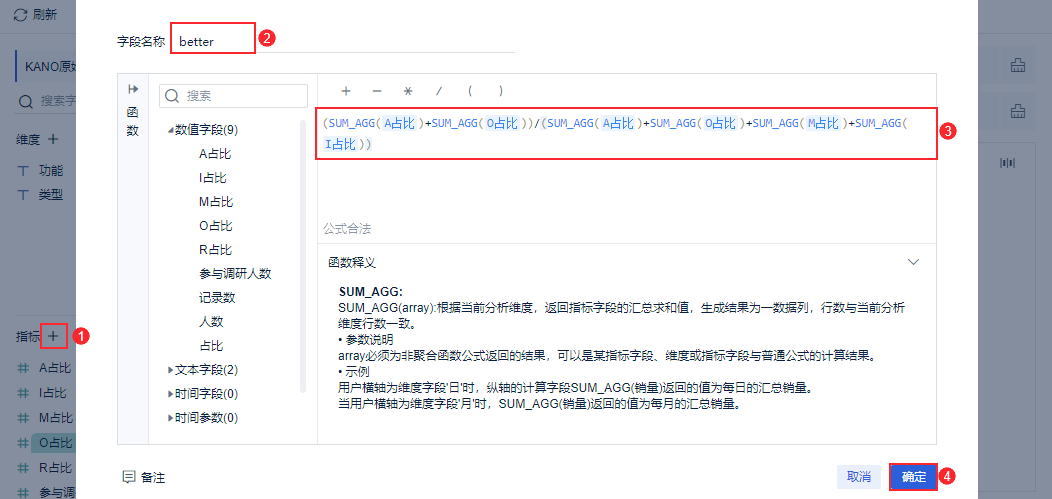
- better - коэффициент удовлетворенности после добавления определенной функции: better = (A share + O share) / (A share + O share + M share + I share), чем ближе к 1, значит, эффект удовлетворенности пользователей будет усиливаться тем сильнее, чем быстрее растет удовлетворенность.
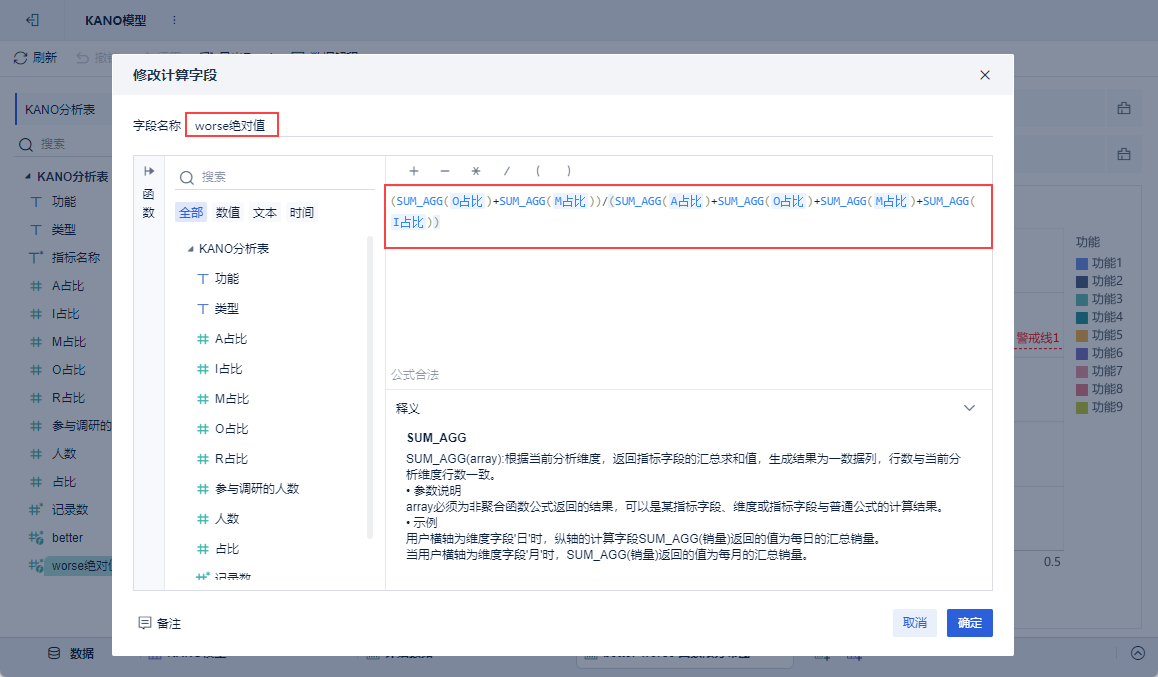
- Коэффициент неудовлетворенности пользователей функцией без ее добавления: wors=-1*(O share+M share)/(A share+O share+M share+I share), чем ближе к -1, тем сильнее влияние на неудовлетворенность пользователя, и тем быстрее падает удовлетворенность.
В соответствии с приведенной выше формулой лучшего и худшего создайте новое вычислительное поле "лучшее" и "абсолютное значение худшего" (абсолютное значение худшего не нужно умножать на -1), как показано на рисунке ниже:
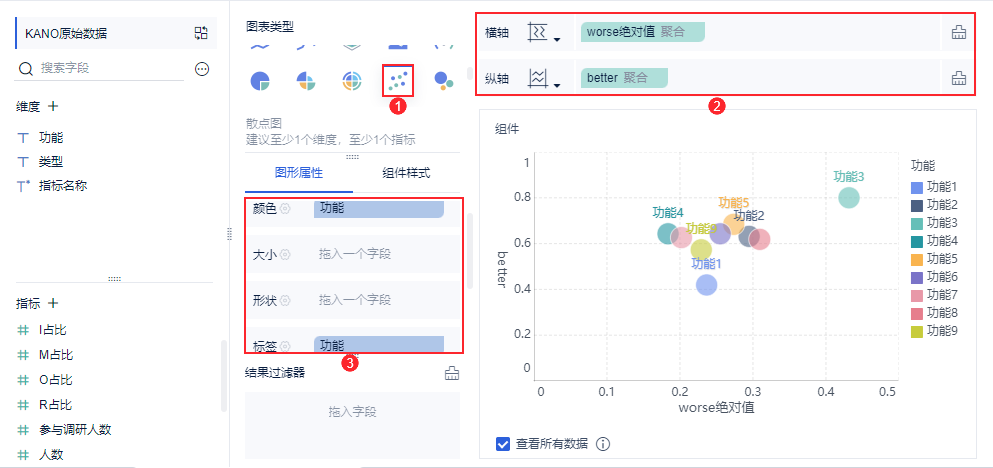
4) Выберите "Scatterplot", перетащите поля "лучшее" и "худшее абсолютное значение". И перетащите поле "Функция" в столбец "Метка" и столбец "Цвет" в свойствах графика. Как показано на следующем рисунке:
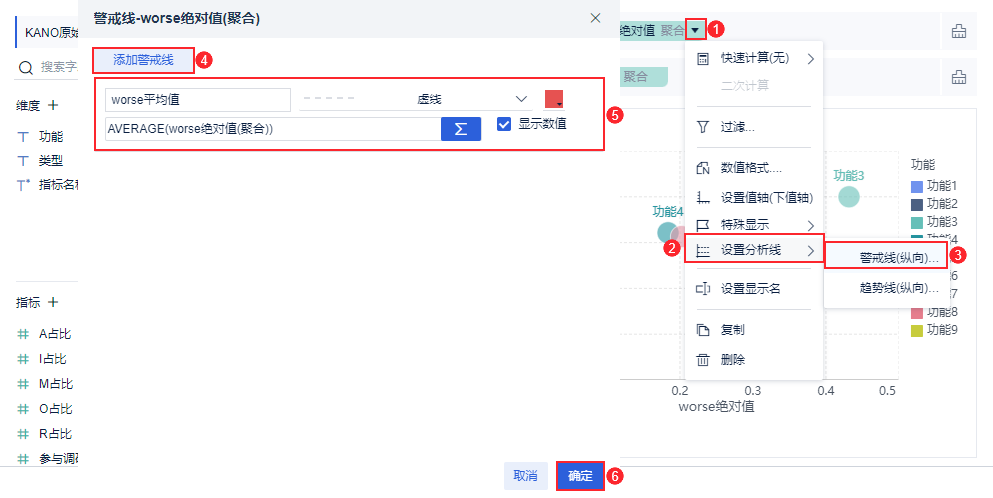
5) Добавьте "Горизонтальный кордон" и "Вертикальный кордон" как лучшее среднее и худшее среднее соответственно. Как показано на рисунке ниже:
2.4 Отображение эффектов
Как показано в разделе 1.2.