Оформление
Анализ линии крови - Помощь FineReport | Разработка отчетов | Использование отчетов | Учебные пособия
анализ родословной
1. Обзор
1.1 Версия
| выпускает | Функциональные изменения |
|---|---|
| 6.0 | - |
| 6.0.12 | * Анализ родословной теперь показывает иерархию родословных |
1.2 Сценарии применения
Человеческая генеалогия, записывает родственные связи между людьми; анализ родословной FineBI, записывает родственные связи между листами данных, компонентами.
Допустим, у нас есть таблица данных 'Store Sales Data Analysis', в анализе линии мы можем увидеть, откуда взялась таблица (какие родительские таблицы) и какие продукты были созданы с помощью этой таблицы (субресурсы: включая подтаблицы, компоненты, панели и т. д.).
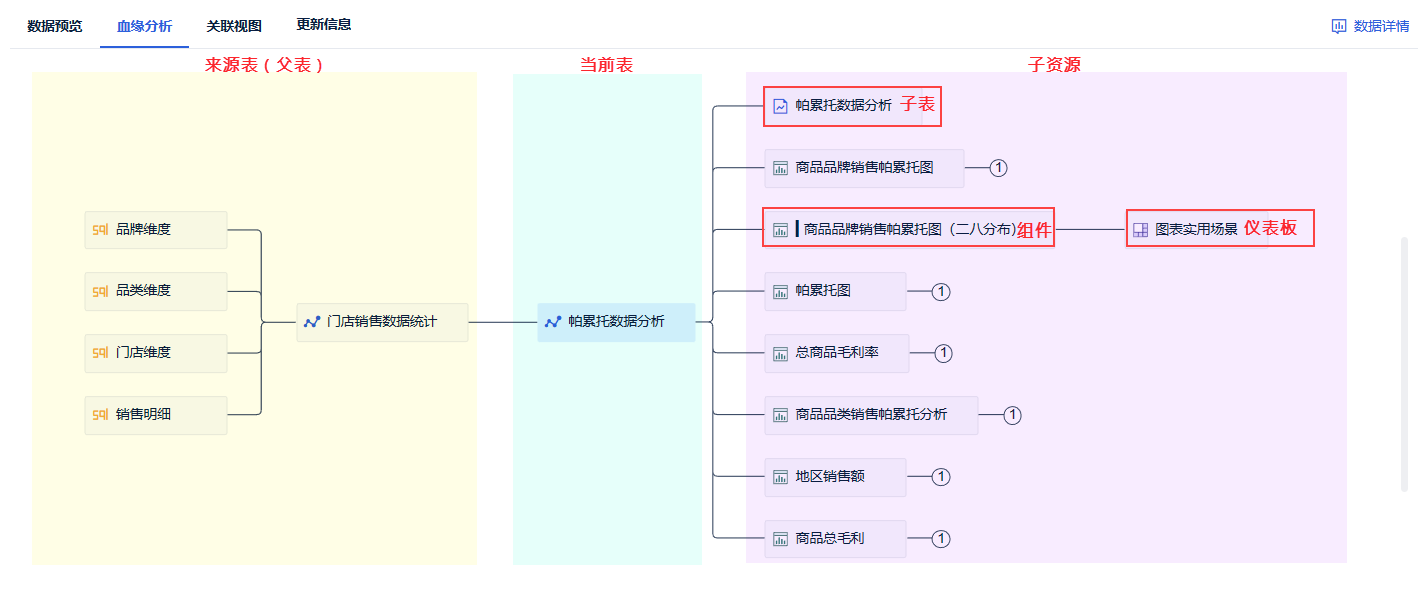
В этом может помочь анализ линии крови:
- Отслеживаемость источника данных: отслеживание исходной таблицы текущей таблицы позволяет нам легко определить точность и достоверность данных.
- Устранение неполадок: при возникновении проблем с качеством, аномальных результатов анализа или ошибок обновления в текущей таблице пользователи могут отследить источник и обновление данных, найти первопричину проблемы и принять соответствующие меры по ее устранению с помощью анализа кровеносной системы.
- Проверьте диапазон влияния текущей таблицы: если у текущей таблицы много подресурсов, значит, она имеет большое влияние. Нужно быть осторожным при изменении или удалении текущей таблицы.
1.3 Функциональный профиль
- Просмотр влияния На экране Lineage Analysis можно просмотреть исходную таблицу для этой таблицы данных, а также таблицы-потомки, компоненты и приборные панели, которые были созданы с ее помощью;
- Пользователи могут перейти непосредственно к таблицам данных и информационным панелям, нажав на соответствующую таблицу данных или информационную панель на странице "Анализ линии крови";
2. Знакомство с функцией анализа родословной
2.1 Просмотр анализа родословной
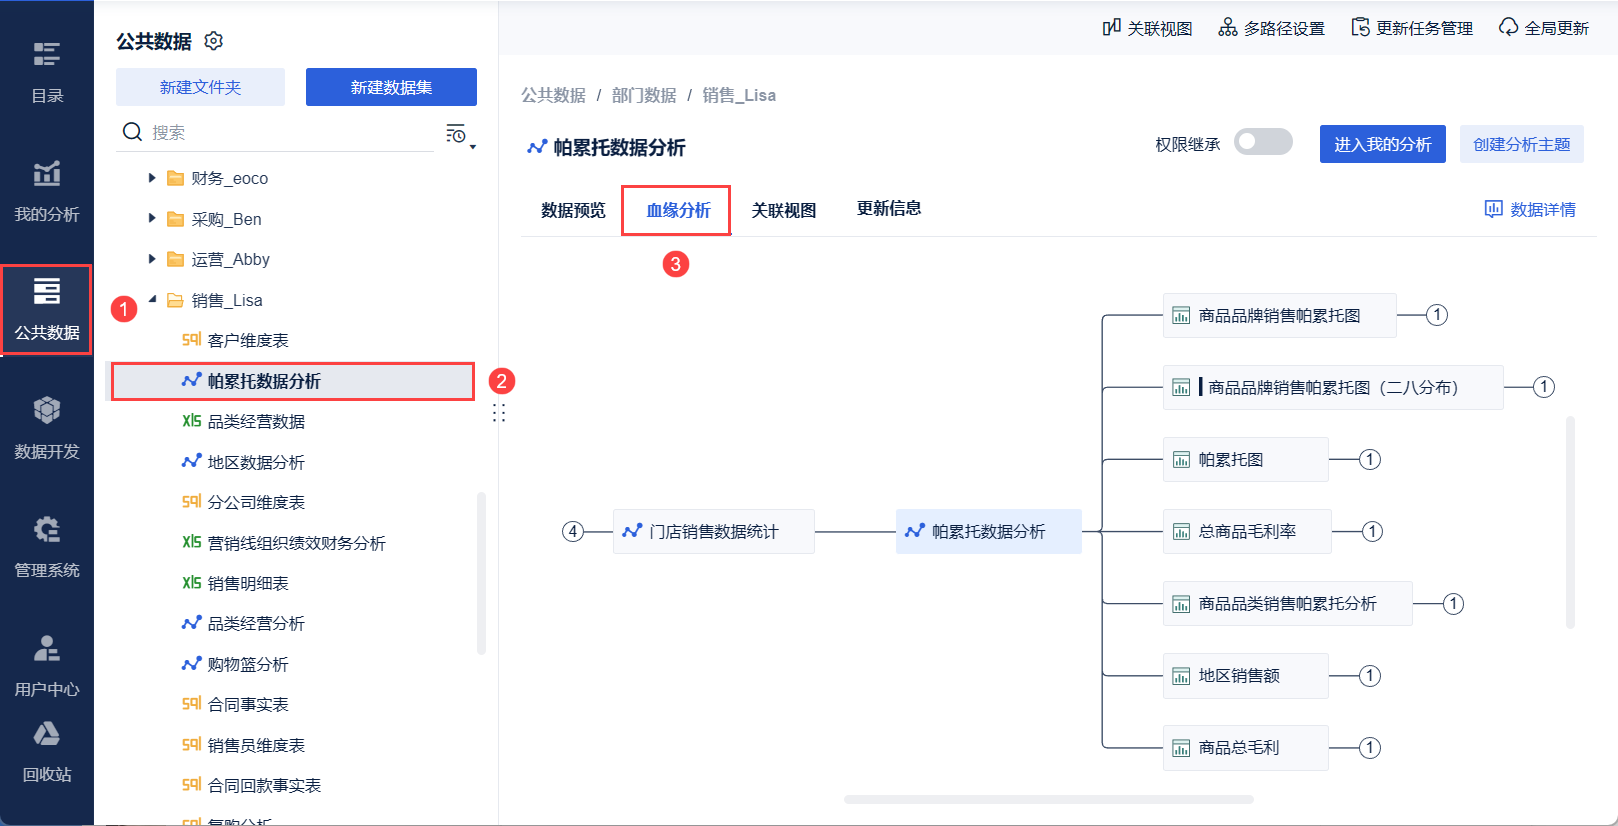
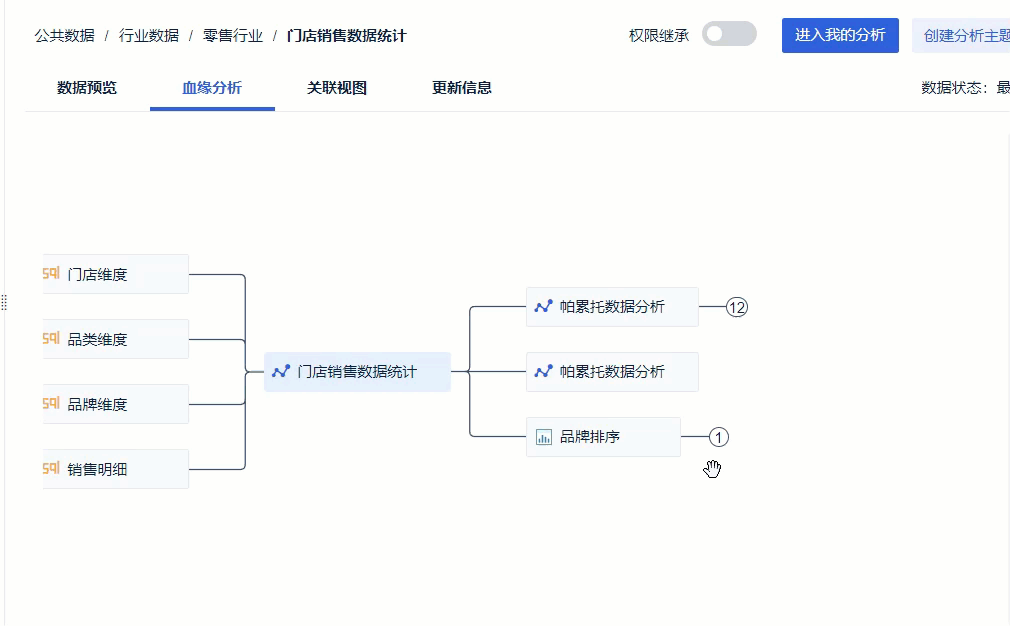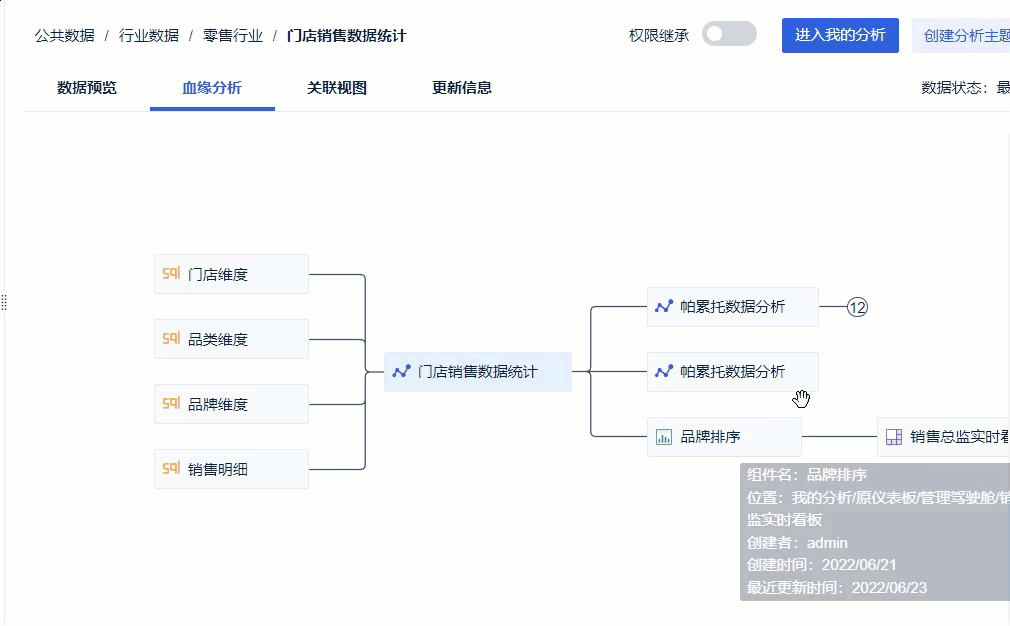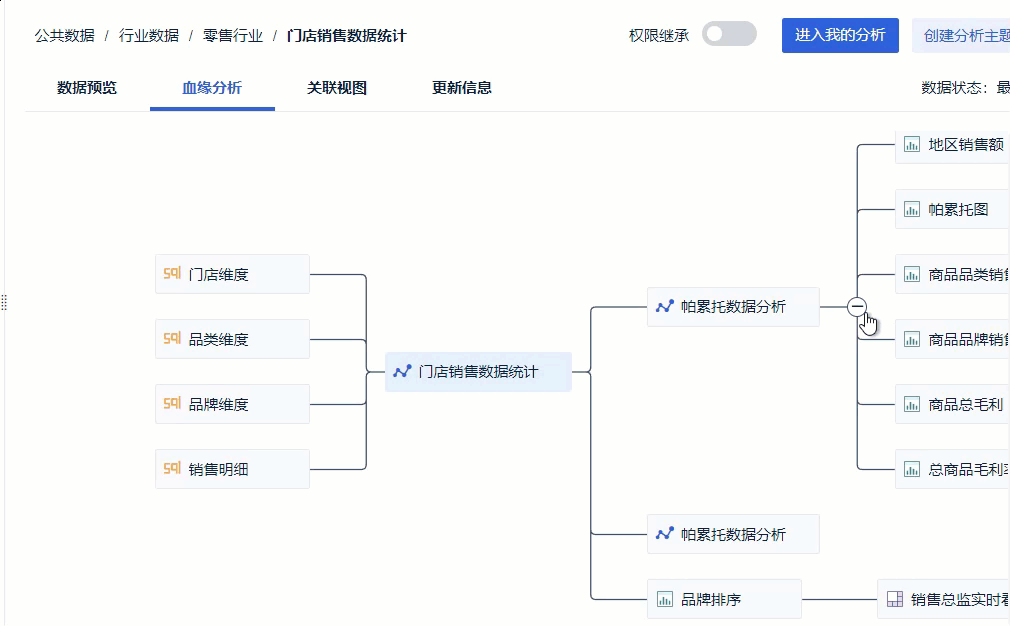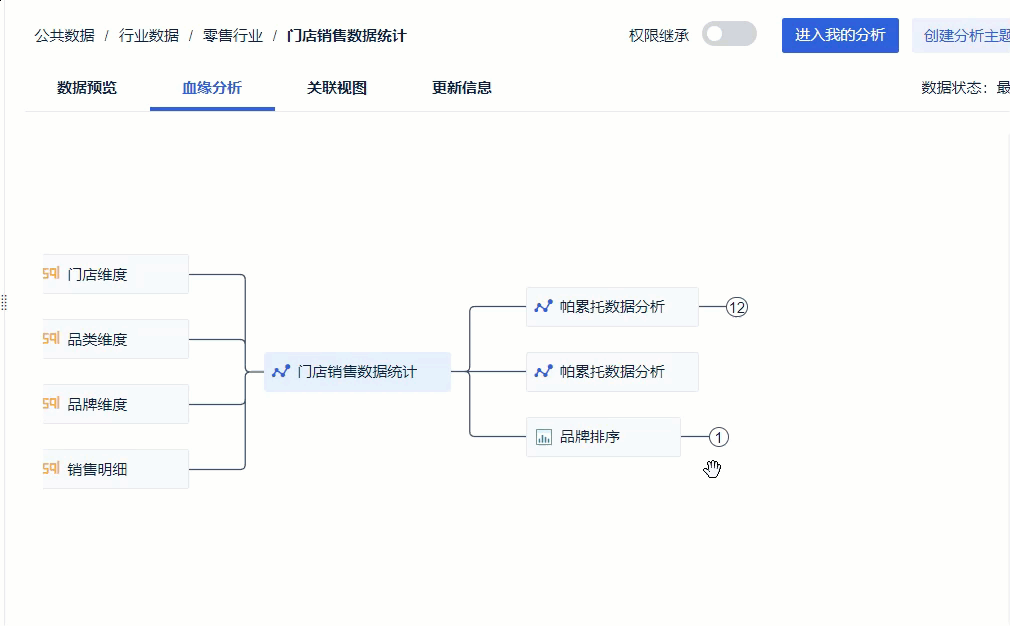
Нажмите на "Public Data", выберите таблицу данных, которую нужно просмотреть, и нажмите на "Bloodline Analysis". Как показано на рисунке ниже:
Если вы хотите узнать "создателя, местоположение, время обновления и т.д.", пользователи могут навести курсор мыши на соответствующую вкладку. Как показано на рисунке ниже:
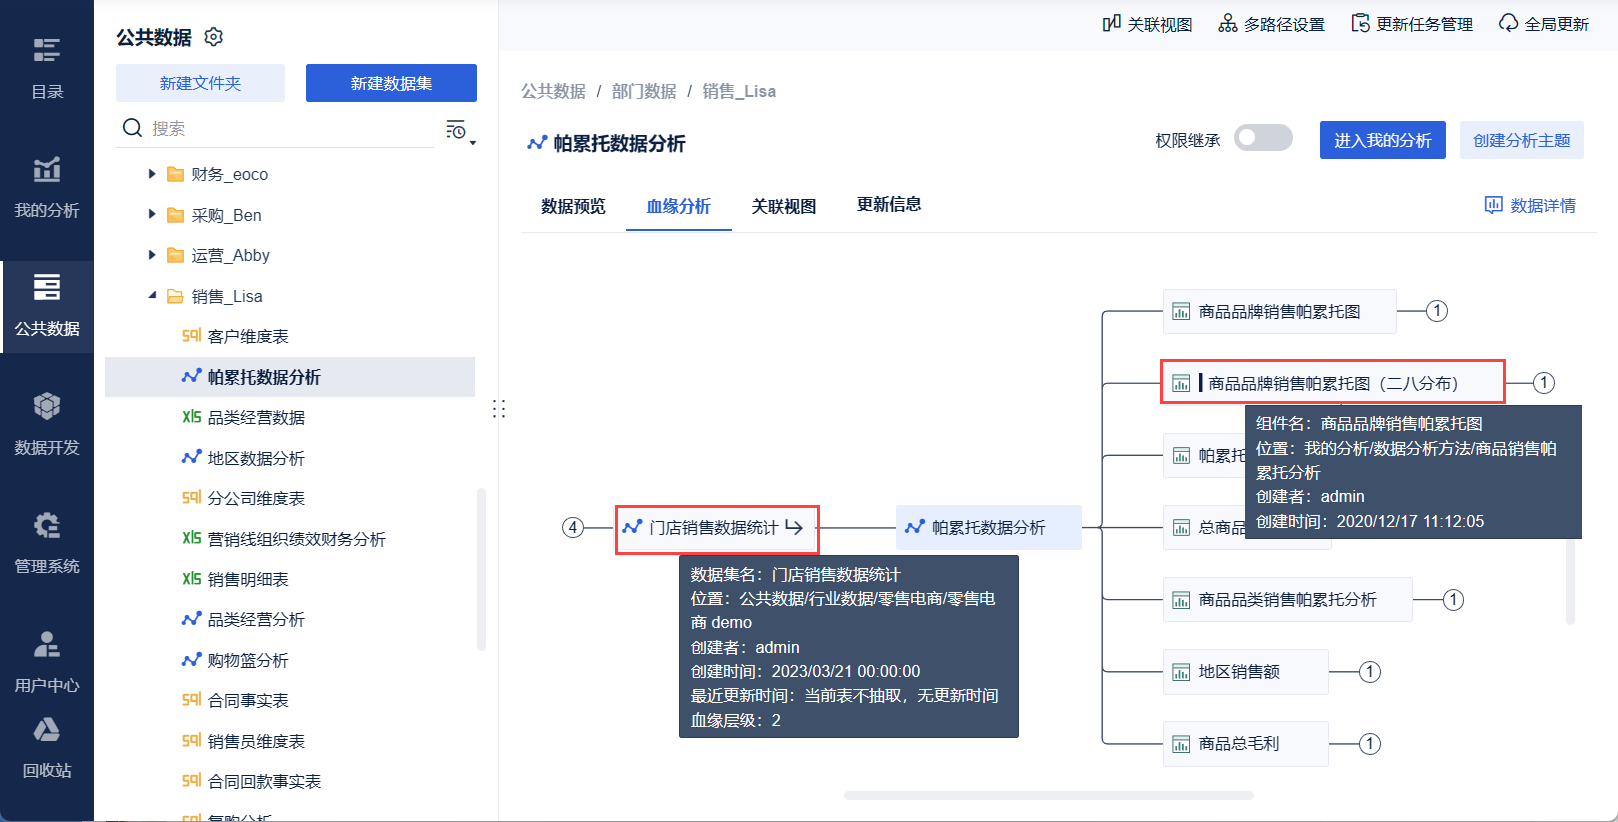
В деталях таблицы данных отображается уровень линии таблицы, который представляет собой иерархический уровень таблицы данных в линии:
- Если таблица данных имеет иерархию линий 1, это означает, что у таблицы данных нет родительской таблицы и она является предком или одним из предков этой линии.
- Если таблица данных имеет уровень родства 2, это означает, что над таблицей данных находится родительская таблица на 1 уровень выше.
- Если таблица данных имеет уровень родства 13, это означает, что у нее 12 уровней родительских таблиц. Все таблицы на этих 12 уровнях являются ее исходными таблицами, и изменения в этих исходных таблицах будут влиять на эту таблицу. Мы должны стараться избегать такого рода глубокой иерархии, как описано в разделе 3.
Примечание: Чтобы избежать проблем с обслуживанием, вызванных глубокой иерархией кровного родства, максимальный предел иерархии по умолчанию для всех таблиц данных в новых проектах 6.0.12 и более поздних версий составляет 16.
Если исходная таблица все еще имеет исходную таблицу, таблица-потомок имеет таблицу-потомка и приборную панель, а компонент также имеет приборную панель, он продолжит выполнять анализ линии. Следующий уровень линейного анализа по умолчанию свернут, и пользователь может вручную настроить его на развертывание и свертывание, как показано ниже:
2.2 Нажмите, чтобы перейти к соответствующему месту
Нажмите кнопку Table Jump, чтобы перейти к соответствующей позиции таблицы. Как показано на рисунке ниже:
Примечание: Если таблица данных не имеет разрешений на использование, а дашборд не имеет разрешений на просмотр, их вкладки окрашиваются в серый цвет и нажатие на них не приводит к переходу.
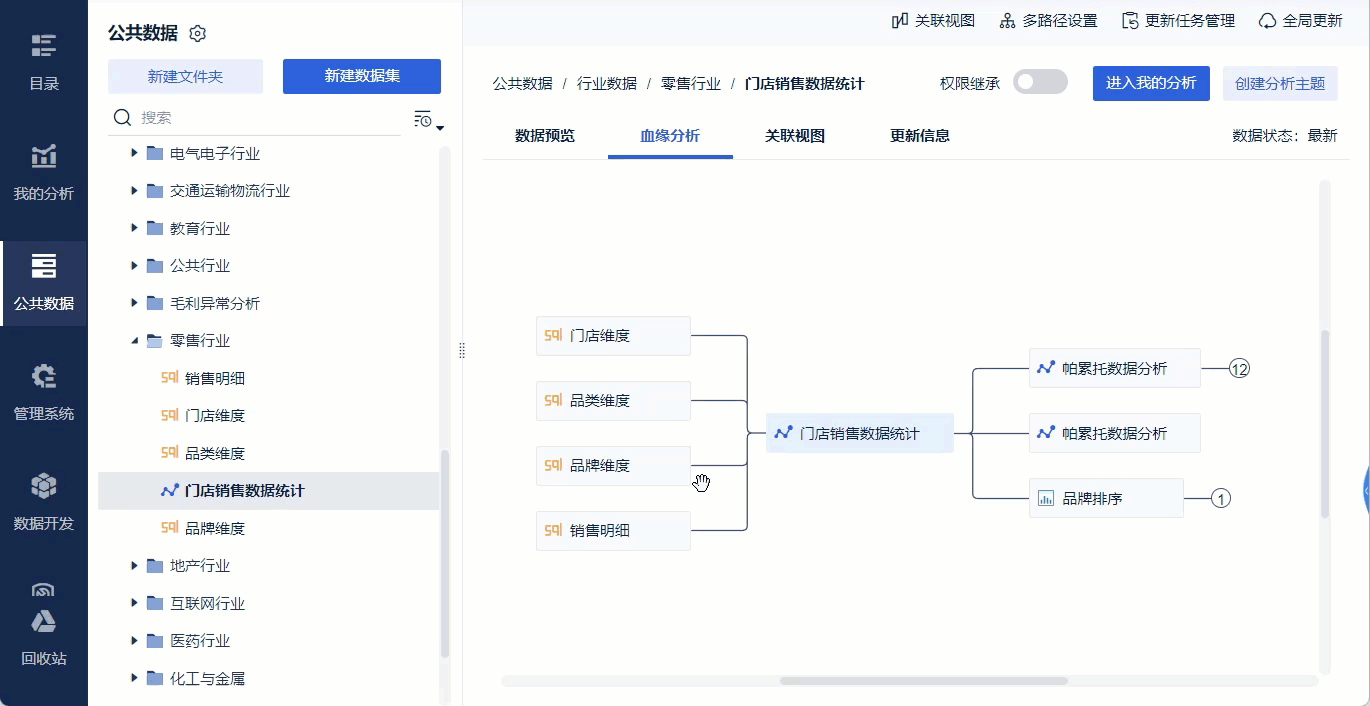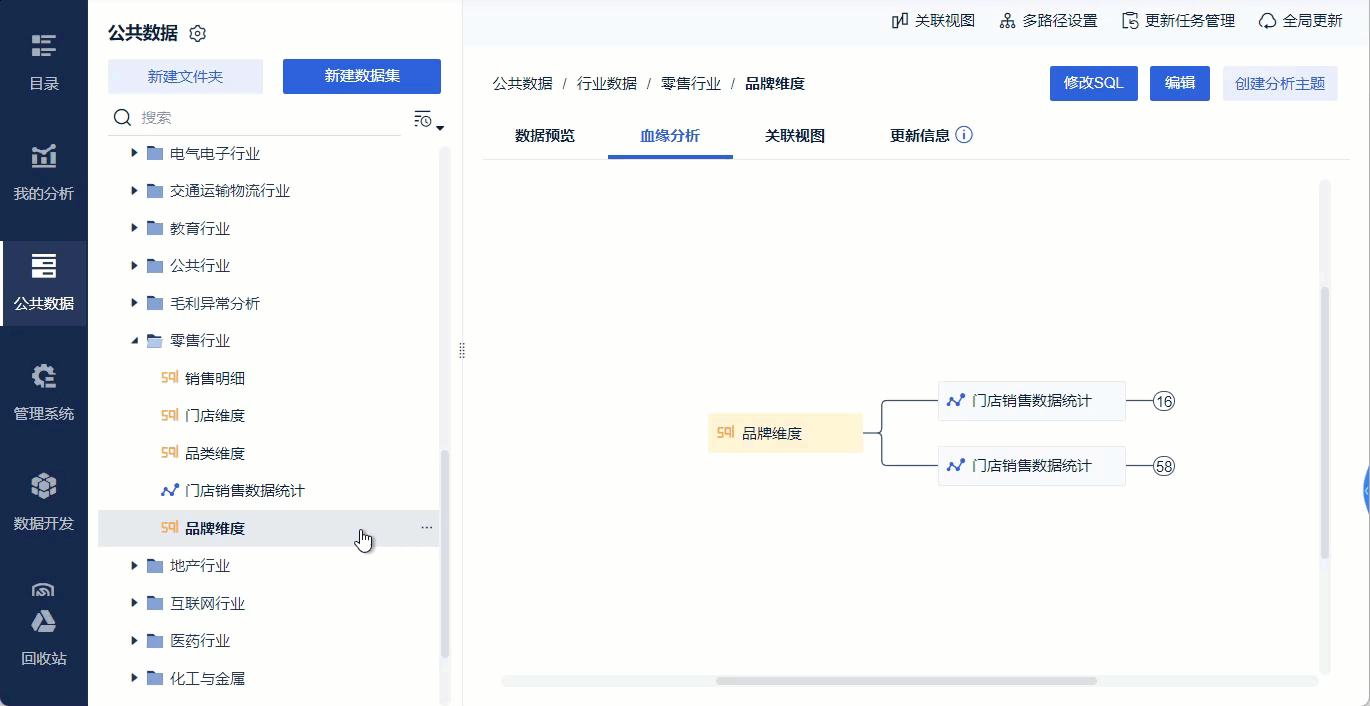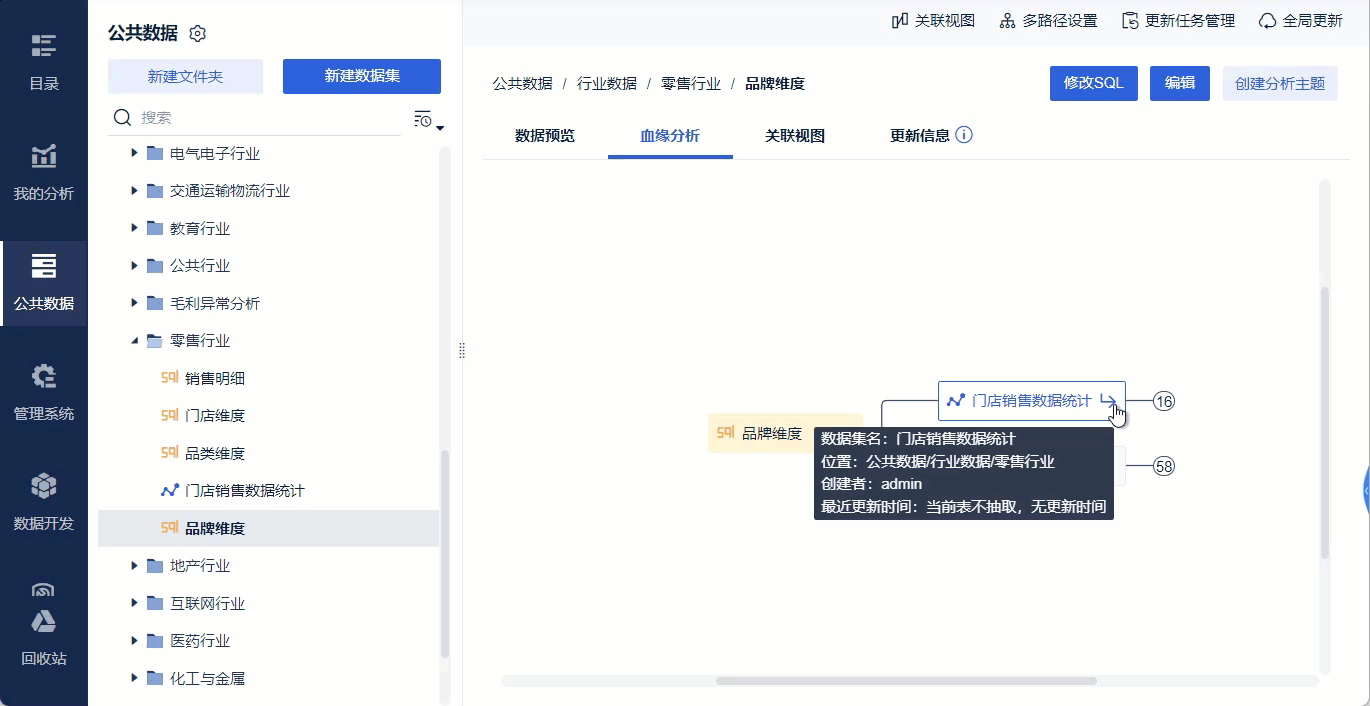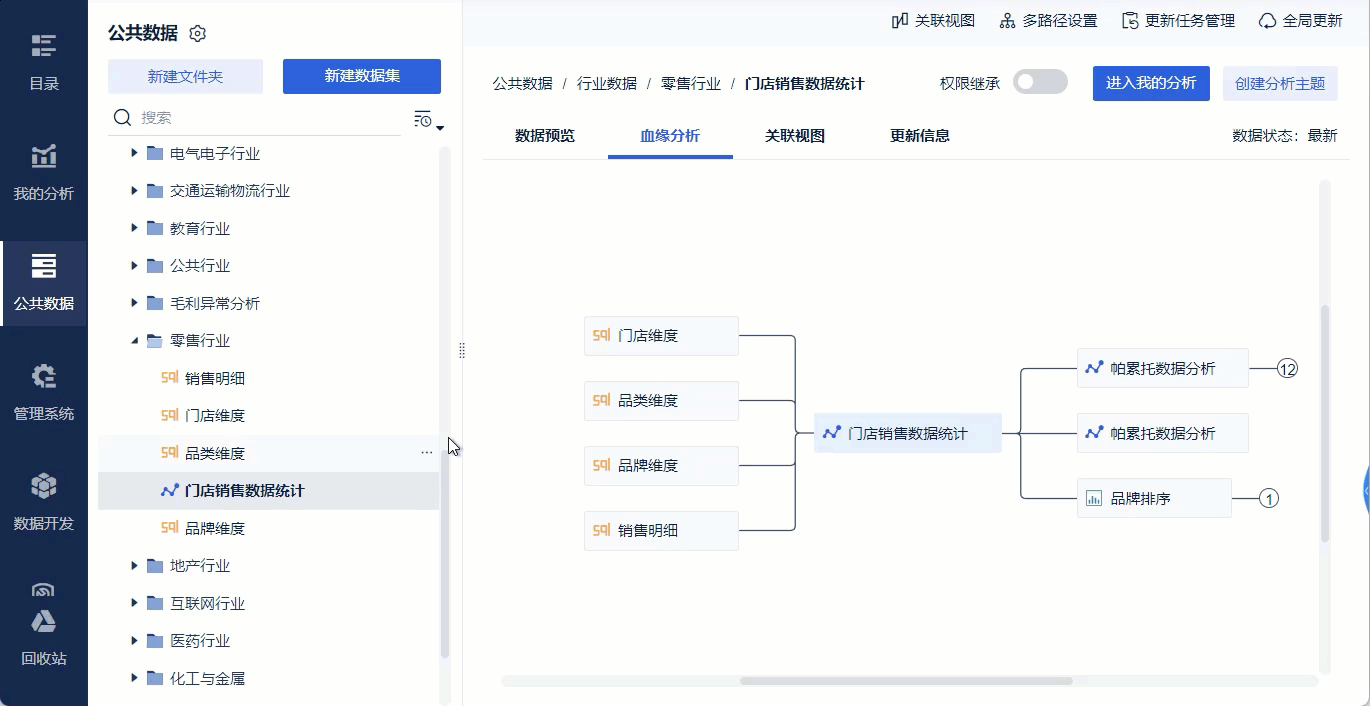
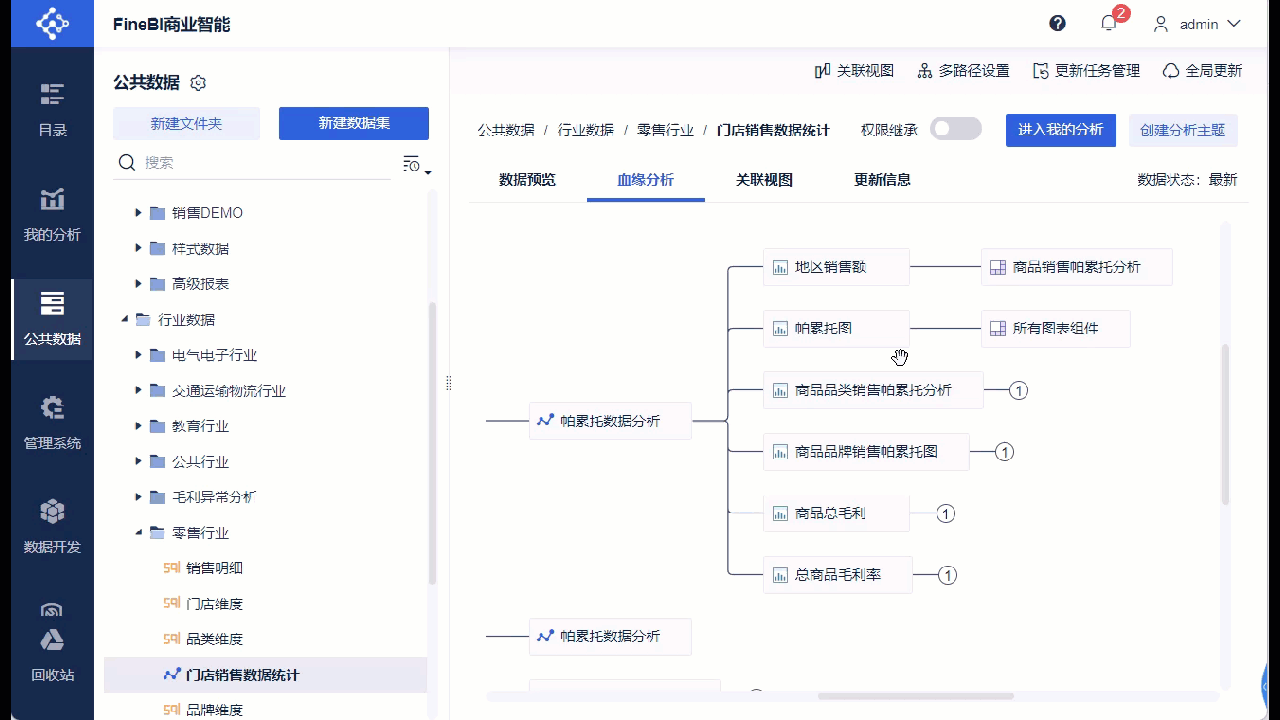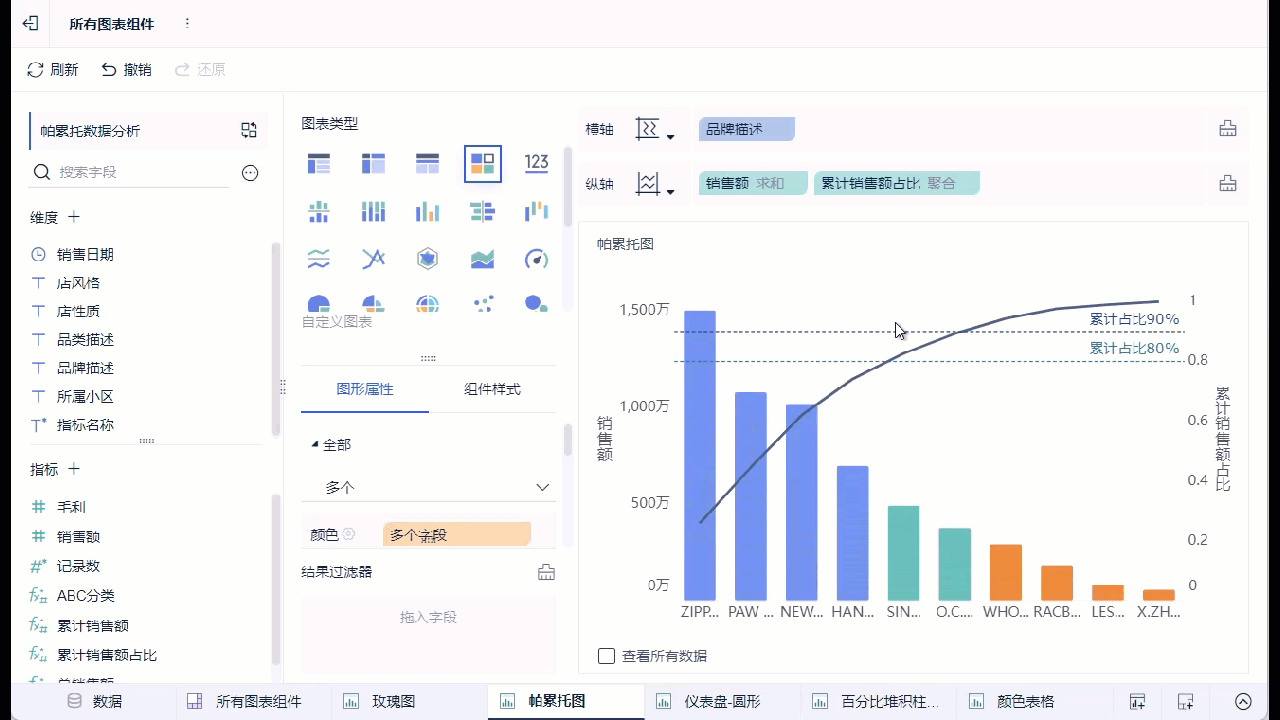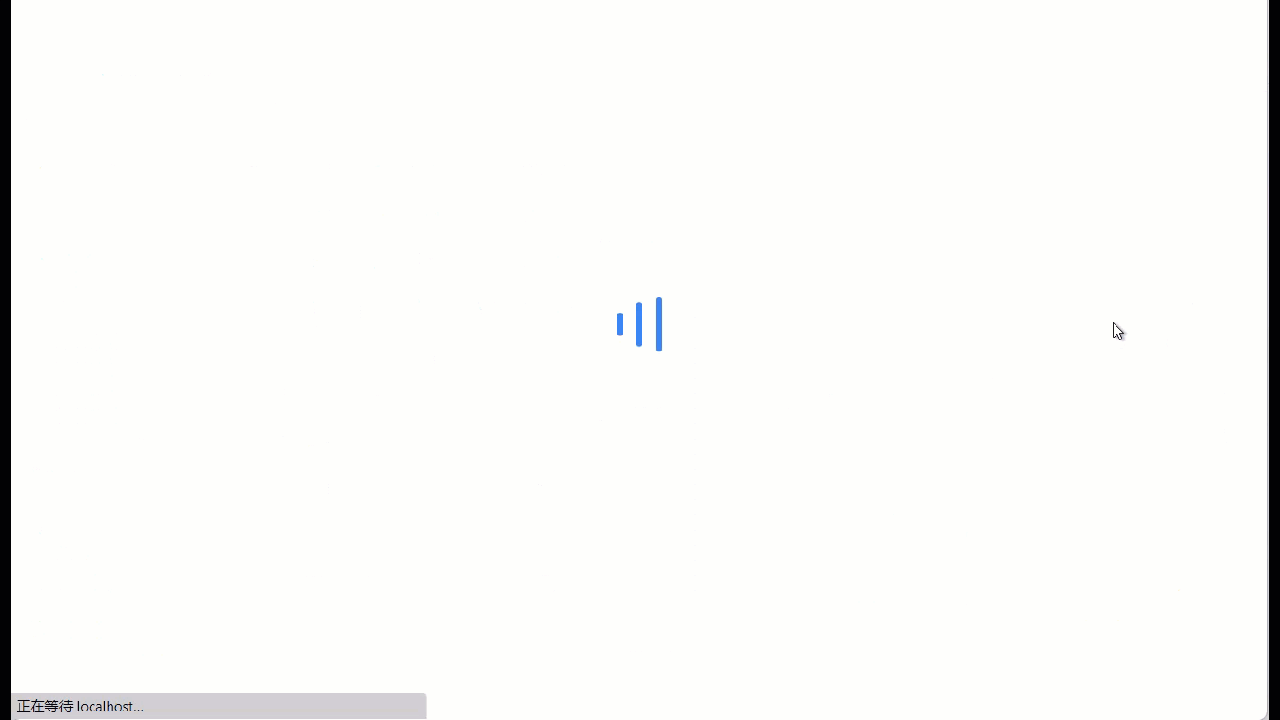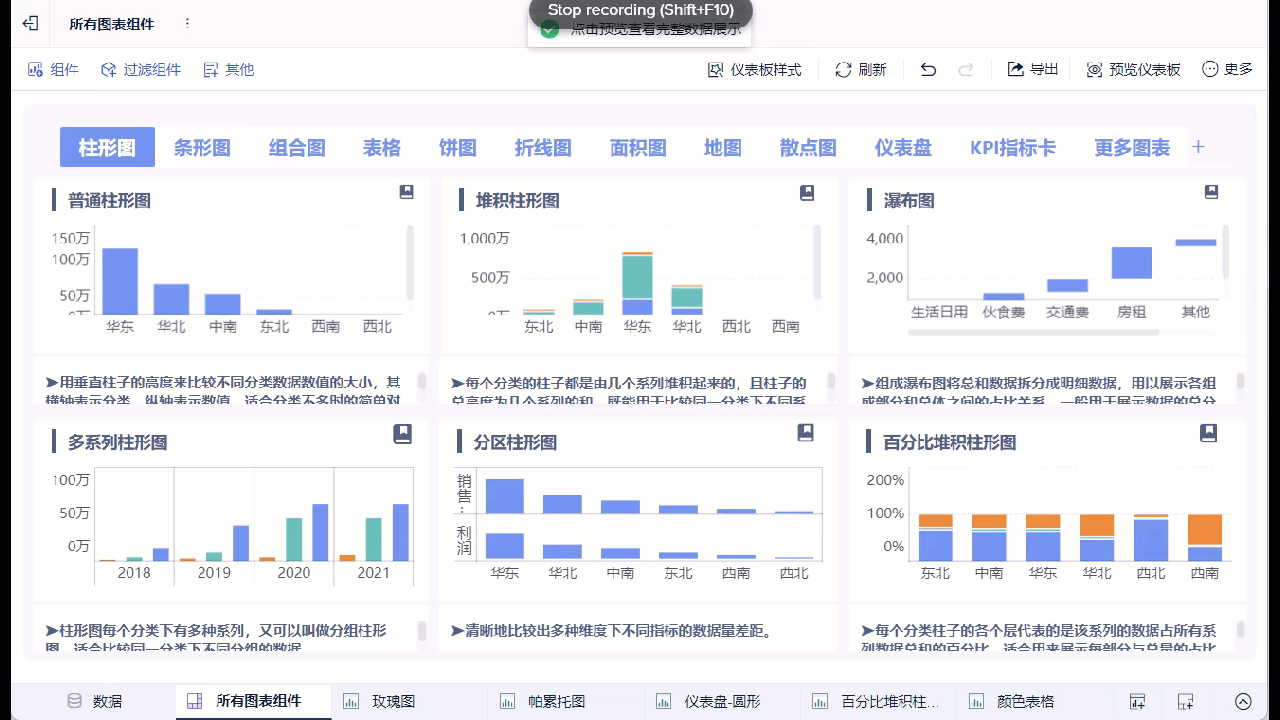
Нажмите кнопку Перейти, чтобы перейти к экрану редактирования компонента или приборной панели.
Примечание: Только создатели компонентов и приборных панелей могут нажимать на переход на экране анализа родословной, другие пользователи не могут нажимать на переход в соответствующее место.
3. избегайте создания таблиц данных с глубокой иерархией.
3.1 Вред глубокой кровной иерархии
На рисунке ниже видно, что для "текущей таблицы" существует бесчисленное множество родительских таблиц, а каждая родительская таблица имеет бесчисленное множество родительских таблиц, образуя глубокую линейную иерархию. Поэтому, когда возникает проблема с "текущей таблицей", становится очень сложно отследить источник проблемы. Трудно определить проблему по этим родительским таблицам, что усложняет поиск и устранение неисправностей.
Еще более тревожным является тот факт, что при отказе любой из тысяч родительских таблиц "текущая таблица" может стать недоступной. Такие зависимости делают стабильность и доступность всей таблицы чрезвычайно хрупкой.
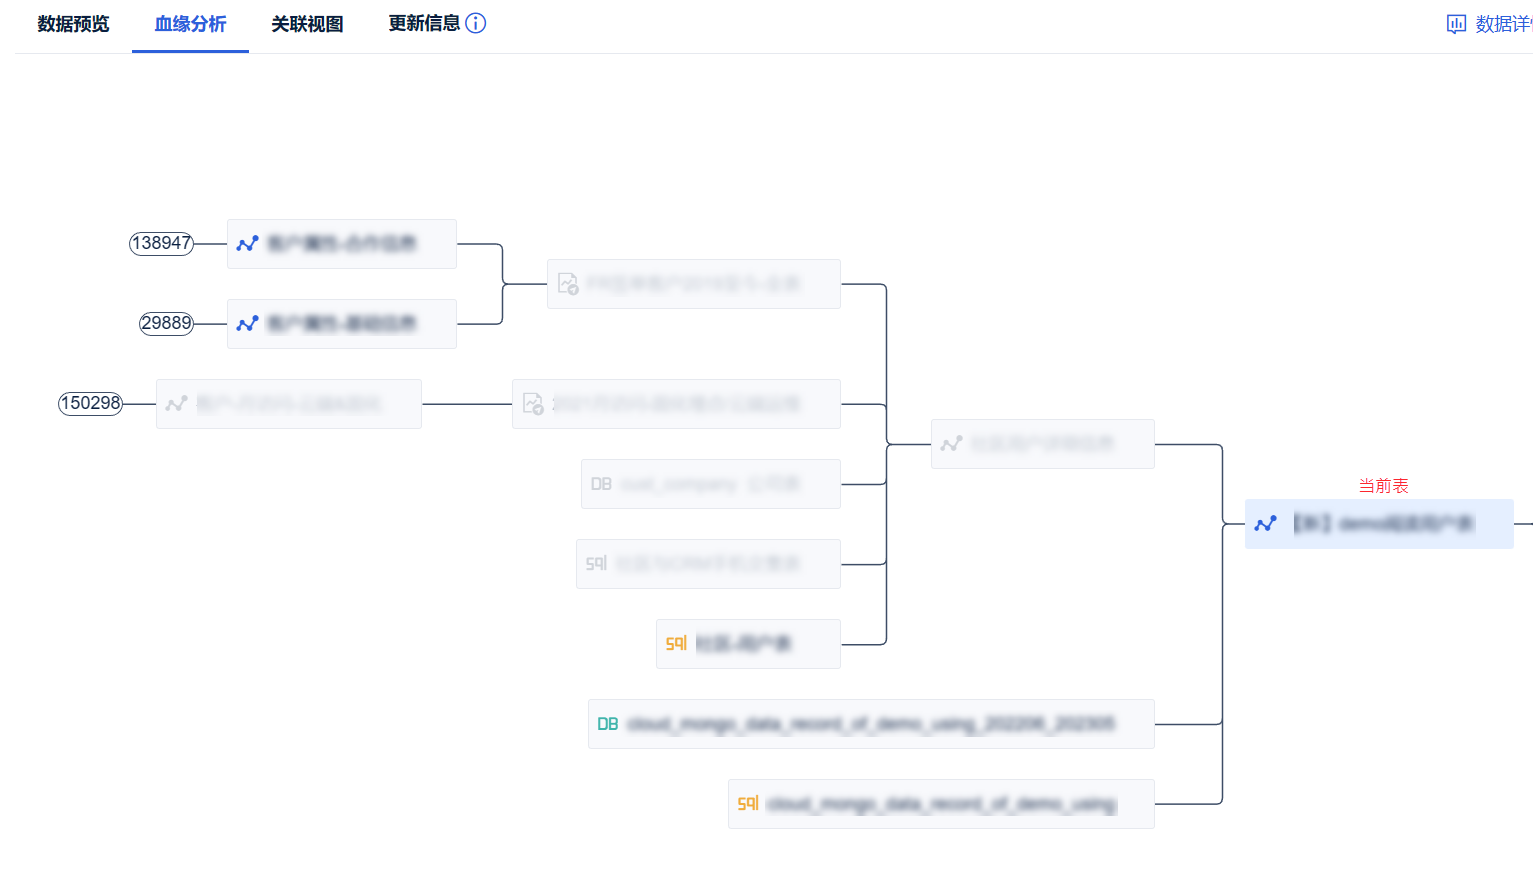
Выше мы показали крайний случай, и этот пример также предостерегает нас от создания и использования таблиц данных с глубокой иерархией родословных:
- Сложность понимания и сопровождения: когда структура таблицы очень глубокая, отношения между элементами данных становятся сложными, и становится трудно читать и понимать логику структуры таблицы. Специалистам по сопровождению данных и разработчикам трудно точно понять, откуда берутся данные в таблице и куда они попадают, что увеличивает сложность работы по сопровождению.
- Опасность ошибок и риск: глубокие таблицы подвержены влиянию тысяч таблиц данных одновременно, и достаточно одной ошибки в родительской таблице, чтобы сделать текущую таблицу непригодной для использования.
- Неэффективность: при большой глубине иерархии таблиц эффективность запросов и манипуляций с данными может снижаться. Производительность запросов и эффективность доступа к данным могут пострадать из-за необходимости получать нужные данные по нескольким иерархиям, а влияние на обновление таблиц данных может быть значительным и отнимать много ненужных ресурсов на обновление.
3.2 Как оптимизировать (неглубокие) кровные линии
Мы можем сделать кровные отношения в FineBI проще, сделав следующее:
3.2.1 Данные в публичных базах данных по мере возможности подготавливаются ИТ-специалистами
Давайте рассмотрим позиционирование "Public Data" и "Моей аналитики":
- Public Data: это место, где хранятся Public Data, не являющееся личным пространством, поэтому оно похоже на общественное место, например вокзал или парк. В общественных местах наше оборудование и поддержку готовят специализированные муниципальные учреждения. Поэтому лучше всего, чтобы подготовкой Public Data занимались профессиональные ИТ-специалисты, которые обеспечат порядок, эффективность и надежность в пространстве Public Data.
- My Analysis: это пространство, которое каждый из нас может анализировать самостоятельно. Это эквивалентно нашему собственному дому, который мы можем украшать как угодно, но если он будет аккуратно оформлен, нам будет комфортнее жить.
Затем IT-специалисты готовят Public Data и объясняют, почему они могут оптимизировать кровные линии:
- ИТ-персонал обычно использует специализированные инструменты ETL, такие как FineDataLink, для управления данными, а затем добавляет данные в Public Data FineBI через наборы данных SQL или таблицы DB. Полученные таблицы отличаются высоким качеством и не имеют родительских таблиц, а анализы, использующие их, не вызывают сложных родословных связей.
- Качество обработки данных и планирования ИТ-персоналом выше и меньше вероятность возникновения проблем, которые повлияют на последующие субресурсы, созданные с помощью таблицы.
3.2.2 Избегание разглашения данных на уровне глубокой родословной
Хотя мы не рекомендуем публиковать таблицы в Edit Data как таблицы Public Data, если у вас есть такая необходимость, мы рекомендуем вам выбрать таблицу более низкого уровня для публикации в Public Data.
Например, если таблица данных с уровнем иерархии 12 опубликована в открытых данных, новые аналитические ресурсы, созданные другими пользователями с использованием этой таблицы, будут иметь уровень родства больше 12.
Напротив, если таблица данных с уровнем иерархии 2 опубликована в открытых данных, новые аналитические ресурсы, созданные другими пользователями с использованием этой таблицы, будут иметь уровень родословной больше 2, что гораздо лучше, чем в первом случае.
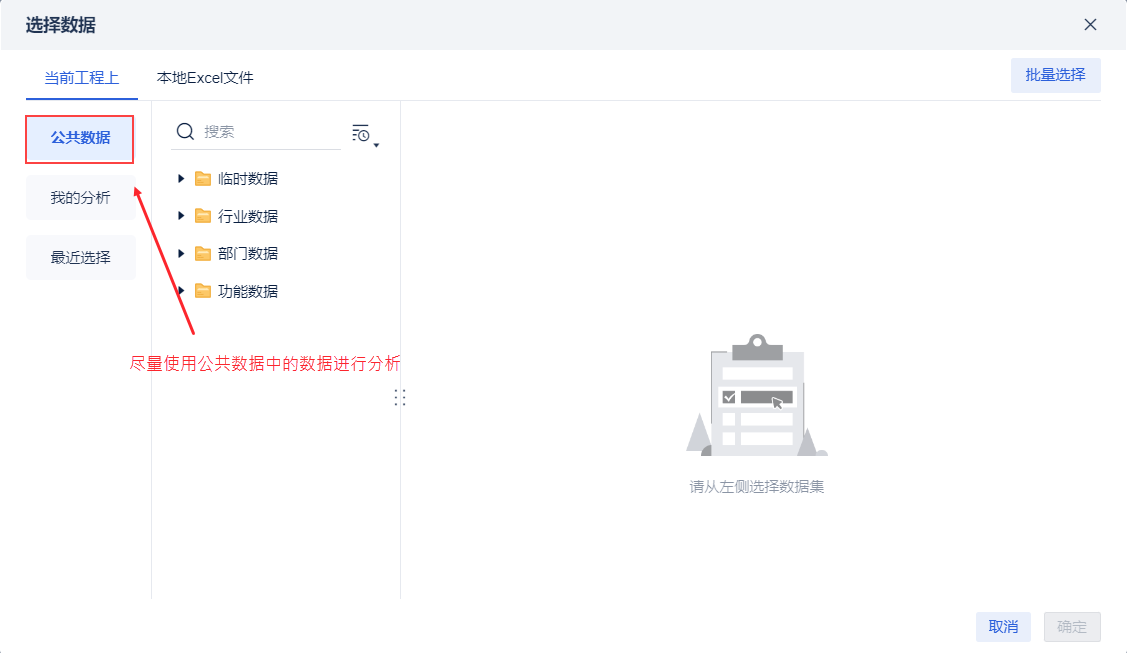
3.2.3 Максимальное использование данных из открытых источников для анализа
Данные в открытых данных чище и менее иерархичны, а обращение к данным в открытых данных для анализа может значительно оптимизировать родословные.
А если вы будете цитировать данные в "Моем анализе", это приведет к сцеплению между темами и путанице в таблицах данных, поэтому мы должны воздерживаться от цитирования данных в темах.
4. условия
4.1 Наборы данных в Bloodlines не могут быть использованы без разрешения
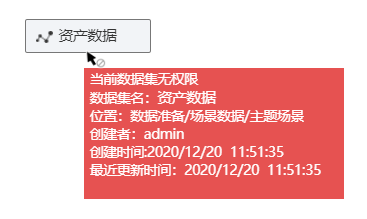
- Текущий набор данных не имеет разрешения: Этот набор данных не имеет разрешения на использование, вам необходимо, чтобы администратор назначил разрешение на использование данных;
- Текущая дашборд/компонент не имеет прав: это не дашборд/компонент, созданный мной, поэтому он не имеет прав;
- Текущий набор данных/панель/компонент недоступен: обновление данных не удалось, что привело к недоступности, необходимо проверить статус обновления;
- Текущий набор данных/панель/компонент отсутствует: содержимое было удалено, или содержимое, которое было опубликовано или предоставлено в общий доступ, не было опубликовано или предоставлено в общий доступ;
4.2 Превышение ограничений иерархии спуска
По умолчанию максимальный уровень крови в таблице данных составляет 16. Если уровень таблицы данных превышает 16, будет выдано сообщение об ошибке: текущий набор данных превышает предел уровня крови.
Это означает, что родительская таблица текущей таблицы находится слишком высоко в иерархии, поэтому пользователь может повторно выбрать таблицу с более низкой иерархией в качестве родительской таблицы и заново отредактировать данные.
111s