Оформление
Доступ к данным и обновления - Справка FineReport | Разработка отчетов | Отчетность | Учебные пособия
Доступ к данным и их обновление
1. Обзор
Раздел "Управление данными" посвящен пониманию того, как получить доступ к системе BI для существующих данных, которые были отсортированы, и обеспечить постоянную доступность данных в BI.
Ключевые элементы включают:
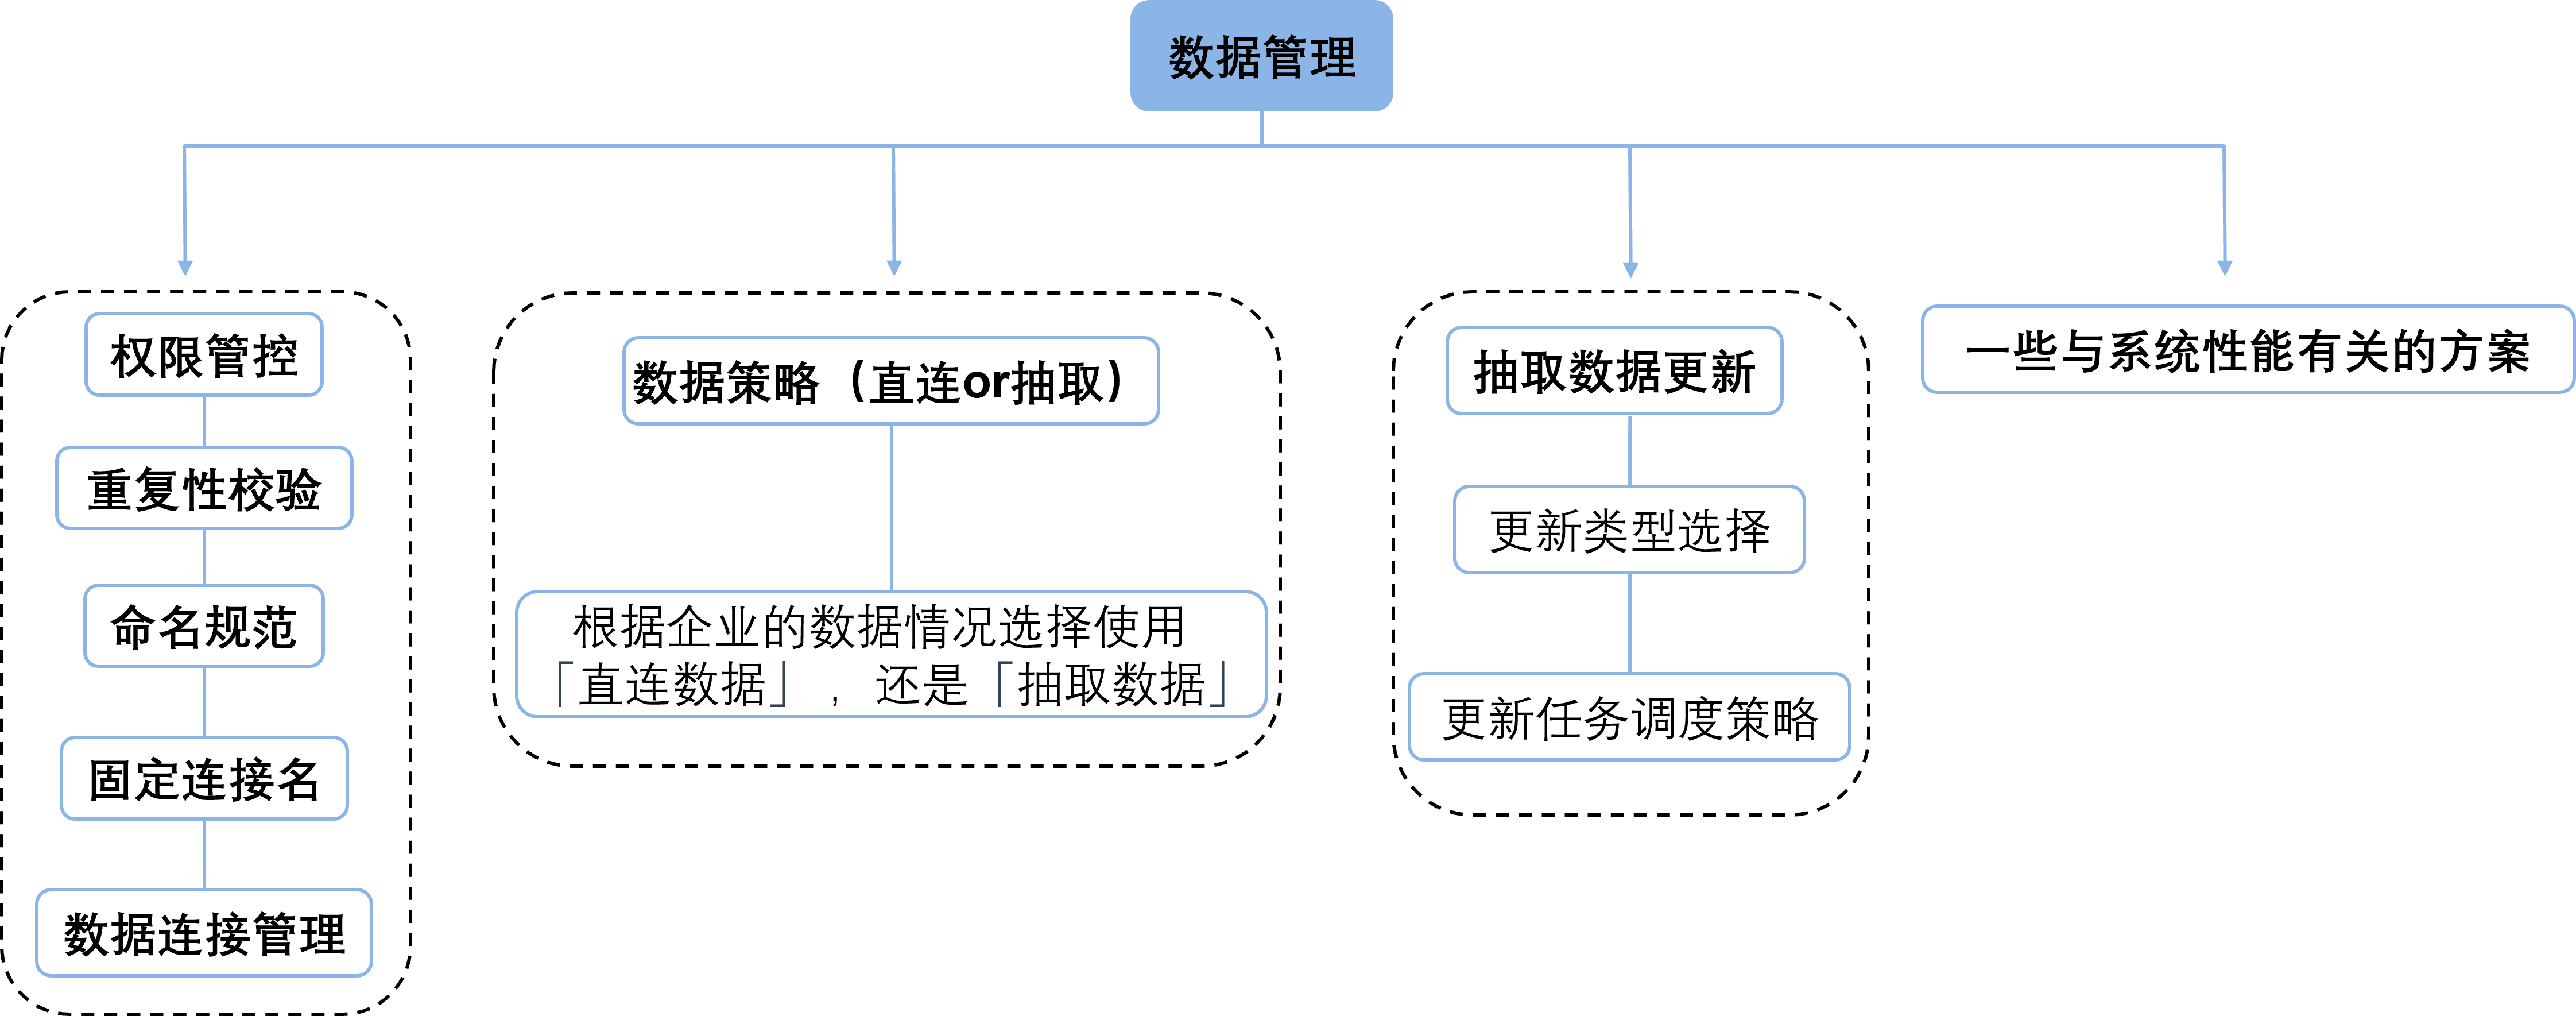
Для: администраторов платформ, персонала по эксплуатации и обслуживанию ИТ.
2. управление подключением данных
- Контроль привилегий: привилегия на создание соединения с данными доступна только суперменеджменту и субменеджменту.
- Проверка повторяемости: перед созданием соединения с данными необходимо выяснить, существует ли уже такое соединение, и нельзя создавать два соединения с данными, указывающих на одни и те же параметры (адрес базы данных, имя библиотеки, пользователь и т. д.).
- Спецификация именования: должна быть единая спецификация именования соединений данных, которая может иметь вид "бизнес-система/тема данных/тип базы данных", например, "BI-платформа_операции_MySQL", "данные транзакций системы xxERP_GP"; или "бизнес-система/тема данных_используемый отдел_добавить/ответственное лицо", например, "запись использования BI-платформы_отдел_операций_Питер" и другие спецификации. . Суперадминистратору необходимо осуществлять единый контроль именования соединений с данными.
- Фиксированное имя соединения: имя соединения с данными не может быть легко изменено, после его изменения таблица базы данных выдаст ошибку, так как не сможет найти базу данных, поэтому необходимо заранее спланировать имя соединения с данными. После изменения имени соединения с данными набор данных SQL должен войти на страницу Modify SQL для повторного выбора соединения с данными. Если имя соединения с данными может быть изменено, попробуйте добавить таблицу базы данных с помощью SQL вместо таблицы базы данных db.
3. стратегия работы с данными (прямое подключение или извлечение)
FineBI поддерживает два режима получения данных, а именно: режим прямого подключения - прямое использование данных и возможностей базы данных для выполнения вычислений, и режим извлечения - данные должны быть извлечены и сохранены в движке FineBI для выполнения вычислений. Более подробную информацию вы можете найти в документе: Разница между прямым подключением и извлечением данных.
Для одной и той же системы могут существовать как извлеченные, так и непосредственно подключенные данные, однако следует учитывать, что для одной панели можно использовать только один вид данных.
- Если у предприятия есть более профессиональная платформа больших данных, качество данных очень высокое, или требования к данным в реальном времени очень высокие, не принимаются данные T+1, или требования к безопасности данных очень высокие, не хочется хранить данные в дополнение к BI-проекту, то в это время можно выбрать режим прямого подключения.
- Кроме того, если предприятие имеет максимальный объем данных более 100 миллионов и нуждается в частом анализе таблиц с большими объемами данных, мы рекомендуем использовать режим прямого подключения, чтобы снизить нагрузку на BI-сервис за счет децентрализации вычислений в базе данных.
- Однако версия с прямым подключением не поддерживает совместный анализ таблиц данных между источниками данных (установление корреляции, объединение вверх и вниз, объединение слева и справа и т. д.). Если в реальном бизнесе есть требования к корреляции таблиц, вы можете использовать продукты Finedatalink для достижения синхронизации данных между базами данных.
- Расчет извлеченных данных использует вычислительную мощность и ресурсы BI-сервера (в основном память), и факторы, влияющие на производительность, в основном зависят от ресурсной ситуации на сервере и способности BI использовать ресурсы; в то время как расчеты при прямом подключении обрабатываются FineBI через движок, который преобразует логику вычислений на внешнем интерфейсе в sql базы данных, а затем отправляет ее в базу данных для выполнения расчетов, и BI получает результаты, возвращенные базой данных, для выполнения отображения. BI получает результаты, возвращенные из базы данных, чтобы сделать дисплей, производительность и двигатель базы данных сильно коррелируют. Если предприятия используют напрямую подключенные данные, они должны подтвердить, может ли база данных бизнеса поддерживать высокую параллельность sql вычислений, отправленных BI, включая скорость запроса и использование ресурсов при высокой параллельности.
4. извлечение обновлений данных
Хорошая спецификация обновления данных обеспечивает нормальное использование данных, стабильную работу системы, быстрое обновление данных и относительно низкое потребление ресурсов; она также позволяет избежать проблем и рисков, вызванных неправильными настройками.
Примечание: Для получения подробной информации об извлеченных данных см. другой документ из этой серии: doc-view-1823.md
4.1 Выбор типа обновления
1) Таблица данных - это размерная таблица / таблица с небольшим количеством данных, вы можете использовать полное обновление.
(2) Если в таблице есть поле "временная метка", которое можно использовать для сравнения с "временем обновления" для достижения инкрементного обновления, и если исторические данные не будут меняться, метод инкрементного обновления является предпочтительным. (За исключением серверного набора данных и набора данных Excel)
- Когда настроено инкрементное обновление, SQL для инкрементного обновления не может быть пустым.
- Для инкрементного удаления не следует выбирать *, нужно выбирать только уникально различимые поля, например uuid.
4.2 Обновление стратегии планирования задач
Общая стратегия обновления такова: глобальное обновление по времени + обновление по времени специального бизнес-пакета + обновление по времени специальной отдельной таблицы. То есть, за исключением небольшого количества специальных требований (например, требования к реальному времени высоки, обновление в день не может удовлетворить спрос, или бизнес имеет особый характер может быть настроен отдельно), другие не данные своевременности требования режима извлечения набора данных обновления единой глобальной обновления (бизнес-пакеты следовать глобального обновления обновления, основной набор данных следовать бизнес-пакет обновления обновления обновления обновления обновления, самопомощи набор данных следовать обновления родительской таблицы для обновления).
- При выборе стратегии обновления вы можете отдать предпочтение разработке глобального времени обновления (которое можно гибко настроить в соответствии с последним временем завершения извлечения данных в среднем офисе), а затем настроить обновление бизнес-пакетов и таблиц по времени в случае особых обстоятельств. Наборы данных Self-service настраивать не нужно, они будут автоматически обновляться вслед за используемой родительской таблицей.
- Если вы не проводите глобальное обновление или хотите обновить больше таблиц/бизнес-пакетов по отдельности в другое время на основе глобального обновления, предварительно проверьте связанные с ними таблицы кровного родства. Для задач с большим количеством перекрывающихся таблиц родства рекомендуется поместить их в одно и то же время обновления, поскольку, пока они обновляются вместе, они будут автоматически де-дублированы, и не возникнет проблемы дублирования обновлений; напротив, если в настройках установлено перемешивание обновлений на определенный период времени, а две задачи обновления, связанные с одной таблицей, имеют одну и ту же таблицу, то таблица может быть продублирована, что является нерациональным использованием ресурсов; если таблицы родства нескольких задач почти не перекрываются, то Для предотвращения блокировки системы рекомендуется распределить время обновления.
- Если существует конфликт со временем обновления данных в хранилище/среднем офисе, в результате чего данные платформы не отображают последние данные, администратор должен своевременно обновить их; однако при обновлении следует учитывать порядок величины и количество связанных наборов данных, и если набор данных слишком большой или в нем слишком много ассоциаций (>50), следует нажать на кнопку, чтобы обновить его в свободное время системы.
5. некоторые программы, связанные с производительностью системы
(1) Используйте плагин "Глобальный контроль памяти" (уже встроенный): когда в процессе использования память увеличивается до предупредительного значения, поток экспорта может быть активно прерван механизмом защиты BI-мониторинга памяти.
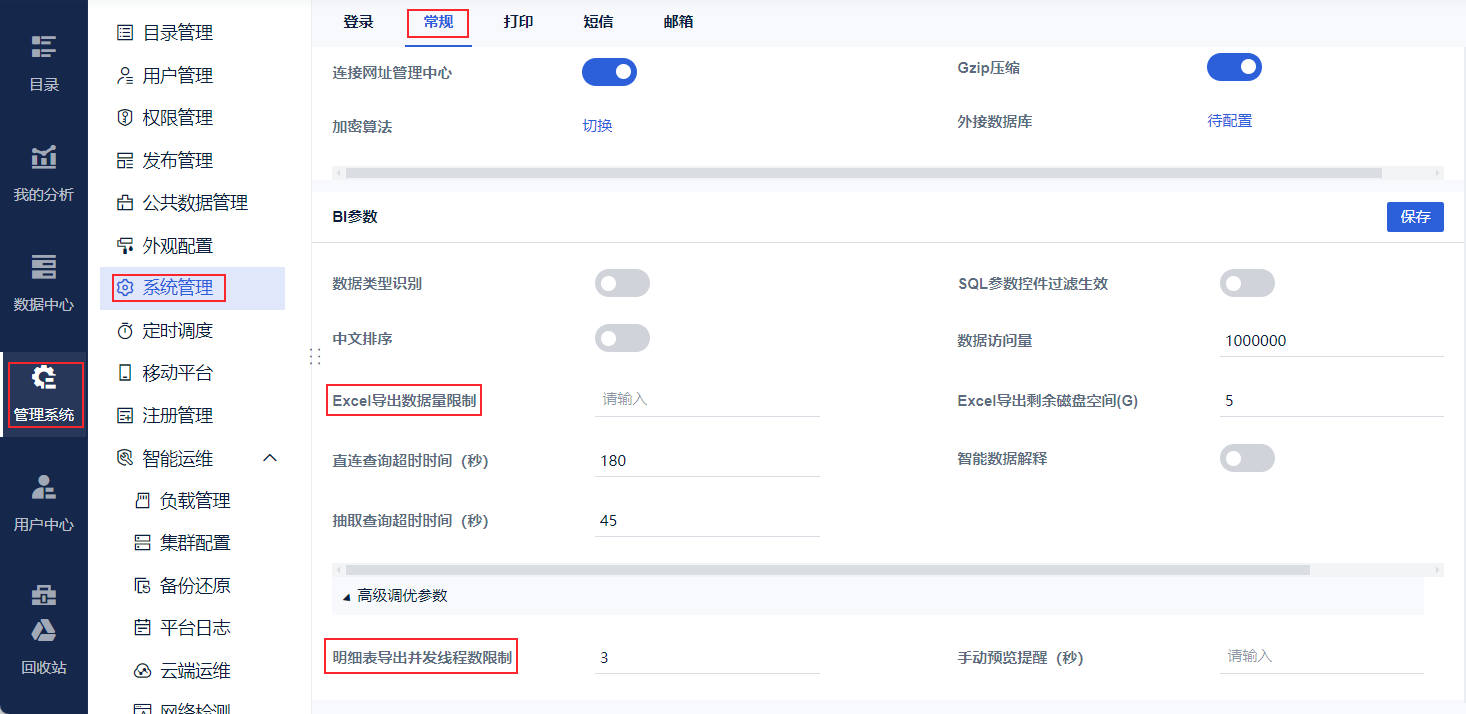
(2) Установите параметры ограничения экспорта Excel: "System Management" > "Управление системой" > "Общие", есть два параметра для ограничения экспорта:
- Параметр "Ограничение объема экспортируемых данных Excel" по умолчанию не установлен, рекомендуется настроить диапазон: 0-1000000000;
- Значение по умолчанию "Concurrent Threads Limit for Schedule Export": 3, рекомендуемый диапазон настроек: 1-5 (рекомендуется оставить значение по умолчанию).
3) Если вы используете nginx, вы можете настроить http2: это позволит увеличить количество одновременных запросов к браузеру (включение протокола http2 приведет к увеличению количества одновременных запросов к базе данных, что необходимо оценивать в совокупности с производительностью базы данных).
4) Использование визуальной конфигурации FINE_CONF_ENTITY Конфи гурация плагина
SystemOptimisationConfig.queryConditionCountRestriction Параметр: позволяет прервать запрос, если количество условий фильтрации превышает ограничение, и сообщить об ошибке: condition count out of restriction: xxxx. Рекомендуемое значение: 30 (или меньше, в зависимости от фактического сценария фильтрации). Рекомендуемое значение: 30 (или меньше, в зависимости от фактического сценария фильтрации).
5) Установите плагин "BI Linkage Limit": когда несколько компонентов приборной панели связаны друг с другом, три или более слоев связи будут удалены, а два слоя связи перед последним связанным компонентом будут сохранены, что обеспечивает производительность приборной панели и не приводит к очень медленной загрузке.
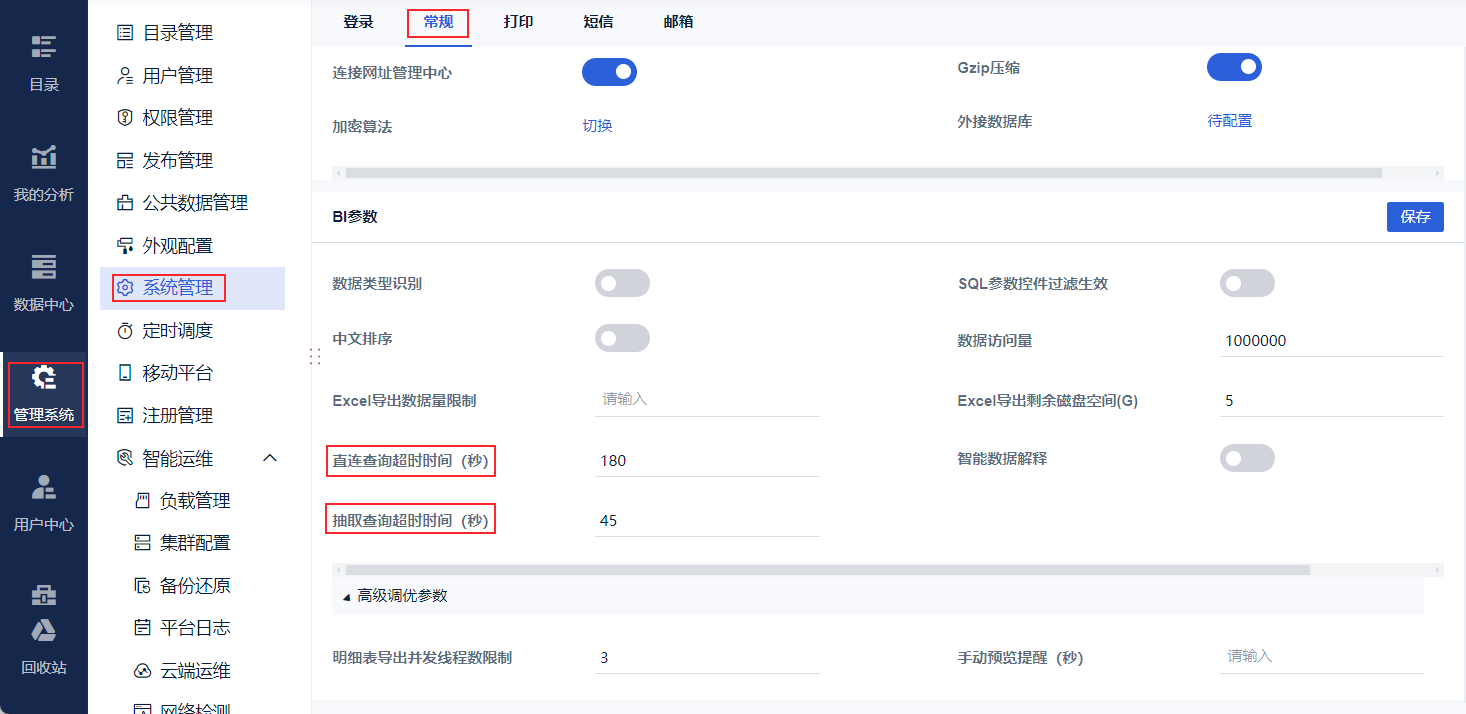
6) Ограничение длины запроса компонента: "System Management" > "Управление системой" > "Общие", есть два параметра для ограничения длины запроса компонента:
- Если дашборд имеет слишком много компонентов и время запроса компонентов слишком велико, или время запроса компонента в приборной панели слишком велико, что приводит к блокировке последующих BI-запросов и ошибочному простоям продукта, вы можете установить "Таймаут запроса прямого подключения/извлечения" с помощью этих двух параметров, и запрос будет прерван после истечения времени всех запросов реального времени/извлеченных данных, чтобы аномально медленный запрос не блокировал другие нормальные запросы.
- Рекомендуемый диапазон конфигурации: 10-300, настраивается в зависимости от реальной ситуации в бизнесе и приемлемого времени ожидания.
*Примечание: параметр extraction здесь ограничивает работу polars engine, если вы хотите, чтобы spider engine также работал, вам нужно установить параметры DistributedOptimisationConfig.spiderConfig.spider_query_timeout_open и DistributedOptimisationConfig.spiderConfig.spider_query_timeout_limit параметры, в случае большого параллелизма могут быть усечены, чтобы обеспечить доступность системы.