Оформление
Распространенные ошибки в кластере и их решения
1. Ошибка внешнего интерфейса кластера
1.1 Исключения узлов кластера Redis
1.1.1 Описание проблемы
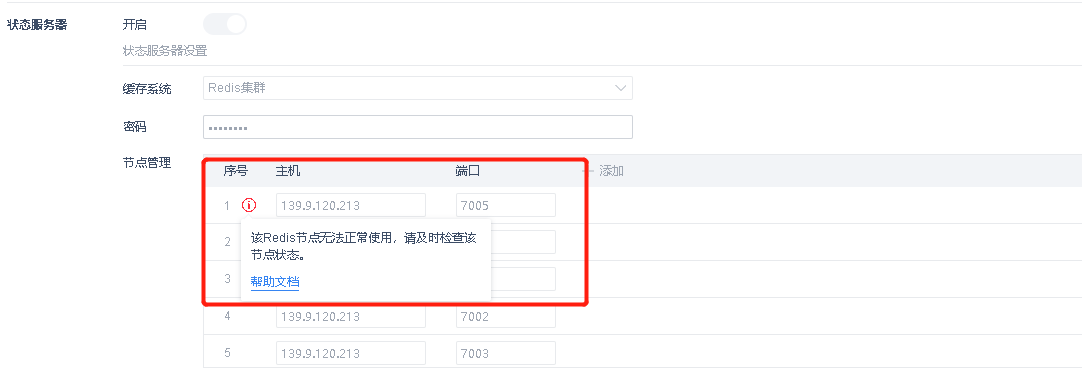
1.1.2 Анализ причин
Узел не работает или вышел из строя и не может продолжать предоставлять услуги в кластере Redis.
1.1.3 Решения
1) Войдите в кластер Redis и введите узлы кластера, чтобы проверить состояние кластера Redis.
r edis-cli -h ip -p port -a password # Клиент подключается к узлу удаленно, вводя соответствующие ip, порт и пароль.
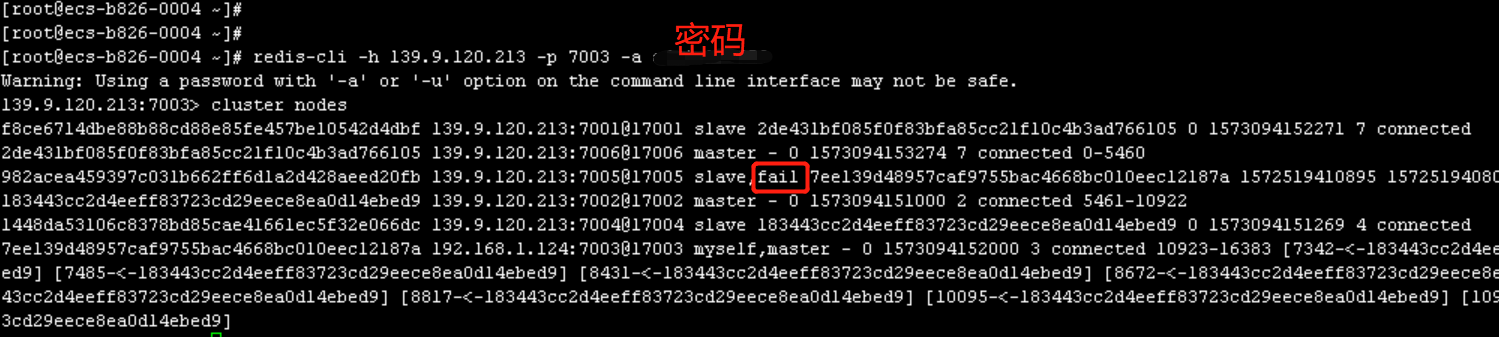
Когда мы проверяем, что узел Redis находится в состоянии падения (отказа), пожалуйста, проверьте процесс узла Redis, если процесс все еще там, то убейте его для перезапуска, если процесс не там, то напрямую запустите узел, запустите снова, чтобы проверить, восстановился ли он.
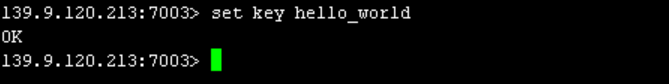
2) Если вы хотите подтвердить доступность вашего кластера Redis, вы можете подключиться к главному узлу и проверить, может ли он записать ключ.
Нормальные условия:
Исключение:
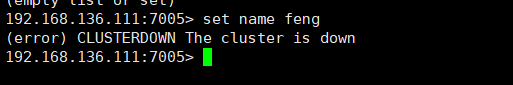
Когда мы обнаруживаем, что кластер Redis находится в незаписываемом (нерабочем) состоянии, что случается редко, мы рекомендуем перезапустить весь кластер Redis.
1.2 Несоответствующие пакеты JAR между узлами сообщают об ошибках
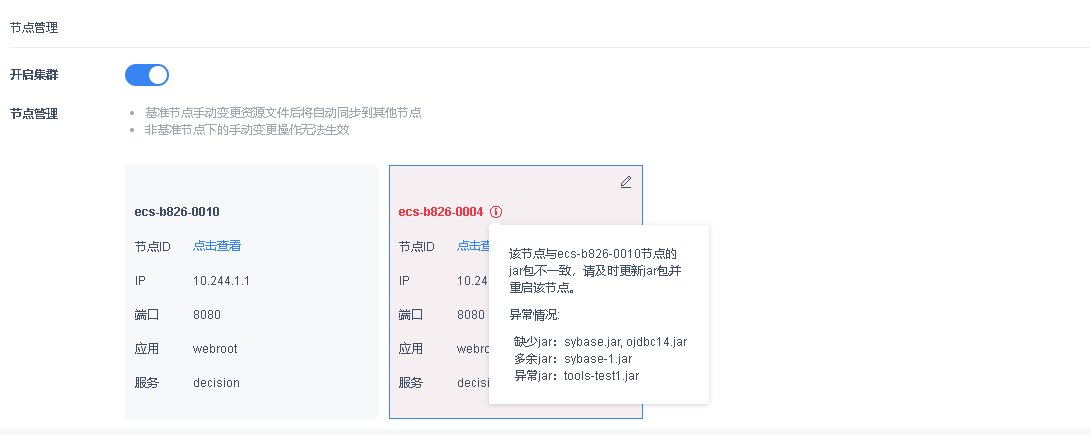
1.2.1 Описание проблемы
1.2.2 Причины ошибок в отчетах
Процесс запуска узла сравнивает пакеты jar с первым узлом, присоединившимся к кластеру, и если обнаруживаются несоответствия, фронт-энд выводит исключение и предоставляет подробную информацию о нем.
1.2.3 Решения
Обратитесь к подсказкам исключений, проверьте пакеты jar под каждым узлом и настройте их, перезапустите узел после завершения настройки, а затем посмотрите, остались ли ошибки.
1.3 Ошибка сбоя синхронизации
1.3.1 Описание проблемы
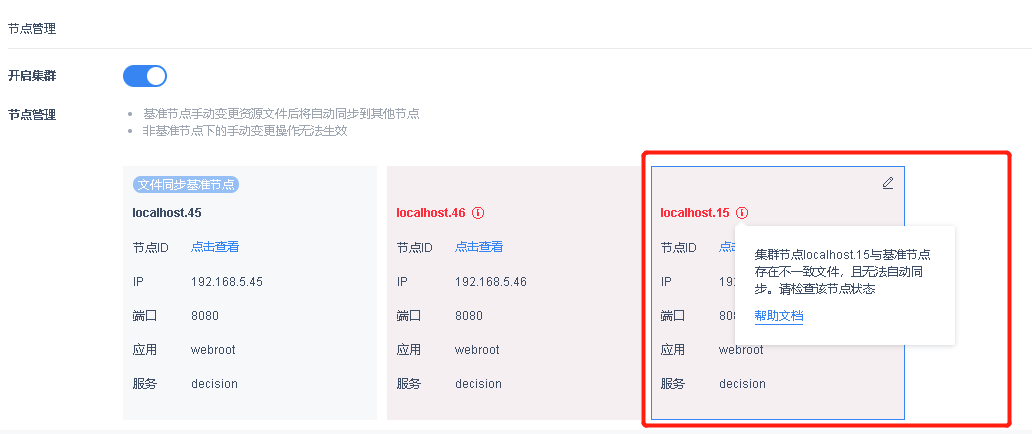
Синхронизация не сообщает об ошибке, как показано на следующем рисунке:
1.3.2 Анализ причин
Когда этот узел выполняет синхронизацию файлов с эталонным узлом синхронизации файлов, и происходит ошибка синхронизации или таймаут запроса, а повторные попытки остаются безуспешными в течение 3 раз, тогда внешний узел выполняет отображение исключения.
1.3.3 Решения
Проверьте, в норме ли связь между узлами и состояние сети, и своевременно внесите коррективы в случае каких-либо отклонений.
1.4 Платформа не может подключиться к Redis
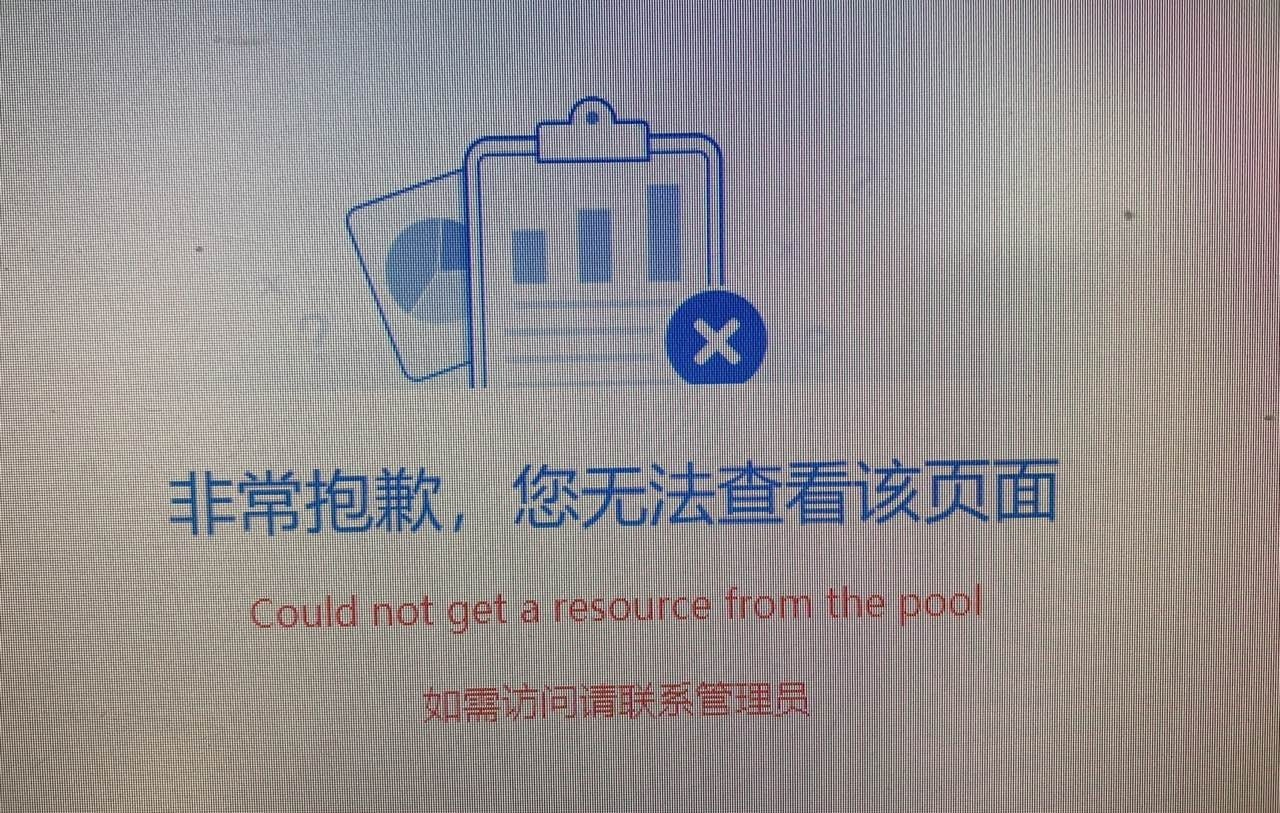
При обращении к интерфейсу отчетов выдается сообщение об ошибке:Could not get a resource from the pool Если вам необходимо получить доступ к нему, обратитесь к администратору, как показано на следующем рисунке:
Вероятная причина:
- Время простоя Redis
- сетевая аномалия
- Пароль Redis изменился во время работы проекта
Решение:
- Если Redis не работает или возникла сетевая аномалия, просто устраните неполадки и исправьте их обычным способом.
- Если Redis изменил пароль, необходимо перезапустить проект Tomcat, перезапустить проект и зайти на страницу платформы, чтобы перенастроить пароль Redis.
2. распределенные сообщения об ошибках в кластере
2.1 Alluxio не запускается должным образом
2.1.1 Описание проблемы
Alluxio продолжает безуспешно запускаться.
2.1.2 Анализ причин
Неправильная конфигурация памяти компонента Spider.
2.1.3 Решения
Если вы самостоятельно настраивали память компонента Spider, вам необходимо снова изменить конфигурацию памяти.
2.2 Потеря сердцебиения хоста кластера Spider
2.2.1 Описание проблемы
Один из узлов кластера использует 100 % памяти, в результате чего другие мастера не могут подключиться к этому узлу, и сердечные ритмы теряются.
2.2.2 Анализ причин
Конфигурация памяти слишком мала.
2.2.3 Решения
Необходимо обновить аппаратную конфигурацию и увеличить объем памяти.
2.3 Невозможность запуска веб-кластера поверх кластера Spider
2.3.1 Описание проблемы
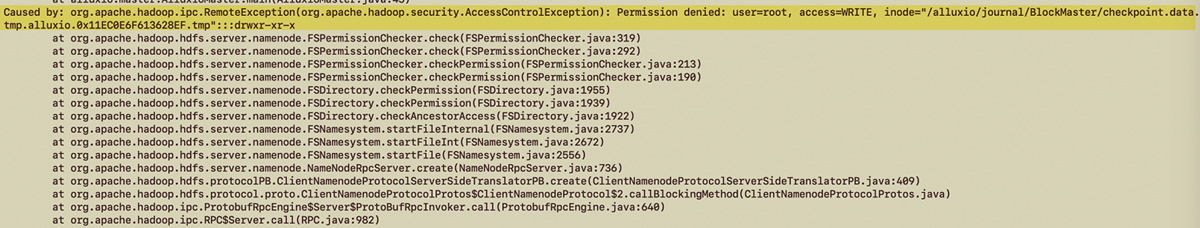
Web Cluster Dual Node может запустить только один узел, при обращении к другому узлу возникает ошибка, как показано на следующем рисунке:
2.3.2 Анализ причин
Проблема с правами доступа к папке Tomcat при запуске не корневым пользователем.
2.3.3 Решения
Для запуска кластера используйте пользователя root.
2.4 Зависание главного узла Spider Alluxio, недоступность всех шаблонов BI
2.4.1 Описание проблемы
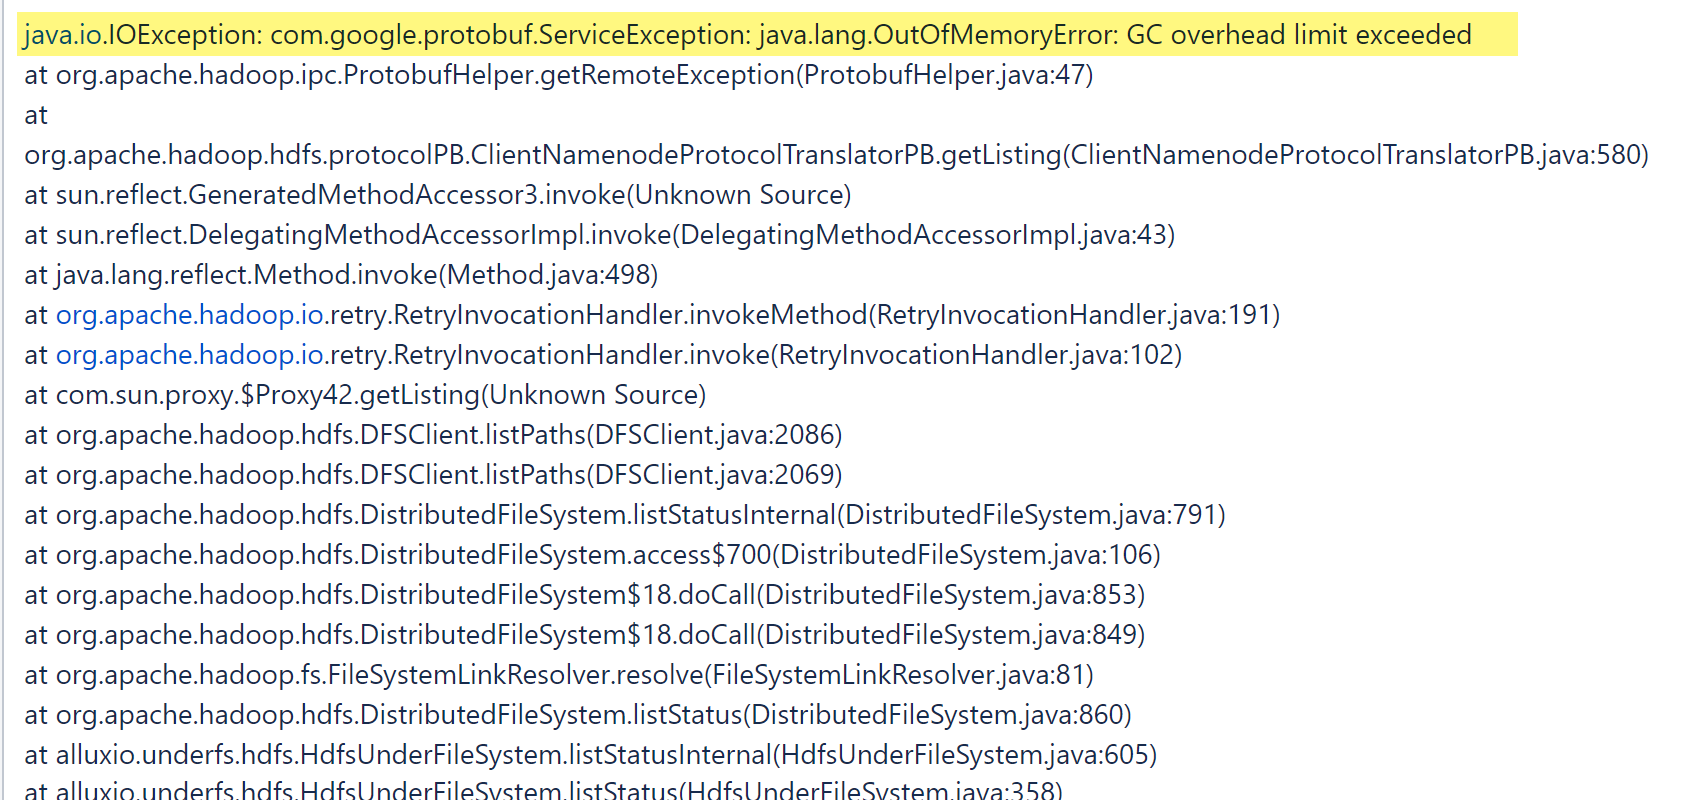
BI запрашивает отчет об ошибках и обнаруживает, что главный узел Alluxio завис, а в журнале главного узла появилась соответствующая ошибка oom. Как показано на рисунке ниже:
2.4.2 Анализ причин
Alluxio master выполняет команду hdfs с недостаточным количеством памяти при высокой нагрузке.
2.4.3 Идеи решений
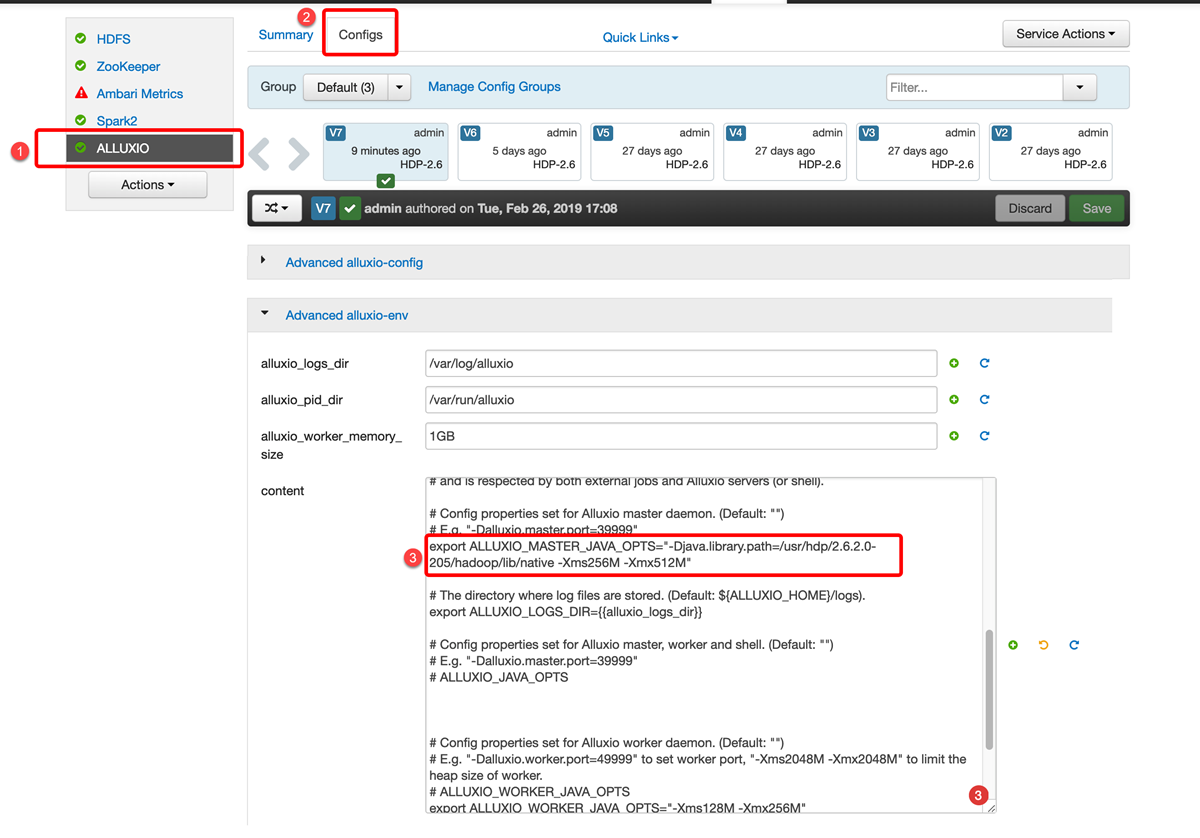
Alluxio Master должен увеличить память, найдитеALLUXIO_MASTER_JAVA_OPTS, если его там нет или он закомментирован, то добавьте его напрямую. Если его нет или он закомментирован, то добавьте его напрямую. Если он есть, то добавьте соответствующие параметры Xms и Xmx, и, наконец, нажмите кнопку Save, чтобы сохранить конфигурацию.
Как показано на рисунке ниже:
2.5 Предварительный просмотр шаблонов замедляется в кластере Spider
2.5.1 Описание проблемы
После создания кластера Spider, которым ежедневно пользуется множество людей, его использование приводит к блокировке задач spark, что приводит к замедлению предварительного просмотра шаблонов.
2.5.2 Анализ причин
Диски работают очень медленно, из-за чего дистрибутив не успевает за скоростью.
2.5.3 Решения
Обновление конфигурации оборудования.
3. Уведомление об исключениях из платформы
Кластер в целях содействия своевременному обнаружению и устранению проблем, для аномалий также будет исключение уведомления, уведомления, в том числе по электронной почте, SMS-уведомления, уведомления сообщения, платформы открыты кластера исключения предупреждение может быть получено.
| Причины аномалий | Содержание уведомления | Рецепт |
|---|---|---|
| Несогласованные пакеты jar | Узел #nodename# и узел #nodename# имеют разные jar-пакеты, что повлияет на стабильность кластерного проекта, пожалуйста, перейдите на страницу управления узлами кластера, чтобы проверить подробную информацию об исключениях, и своевременно устраните их. | Приведено в 1.2 |
| Предупреждения о выходе узла из кластера | Узел #nodename# был отсоединен от кластерной среды, возможные причины: узел FullGC, отказ узла, плохая связь между узлами, слишком высокая загрузка узла, другие аномалии. Во избежание негативных последствий для пользователей, пожалуйста, своевременно проверяйте состояние узла, если узел не может восстановиться самостоятельно в течение длительного времени, рекомендуется перезапустить узел. | Перейдите в интерфейс управления узлами кластера и проверьте, существует ли еще узел, о котором сообщалось как об отключенном.a. Если узел исчез, проверьте процесс приложения на сервере, если процесс все еще там, убейте его, а затем перезапустите, если процесс больше не существует, перезапустите проект узла напрямую;b. Если узел все еще существует, перейдите в раздел Intelligent Operation and Maintenance - Memory Management (Интеллектуальная эксплуатация и обслуживание - Управление памятью) или непосредственно на сервер, чтобы проверить занятость памяти/ЦПУ узла на предмет скачков, и перезапустите узел, если память/ЦПУ узла слишком высока;Два вышеупомянутых метода являются лишь временными решениями, и существует три общие причины отключения узла: частые FullGC из-за высокой нагрузки, скачки памяти/процессора из-за блокировки потоков и простои узла. |
| Несогласованность во времени между узлами | Если разница между системным временем узла #nodename# и узла #nodename# составляет более XX секунд, чтобы не повлиять на работу пользователей, пожалуйста, настройте время каждого узла так, чтобы оно оставалось одинаковым. | Проверьте, соответствует ли время на каждом узле, и сообщите об ошибке, если разница в системном времени между узлами превышает 30 с, поскольку несоответствие времени может повлиять на использование основных функций, включая вход в систему.windows система может вручную настроить системное время каждого узла, чтобы быть последовательным, Linux системы для настройки времени между узлами может обратиться к документу: Linux системы, как настроить согласованность времени каждого узла? |
| Исключения на узлах кластера Redis | Узел кластера Redis #ip:port# больше не доступен для использования, возможно, по причине: отказа узла, переполнения памяти или других аномалий. Чтобы не затронуть пользователей, перейдите на страницу конфигурации сервера состояния, чтобы проверить детали и своевременно разрешить ситуацию. | Приведено в 1.1 |
| Файловый сервер не работает | Возможные причины, по которым файловый сервер не может нормально считывать или записывать данные, следующие: файловый сервер не работает, диск переполнен или другие неполадки. Чтобы избежать проблем с пользователями, своевременно проверяйте состояние файлового сервера. | Если вы не можете подключиться к файловому серверу во время запуска, вы можете проверить состояние файлового сервера, открыть ли брандмауэр порты и т. д.Если эта ошибка возникает во время работы, устраните неполадки в трех направлениях:a. Проверьте состояние файлового сервера, чтобы узнать, не отключен ли он;b. Проверьте, можно ли по-прежнему нормально читать и записывать данные в настроенном каталоге WEB-INF;c. Проверьте оставшееся дисковое пространство файлового сервера, возможно, диск переполнен, что приводит к невозможности чтения и записи, если диск переполнен, необходимо расширить дисковое пространство. |
| Предупреждение о сбое синхронизации файлов | Кластерный узел #nodename# имеет несогласованные файлы с базовым узлом и не может быть автоматически синхронизирован. Пожалуйста, проверьте состояние этого узла | Как указано в разделе 1.3 данного документа |
4. Проблемы с обновлением данных BI
4.1 Обновление застряло, не удается остановить обновление после перезагрузки
4.1.1 Описание проблемы
Обновление одной таблицы застряло, после перезапуска страница выполнения обновления показывает, что она все еще обновляется.
4.1.2 Анализ причин
Если перезапускается только один узел, кластер не очистит прогресс обновления в сервере состояния Redis, для сброса прогресса обновления необходимо перезапустить весь кластер. Если перезапускается только один узел, задачи, которые выполнялись до этого, будут принудительно отменены, а задачи, которые не были запущены, продолжат обновляться.
4.1.2 Решения
Перезагрузите все узлы кластера после их отключения.
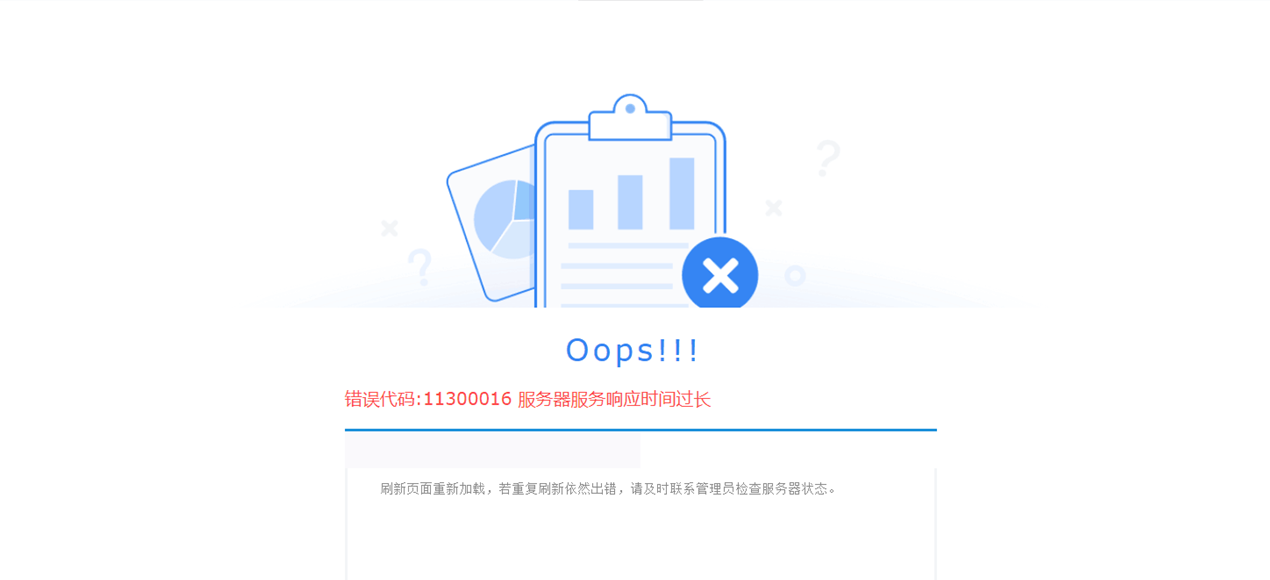
5. 11300016 Чрезмерное время отклика службы сервера
Решение в этом документе применимо к JAR-пакету для версии, выпущенной до 2020-01-15, 2020-01-15 и более поздние версии могут быть изменены непосредственно во внешних параметрах: конфигурация параметров кластера
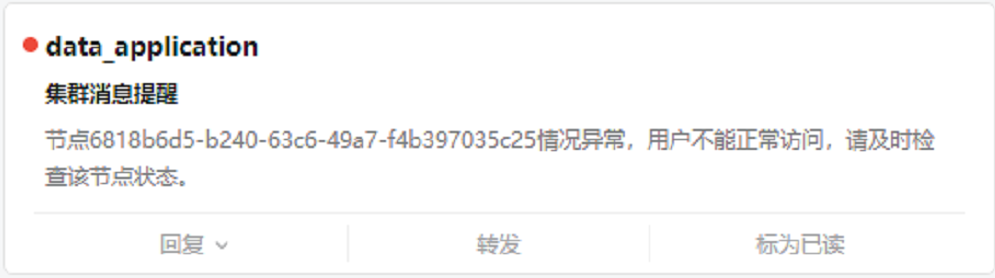
Чтобы решить проблемы, связанные с отказами одного узла в некоторых кластерных средах, мы оптимизировали "логику внутрикластерной пересылки". По умолчанию таймаут чтения/записи составляет 18 с, для некоторых пользователей этот параметр повлияет на доступ к шаблонам и они получат сообщение об исключении, если это так, вы можете настроить его в соответствии с этим справочным документом.
Описание проблемы:
1) Страница сообщений об ошибках:
2) Уведомление об исключении:
Решение:
Настройки можно выполнить, вручную вставив соответствующие поля и значения в таблицу fine_conf_entity базы данных конфигурации, как показано в следующей таблице:
| поле | Настраиваемые значения (в мс) | экзегеза |
|---|---|---|
| ClusterRedirectConfig.socketТайм-аут | 90000 | **Значение:**Время таймаута чтения и записи, если сервер не возвращает или не получает никаких данных в течение времени таймаута, это считается таймаутом, и администратор будет уведомлен о необходимости проверить состояние узла после 5 раз таймаута.**Рекомендации по настройке параметров:**Если шаблоны для вычислений или экспорта большого объема данных отсутствуют, рекомендуемая конфигурация - не более 90000 (в мс). Если есть шаблоны для вычислений или экспорта больших объемов данных, конфигурация основывается на самом длительном времени шаблона.**Описание:**Этот параметр соответствует параметрам nginx proxy_read_timeout и proxy_send_timeout и не должен превышать значения этих двух параметров в nginx. |
6. некоторые узлы веб-кластера застряли
Описание проблемы:
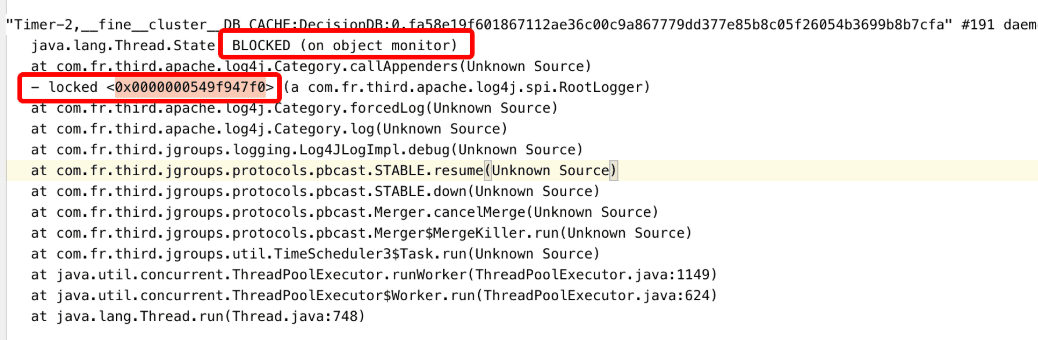
Один из узлов кластера застрял, и журнал, выводимый в фоновом режиме, содержит: BLOCKED (на мониторе объекта), заблокирован <0x0000000549f947f0>. Как показано на рисунке ниже:
Анализ причин:
Эта проблема связана с тем, что все потоки используют одну и ту же Категорию, и когда потоков, пишущих журналы, слишком много, некоторые потоки блокируются, но тот, что на рисунке выше, блокируется после получения блокировки, что приводит к тупику;
Решение:
В настоящее время из-за необходимости обеспечения совместимости с jdk1.6 невозможно использовать более высокую версию log4j, поэтому эту проблему можно решить только путем настройки уровня журнала. Перейдите в раздел Management System > Intelligent O&M > Platform Logs и установите уровень системного журнала на error, как показано ниже:
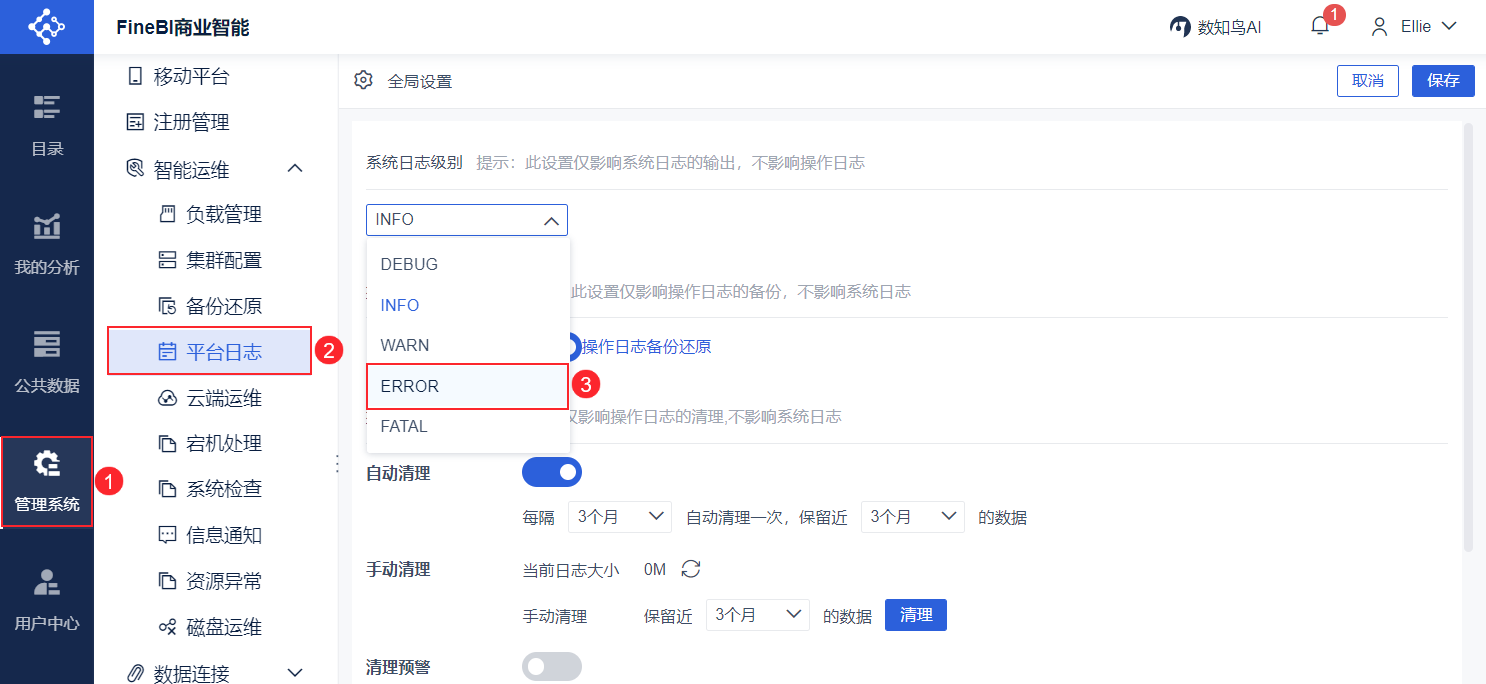
Просто перезапустите узел владельца карты после настройки;
7. наборы данных ожидают обновления
Описание проблемы:
Пользовательский проект версии 5.1.1, кластер redis, как глобальное обновление, так и обновление одной таблицы всегда ожидают обновления, в журнале сообщается только об ошибке:
cannot find class java.lang.ClassNotFoundException: com.fr.plugin.db.json.core.JSONConnection
Анализ причин:
Вызванные грязные данные redis.
Решение:
- Программа I: Работы по модернизации
Достаточно обновить проект до версии 5.1.3 и выше.
- Вариант 2: Очистите грязные данные redis
Примечание: Будьте осторожны при выборе метода flushall, если в Redis хранятся очень важные данные.
cd /usr/redis/redis-5.0.4/src #Доступ к корневому каталогу redis и внесение в него соответствующих изменений redis-cli -p port -a password #Запуск клиента flushdb #Метод 1: промыть текущий кэш базы данных redis flushall & nbsp;# Способ 2: промыть весь кэш redis.