Оформление
EARLIER - получить значение текущей строки (используется только для DEF-подобных функций)
1. Обзор
[helpvideo]5521[/helpvideo]### 1.1 Введение в функции
EARLIER : Получить значение текущей строки. Может использоваться только в функции DEF, обычно применяется для межстрочной фильтрации.
| словарь | РАНЬШЕ (параметры) | Получите значение ячейки на пересечении "Текущей строки" и "Столбца поля параметров". |
|---|---|---|
| параметрический | полевой столбец | Параметры EARLIER представляют собой отдельные поля и не поддерживают константы в качестве параметров. |
1.2 Примечания
**Описание проблемы:**При обновлении данных происходит сбой обновления с ошибкой "Во время обновления обнаружено неравенство более ранней функции, что приводит к серьезному расширению вычисленных данных и операция прерывается, пожалуйста, проверьте более раннюю функцию в формуле, устраните неравенство более ранней или контролируйте размер объема данных ".
**Анализ причин:**предыдущая функция имеет ограничения по объему данных в исходной таблице, если объем данных исходной таблицы превышает1000000, возникает ошибка.
**Решение:**Пожалуйста,используйте другие функции или контролируйте данные нижней таблицы в пределах 1000000.
2. Пример - Получение неверного значения строки
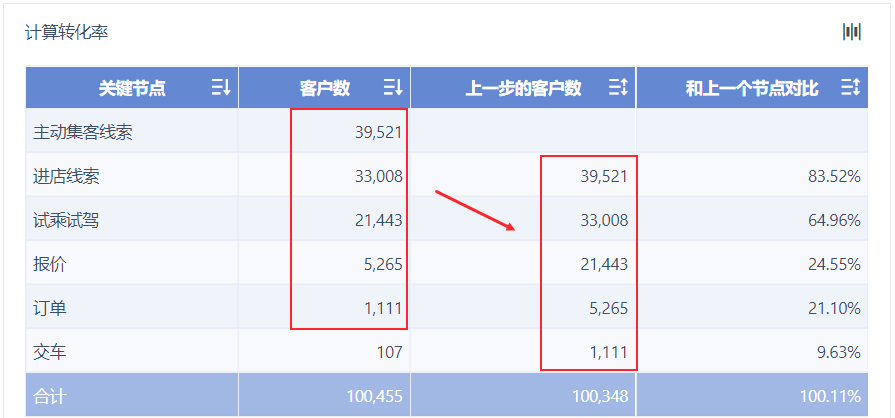
Бывают случаи, когда нам нужно получить неверные значения строки, например, вычислить разницу между предыдущей и следующей датой или рассчитать коэффициент конверсии от предыдущих данных к следующим.
Здесь приведен пример расчета коэффициента конверсии, нам нужно получить значение "предыдущей строки", чтобы было проще разделить два столбца.
1) Загрузите образец данных: Воронка продаж в автомобильной промышленности.xlsx
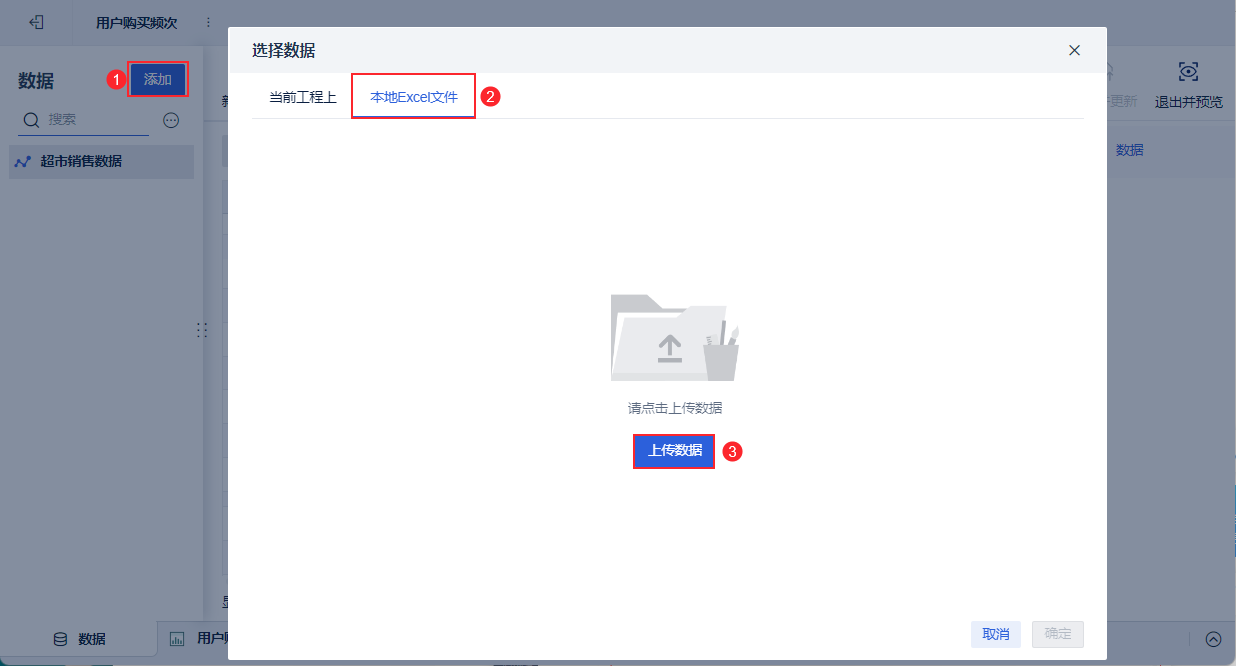
Загрузите загруженные данные в тему анализа, как показано ниже:
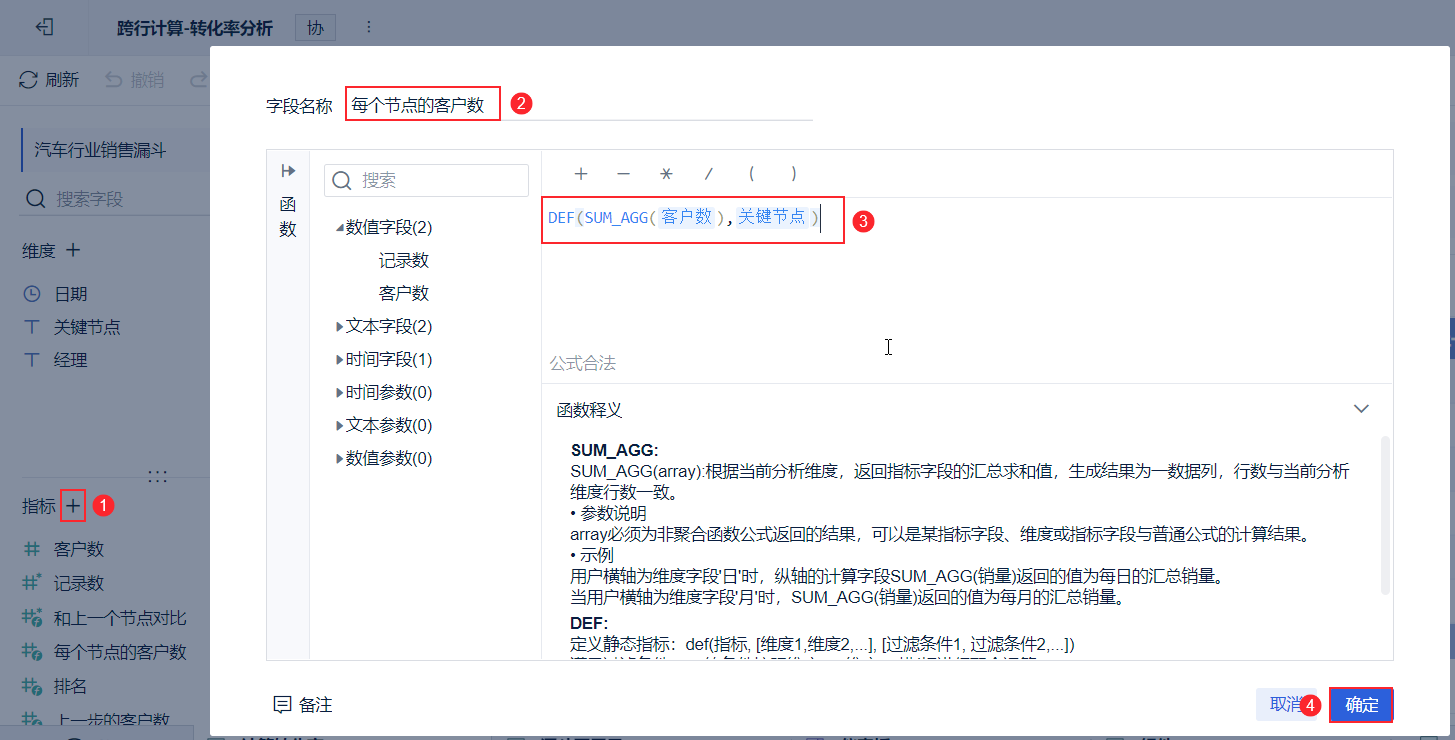
2) Найдите количество клиентов на узел и добавьте вычисляемое поле, как показано ниже:
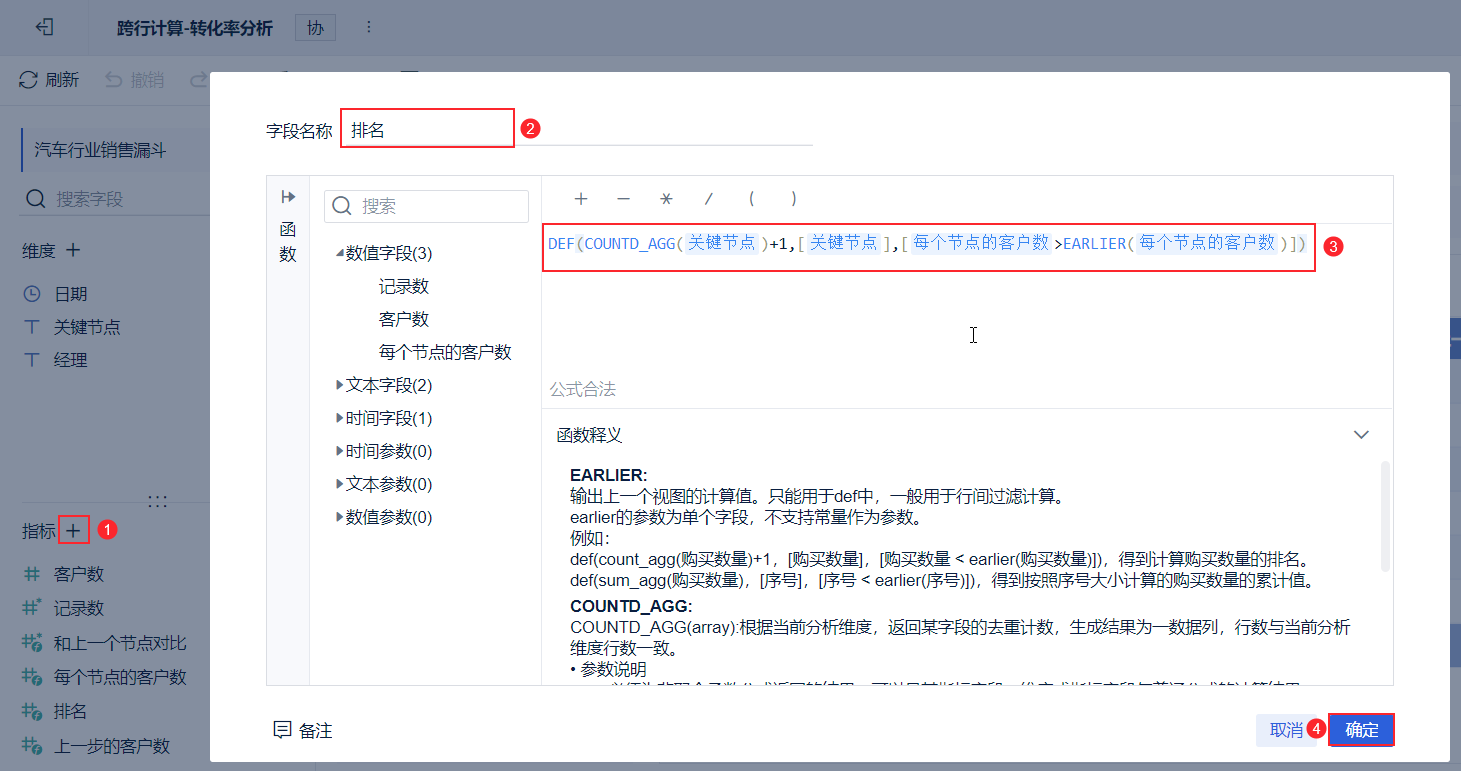
3) Сначала проранжируйте эти узлы по количеству клиентов, так как эти узлы имеют прямую и обратную связь, чем больше клиентов, тем больше этих узлов впереди.
| формулы | описания |
|---|---|
| DEF (COUNTD_AGG(ключевой узел)+1,[ключевой узел],[количество клиентов на узел > EARLIER(количество клиентов на узел)]) | * Обозначение размеров: ключевые узлы * Расчет метрик агрегации: COUNTD_AGG (ключевой узел) +1 * Условие фильтрации: количество клиентов на узле > EARLIER(количество клиентов на узле), означает отфильтровать все узлы, количество клиентов которых больше, чем "количество клиентов текущего узла". Если количество клиентов больше, чем количество клиентов текущего узла, будет вычислено COUNTD_AGG(ключевой узел)+1. |
После перетаскивания "Ранжирования" в область анализа можно проверить, корректен ли результат расчета "Ранжирования".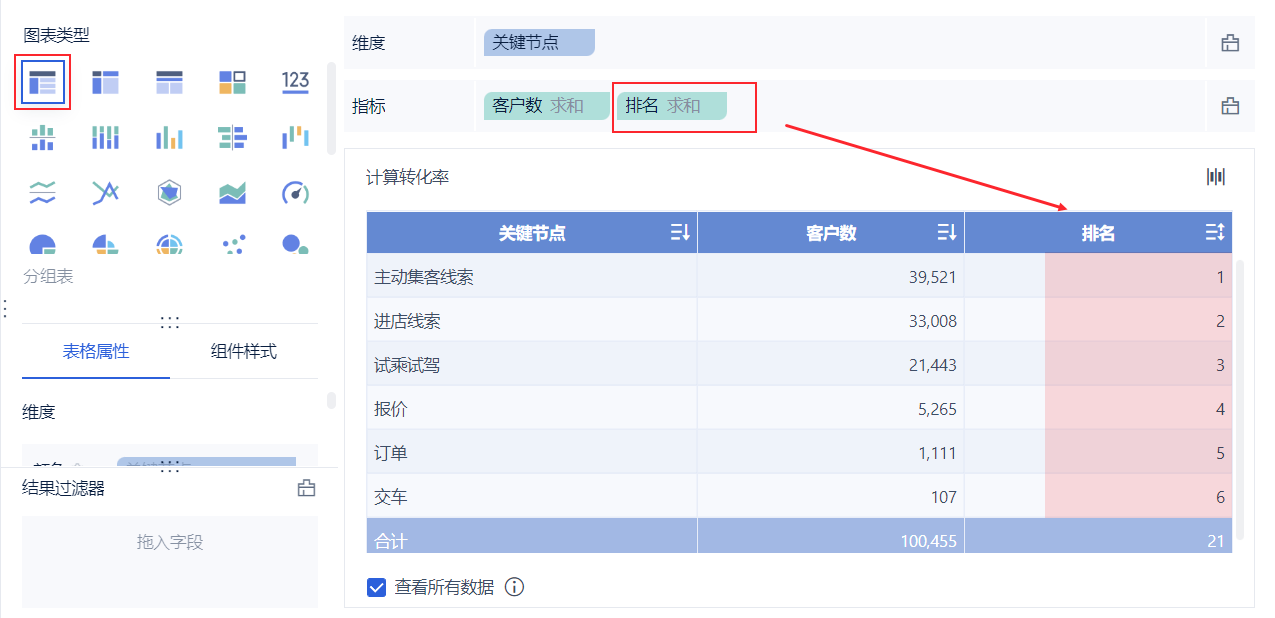
4) Вычислите количество клиентов предыдущего узла текущего узла, как показано ниже:
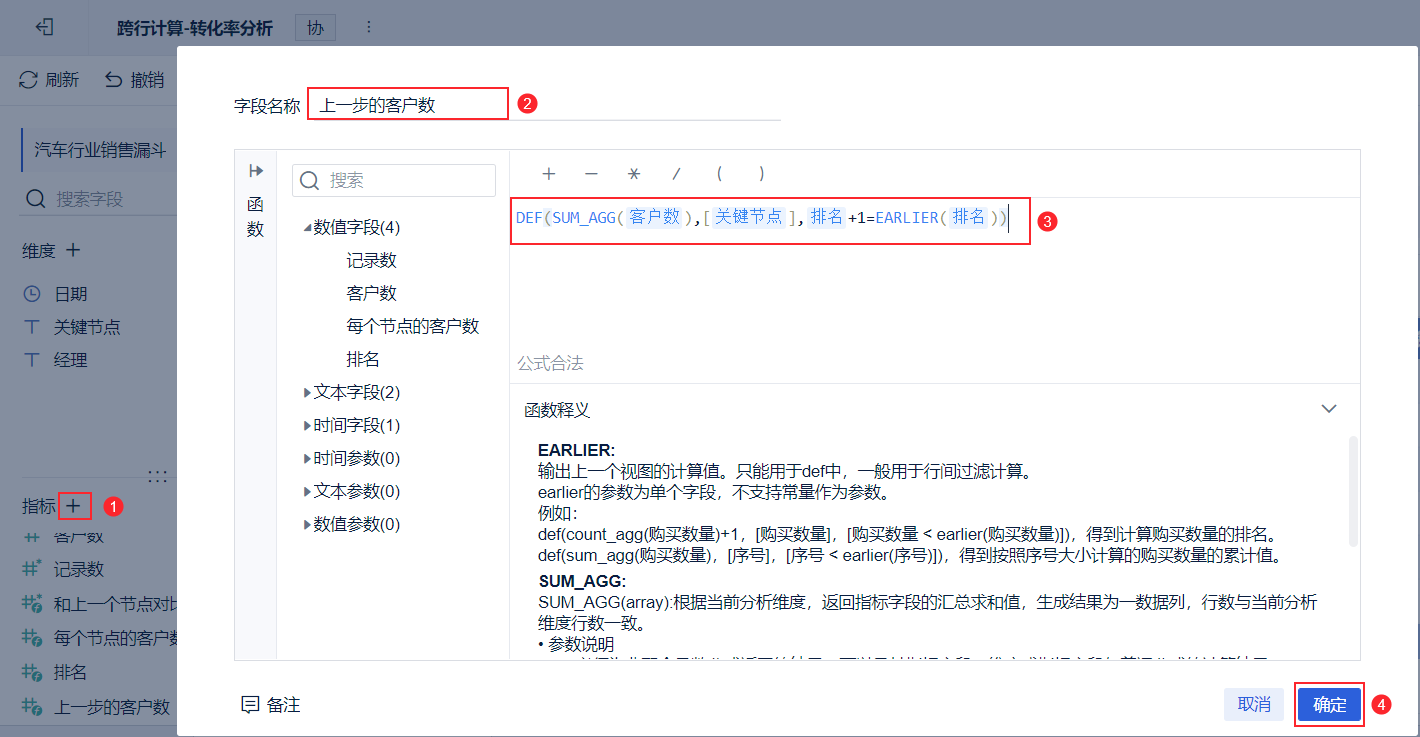
| факторизация | описания |
|---|---|
| SUM_AGG (количество клиентов) | Общее количество запрошенных клиентов |
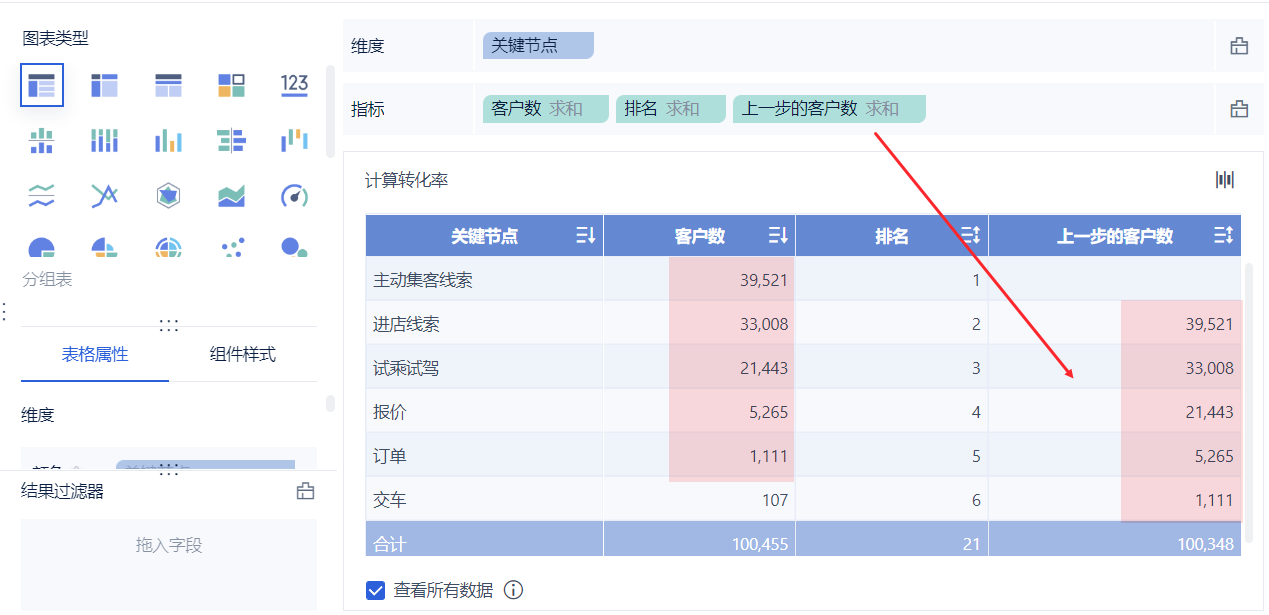
| DEF (SUM_AGG(количество клиентов), [ключевой узел] ,rank+1=EARLIER(rank)) | * Обозначение размеров: ключевые узлы * Расчет агрегированного показателя: SUM_AGG (количество клиентов) * Фильтр по: Ранг+1=Ранг(Ранг) Условие фильтрации - Rank=EARLIER(Rank)-1, отфильтруйте узел, который имеет значение -1, чем "текущий ранг строки", получите количество клиентов этого узла и просуммируйте его. |
Перетащите "Количество клиентов из предыдущего шага" в область анализа, чтобы проверить правильность результатов расчета. Как показано на рисунке ниже:
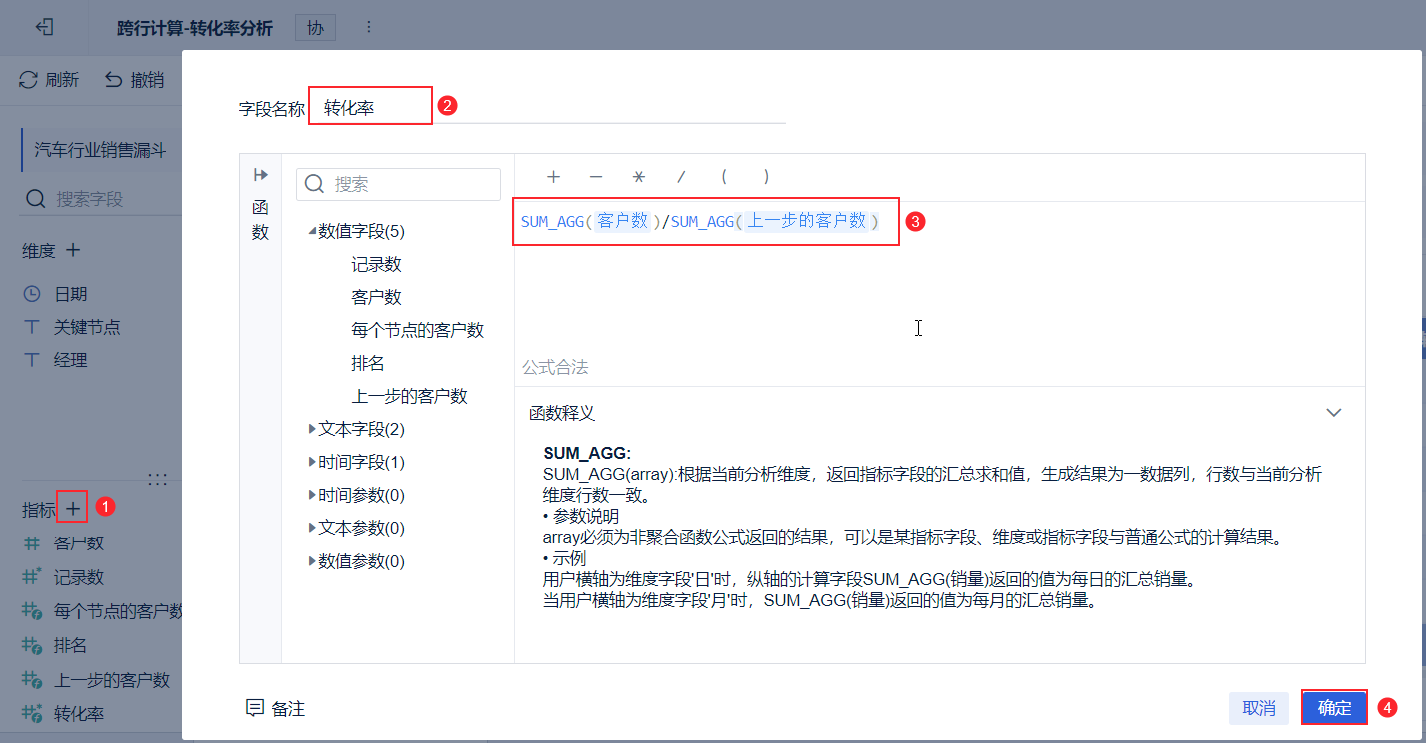
5) Рассчитайте коэффициент конверсии, используя формулу: количество клиентов на предыдущем шаге / количество клиентов на узел, можно найти. Как показано на рисунке ниже:
6) Перетащите "Коэффициент конверсии" в область анализа и измените формат значения на процентный. Как показано на рисунке ниже:
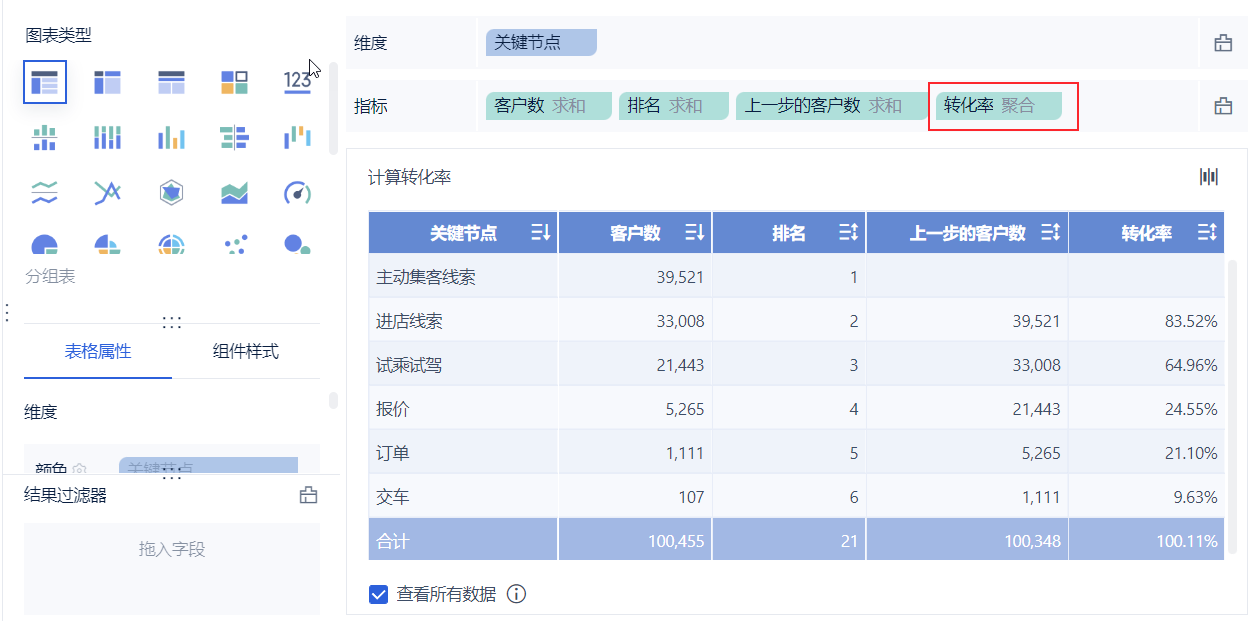
На этом мы завершаем анализ коэффициента конверсии