Оформление
Ручная настройка высокодоступных кластеров извлечения для систем Linux
1. Обзор
В этой статье описывается, как вручную настроить высокодоступный кластер извлечения на системе Linux.
Если вы планируете развернуть экстракционный кластер FineBI 6.0, пожалуйста, свяжитесь с технической поддержкой Sapphire или торговым представителем Sapphire для предварительной оценки и подтверждения информации о среде.
Контактная информация технической поддержки: " Сервисная платформа>Онлайн-поддержка ", Тел: "400-811-8890".
Если вы не обращались в Sailsoft и развернули кластер извлечения самостоятельно, нет никакой гарантии, что вы сможете вовремя справиться с неизвестными рисками.
2. Подготовительные шаги
Прежде чем вручную настраивать кластер высокой доступности, заранее подготовьте следующее.
| процедура | инструкции | |
|---|---|---|
| 1 | Подготовка серверной среды | Подготовка инженерных узлов + балансировка нагрузки + сервер состояния + файловый сервер + библиотека конфигурации Среда развертыванияОбеспечение совместимости интрасети между узлами проекта и серверами, на которых размещены компонентыУбедитесь, что системное время сервера, на котором расположен каждый узел и компонент проекта, совпадаетРекомендуемая среда: Рекомендуемая среда для инженерного развертыванияПоддерживаемые среды: среда поддержки развертывания инженерных кластеров |
| 2 | База данных развертывания | Разверните базу данных в качестве внешней резервной базы данных для проекта, отдавая предпочтение рекомендованной высокодоступной первичной базе данных в режиме резервного копированияПользователю нужно только развернуть и запустить базу данных.Поддерживаемые типы баз данных см. в разделе:Настройка внешних баз данных |
| 3 | Развертывание балансировки нагрузки | Развертывание балансировки нагрузки, рекомендуемый план развертывания Keepalived + NginxВам нужно только установить и настроить Keepalived, установить NginxНе нужно запускать, не нужно изменять конфигурационный файл nginx.confСправочный документ: План развертывания Keepalived + Nginx |
| 4 | Сервер состояния развертывания | Развертывание серверов с поддержкой состояния, рекомендуемые кластеры RedisУбедитесь, что кластер Redis запущен и работает, рекомендуется 6 узлов на 6 серверах!Справочные документы: установка системы Linux настройка кластера Redis |
| 5 | Развертывание файловых серверов | Развертывание файловых серверов, рекомендуется NAS |
| 6 | Развертывание инженерных узлов | Сначала разверните только один узел проекта, не запускайте проект. Метод развертывания см. в разделе "Развертывание пакета развертывания" или "Автономное развертывание" для автономного развертывания.* Пакет развертывания Tomcat Server для Linux * Автономное развертывание сервера Tomcat на Linux |
3. Настройте и запустите проект
3.1 Настройка системных параметров Linux
Для Linux необходимо изменить три системных параметра, чтобы обеспечить правильную работу последующих кластеров извлечения.
3.2 Настройка ведения журнала Redis
Для кластеров с извлечением FineBI 6.0 сервер состояния Redis является более важным компонентом, который необходимо настроить на ведение журнала, чтобы облегчить устранение неполадок в будущем.
В файле redis.conf протоколирование настроено по умолчанию: logfile ""
Добавить/изменить в: файл журнала "redis.log"
Журналы автоматически генерируются в каталоге src после настройки.
3.3 Новые свойства spider.cluster.properties (необязательно)
Если вам нужно настроить конфигурацию, например порты, вы можете выполнить операции в этом разделе. Если настройка не требуется, этот раздел можно пропустить.
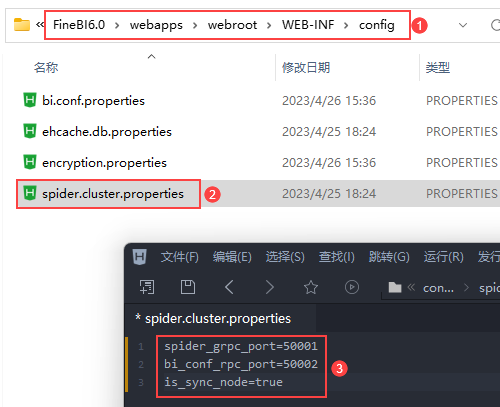
В каталоге %BI_HOME%\webapps\webroot\WEB-INF\config создайте новый файл spider.cluster.properties.
Файл содержит три строки:
| Содержание установки | инструкции |
|---|---|
| spider_grpc_port=xxx | Установите порт rpc движка паука, если он не настроен, по умолчанию используется порт 50051.Просто убедитесь, что настроен свободный и доступный порт. |
| bi_conf_rpc_port=xxx | Установите rmi только что настроенного фреймворка, если он не настроен, то по умолчанию используется порт 50200Просто убедитесь, что настроен свободный и доступный порт. |
| is_sync_node=true | Установите свойства узла проекта, если они не заданы, то по умолчанию используется узел синхронизацииfalse: несинхронизированный узелtrue: синхронизированный узел |
3.4 Запуск и вход в платформу
Запустите этот узел проекта FineBI.
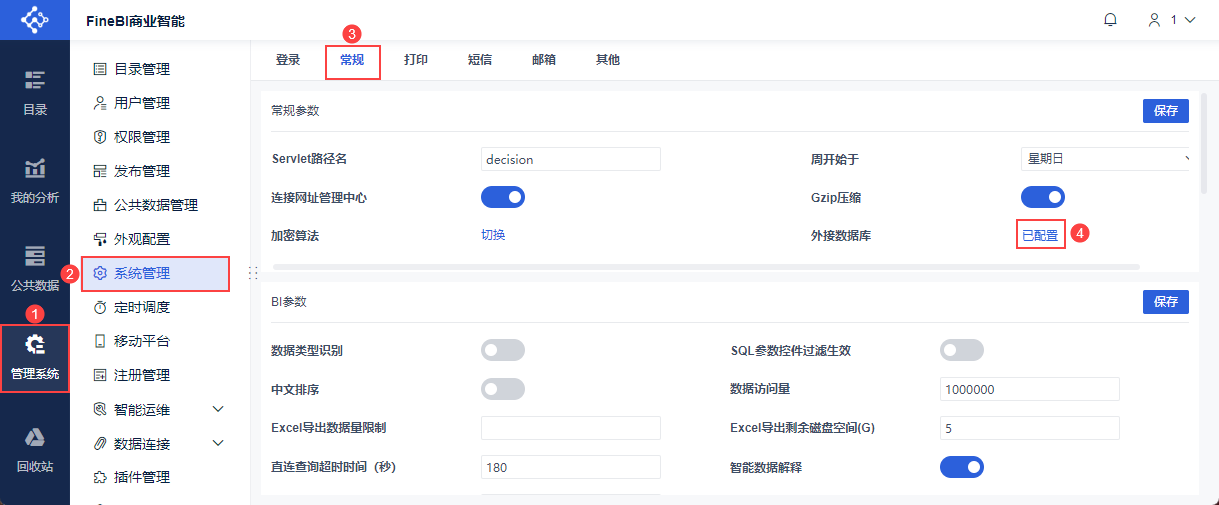
1) Убедитесь, что внешняя база данных настроена
Администратор входит в систему FineBI и нажимает "System Management > Управление системой > Общие > Внешняя база данных", чтобы убедиться, что в системе настроена внешняя база данных.
В качестве внешней базы данных finedb в кластерах с высокой доступностью рекомендуется выбирать высокодоступную базу данных первичной резервной схемы.
2) Установка плагинов
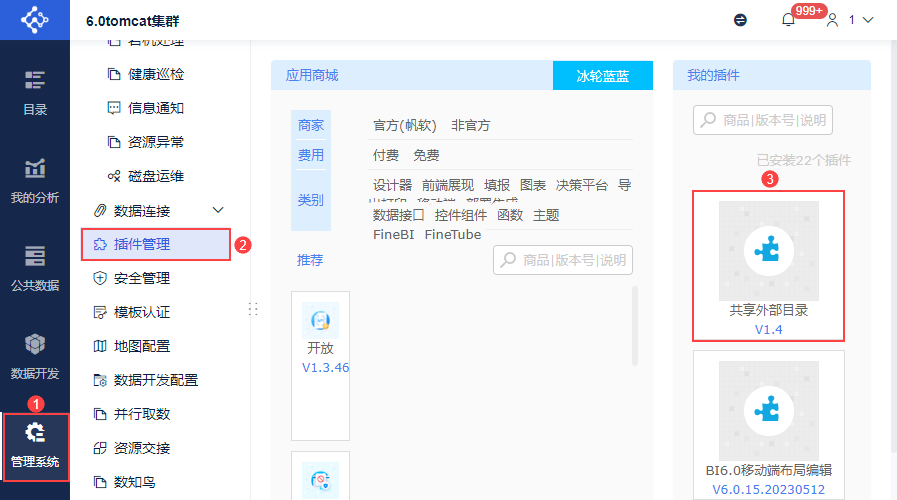
Рекомендуемая настройка согласованности файлов для кластеров высокой доступности - NAS.
В версии 6.0.15 и более поздних эта функция встроена напрямую и может быть использована без установки плагина.
До версии 6.0.15 эта функциязависит отплагина"Shared External Directory".Пожалуйста, проверьте, существует ли этот плагин в разделе "System Management > Управление плагинами", если нет, установите его заранее.
- Загрузить плагины можно по адресу: Shared External Catalogue
- Об установке плагинов см. раздел: Управление плагинами
3) Войдите в интерфейс конфигурации кластера
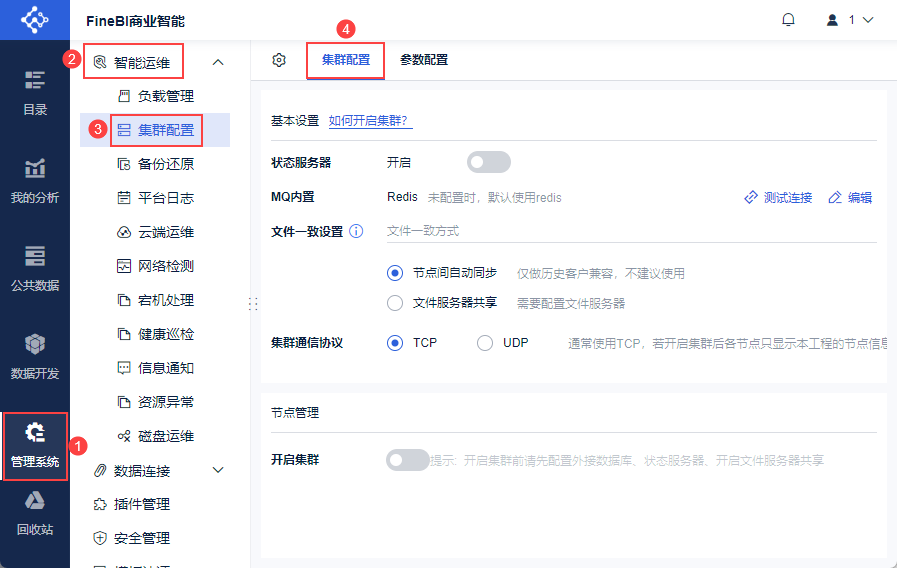
Администратор входит в систему Data Decision System и нажимает на "Management System > Intelligent O&M > Cluster Configuration".
Все описанные ниже операции по настройке выполняются на этой странице.
4. Настройка сервера состояния
Подготовьте контент:
Сервер состояния для высокодоступных кластеров рекомендует использовать кластер Redis в качестве сервера состояния.
- Сначала убедитесь, что кластер Redis работает, иначе проект не сможет успешно подключиться к нему.
- Подготовьте пароль для кластера Redis (если у вас его нет, можете его не указывать; если вы настроили пароли Redis, вам нужно будет использовать один пароль для каждого узла Redis).
- Подготовьте IP-адрес хоста и номер порта каждого узла кластера Redis (доменное имя не рекомендуется, подготовьте IP-адрес внутренней сети).
Шаги конфигурации:
1) Включите кнопку "Сервер состояния".
2) Выберите систему кэширования как "Redis Cluster".
3) Если у вас есть пароль, введите его; если у вас нет пароля, проигнорируйте этот шаг.
4) Добавьте узлы в соответствии с количеством узлов кластера Redis. Введите IP-адрес и порт хоста для каждого узла.
5) После настройки нажмите кнопку "Проверить соединение и сохранить", если нет никаких отклонений, он может быть успешно сохранен.
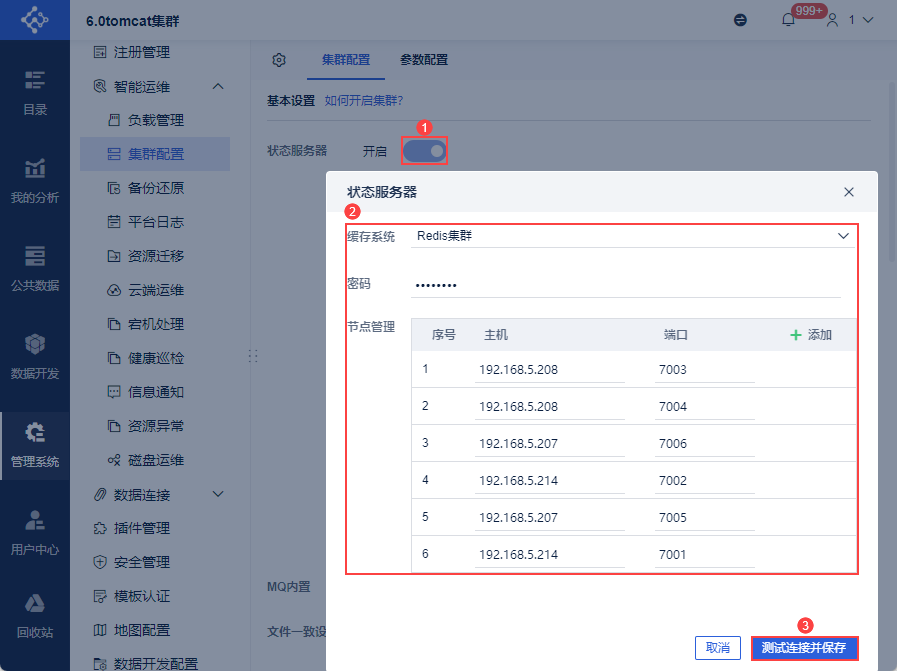
Предварительный просмотр эффектов:
Успешно открытый сервер состояния показан на следующем рисунке:
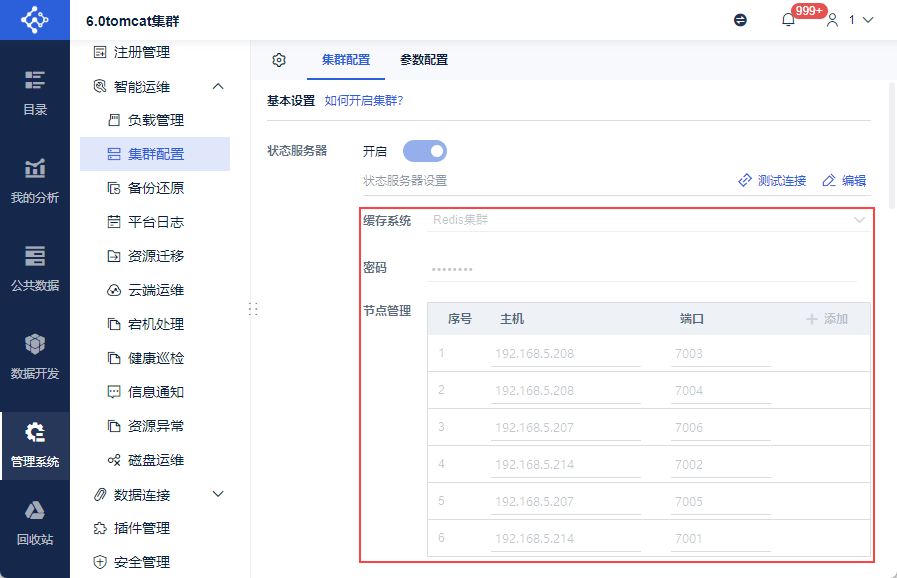
5. Настройте встроенный MQ
Встроенные функции MQ предназначены для "контейнерного развертывания" кластеров, при неконтейнерном ручном развертывании кластеров не нужно обращать внимание на этот шаг, его можно сразу пропустить.
Контейнерное развертывание Компонент rocketmq обычно настраивается по умолчанию в установленном проекте. rocketmq заменяет некоторые функции очереди сообщений Redis.
- Если rocketmq не настроен, по умолчанию используется redis.
- Если настроен rocketmq, то rocketmq и redis действуют одновременно и отвечают за разные функции.
6. Файловый сервер конфигурации
Подготовьте контент:
Рекомендуется выбрать "Общий доступ к файловому серверу > Общий внешний каталог" для настроек согласованности файлов в кластере высокой доступности.
- Сначала убедитесь, что сервер состояния из главы 4 успешно настроен, иначе настроить файловый сервер не удастся.
- Сначала убедитесь, что файловый сервер NAS работает, иначе проект не сможет успешно подключиться к нему.
Шаги конфигурации:
1) Скопируйте папку %FR_HOME%\webapps\webroot\WEB-INF этого узла проекта на файловый сервер.
2) Дайте права на папку WEB-INF на файловом сервере, 777 в Linux.
3) Скопируйте адрес пути к папке WEB-INF на файловом сервере, например /data/nfs/WEB-INF.
4) Выберите "Общий доступ к файловому серверу" для настроек согласованности файлов.
5) Во всплывающем окне соглашения выберите "Общий внешний каталог".
6) Установите путь к папке WEB-INF на файловом сервере, скопированной на третьем шаге.
7) После настройки нажмите "Проверить соединение и сохранить", если нет никаких отклонений, он может быть успешно сохранен.
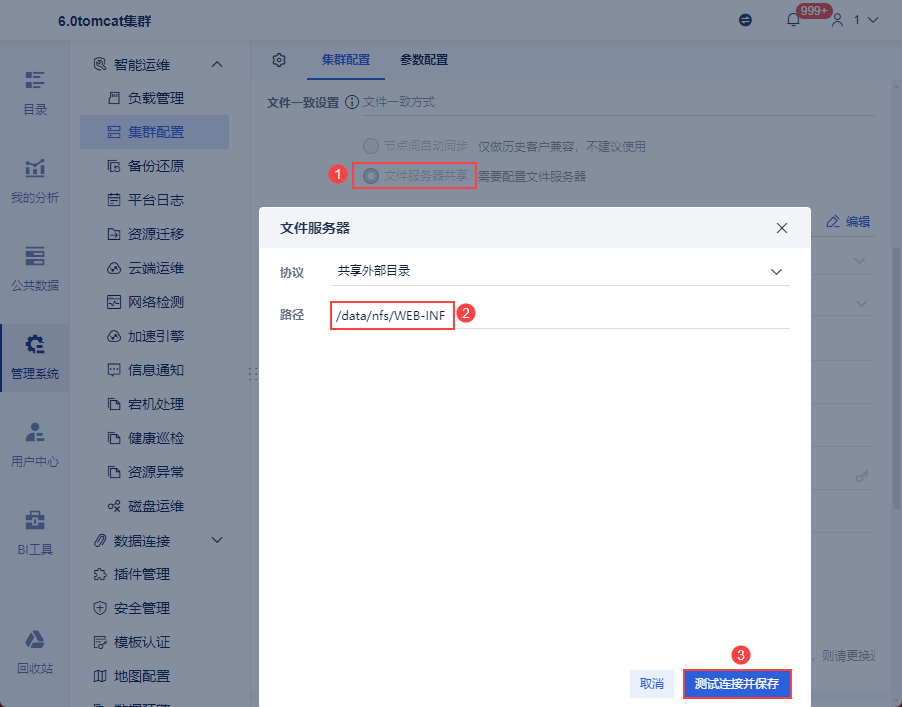
7. Настройка режима кэширования
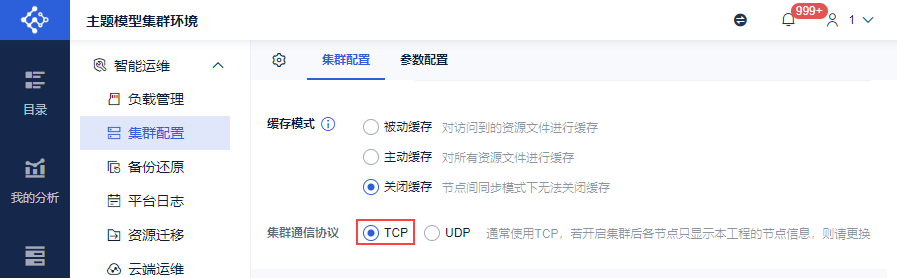
Рекомендуется выбрать "Cache Off" для режима кэширования в кластере высокой доступности.
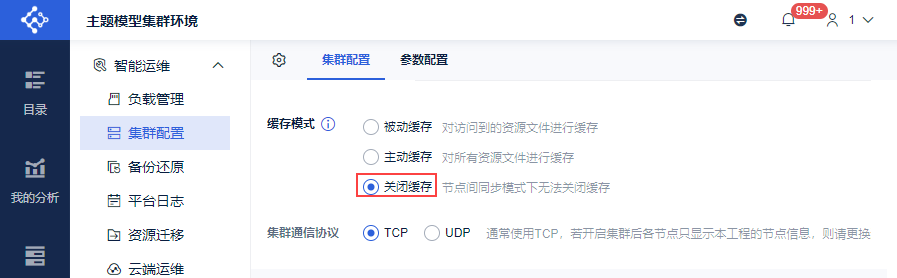
8. настройка протоколов связи кластера
Для кластеров с высокой доступностью рекомендуется выбирать протокол связи "TCP".
9. Подтвердите успешную настройку одноузлового кластера
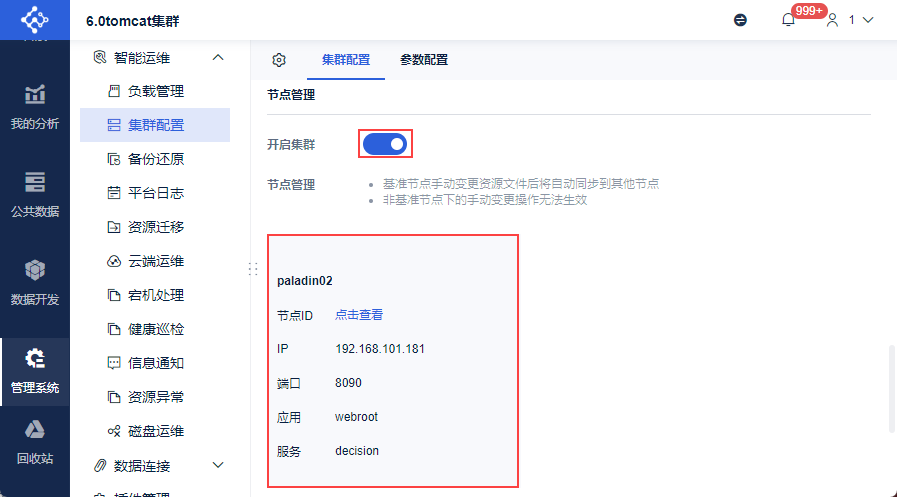
1) Включите кнопку "Включить кластер".
2) Перезапустите проект узла.
3) Снова проверьте "Management System > Intelligent O&M > Cluster Configuration", и этот узел проекта появится в службе управления узлами.
На этом этапе стыковка узла проекта с внешней базой данных, сервером состояния и файловым сервером полностью завершена, и одноузловой кластер успешно развернут.
10. Настройка многоузловых проектов
1) Разверните другие инженерные узлы кластера
Методы развертывания описаны в разделе "Развертывание пакета развертывания" или "Автономное развертывание" для автономного развертывания.
2) Скопируйте файлы проекта
Скопируйте папку %BI_HOME%\webapps\webroot автономного узла кластера выше и перезапишите папку %BI_HOME%\webapps\webroot каждого из других вновь развернутых узлов проекта.
3) Измените spider.cluster.properties (необязательно)
Если вам нужно настроить конфигурацию, например порты, вы можете выполнить операции в этом разделе. Если настройка не требуется, этот раздел можно пропустить.
В каталоге %BI_HOME%\webapps\webroot\WEB-INF\config каждого нового узла проекта найдите файл spider.cluster.properties и измените соответствующую конфигурацию.
| Содержание установки | инструкции |
|---|---|
| spider_grpc_port=xxx | Установите порт rpc движка паука, если он не настроен, по умолчанию используется порт 50051.Только убедитесь, что настроен свободный и доступный порт. |
| bi_conf_rpc_port=xxx | Установите rmi только что настроенного фреймворка, если он не настроен, то по умолчанию используется порт 50200Только убедитесь, что настроен свободный и доступный порт. |
| is_sync_node=true | Установите свойства узла проекта, если они не заданы, то по умолчанию используется узел синхронизации* false: несинхронизированный узел * true: синхронизированный узел Для кластеров с менее чем четырьмя узлами рекомендуется, чтобы все узлы кластера были настроены на trueДля кластеров с более чем пятью узлами рекомендуется, чтобы четыре узла были истинными, а остальные - ложными. |
4) Удалите файл cluster.properties
Найдите каталог %BI_HOME%\webapps\webroot\WEB-INF\config нового узла проекта и удалите файл cluster.properties, если он существует.
5 ) Перезапустите эти новые инженерные узлы.
11. Подтверждение успешной конфигурации многоузлового кластера
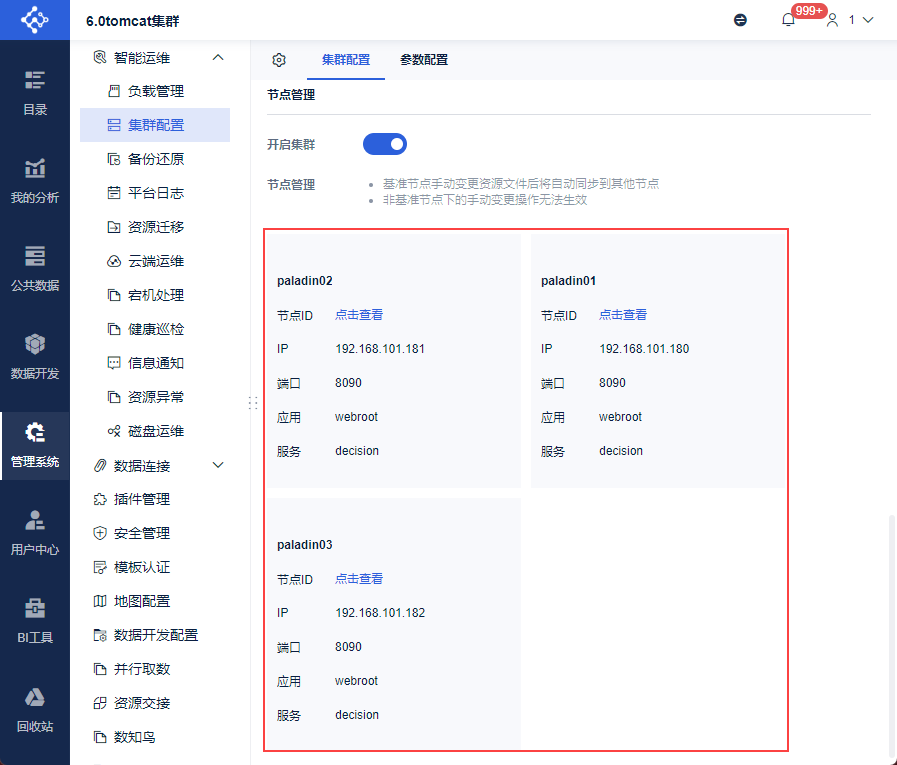
Администратор поочередно входит в каждый узел проекта и проверяет "Management System > Intelligent O&M > Cluster Configuration", после чего вся информация об узлах проекта появляется в Node Management Service.
На этом этапе стыковка всех инженерных узлов с внешними базами данных, серверами состояния и файловыми серверами полностью завершена, и развертывание многоузлового кластера прошло успешно.
12. Настройка балансировки нагрузки
Балансировка нагрузки может быть выполнена с помощью различных алгоритмов, распределяющих запросы пользователей по различным узлам для повышения производительности и балансировки нагрузки.
Keepalived+Nginx" рекомендуется для балансировки нагрузки в высокодоступных кластерах.
Сначала убедитесь, что вы обратились к документации по развертыванию:Keepalived+Nginx Deployment Scenarios
Шаги конфигурации:
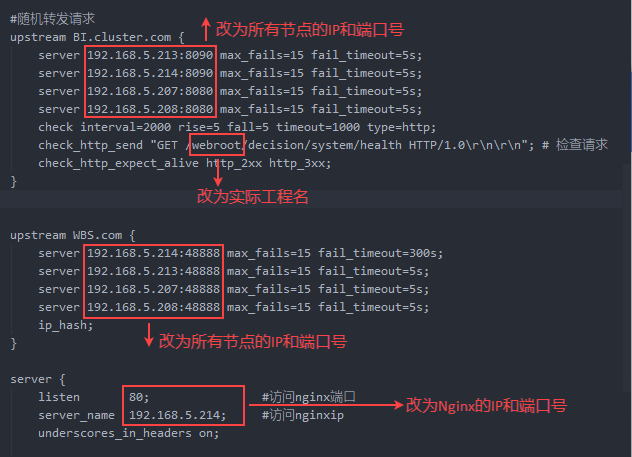
1) Измените файл nginx.conf
Используйте этот файл в качестве базового: extract cluster nginx.zip
Обратитесь к документу Изменение файла nginx.conf: Установка и настройка Nginx в системах Linux.
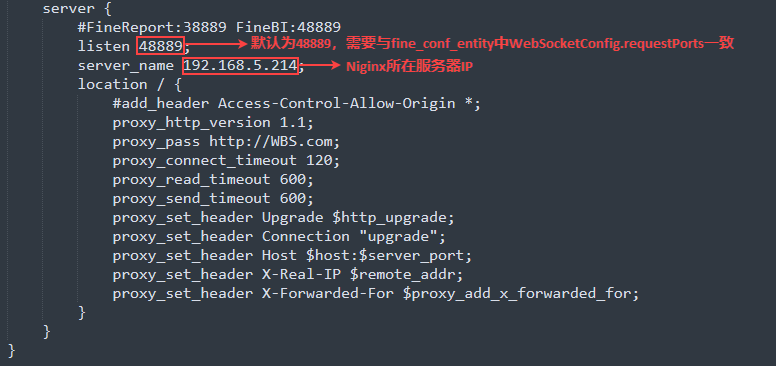
2) Перезапустите компонент Nginx.
13. Подтверждение успешной конфигурации кластера высокой доступности
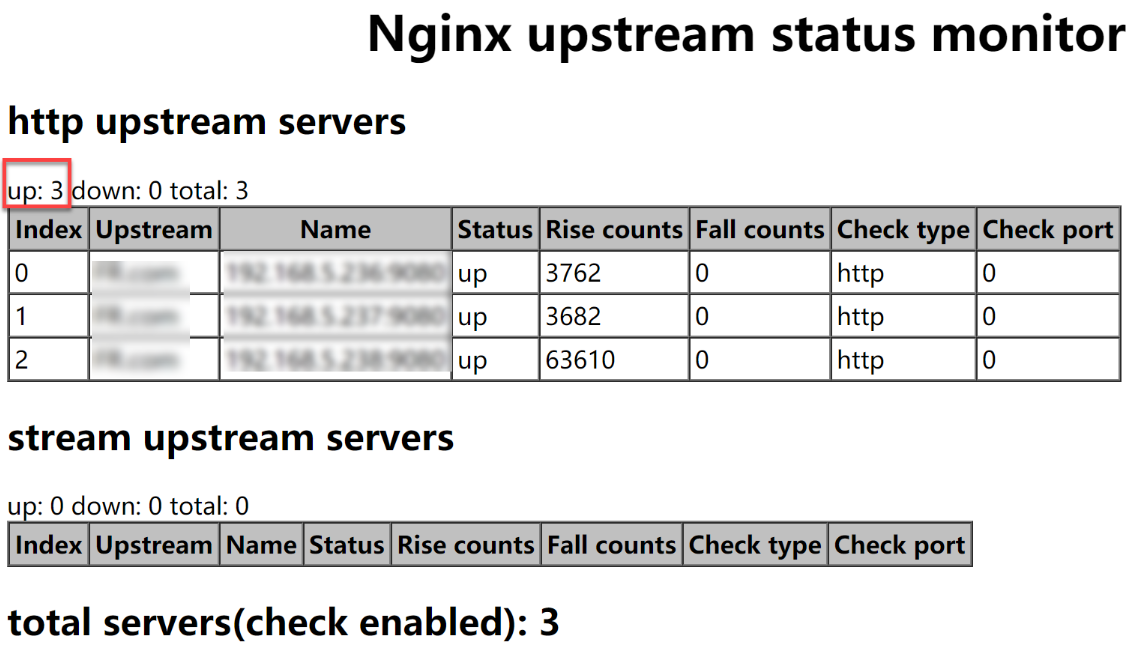
Наберите в браузереip:load balancing port number/status, чтобы увидеть состояние здоровья каждого узла проекта.
На этом этапе многоузловой кластер с высокой доступностью успешно развернут.
14. Убедитесь, что кластеры извлечения включены
Кластер извлечения автоматически вступает в силу после вступления в силу кластера высокой доступности.
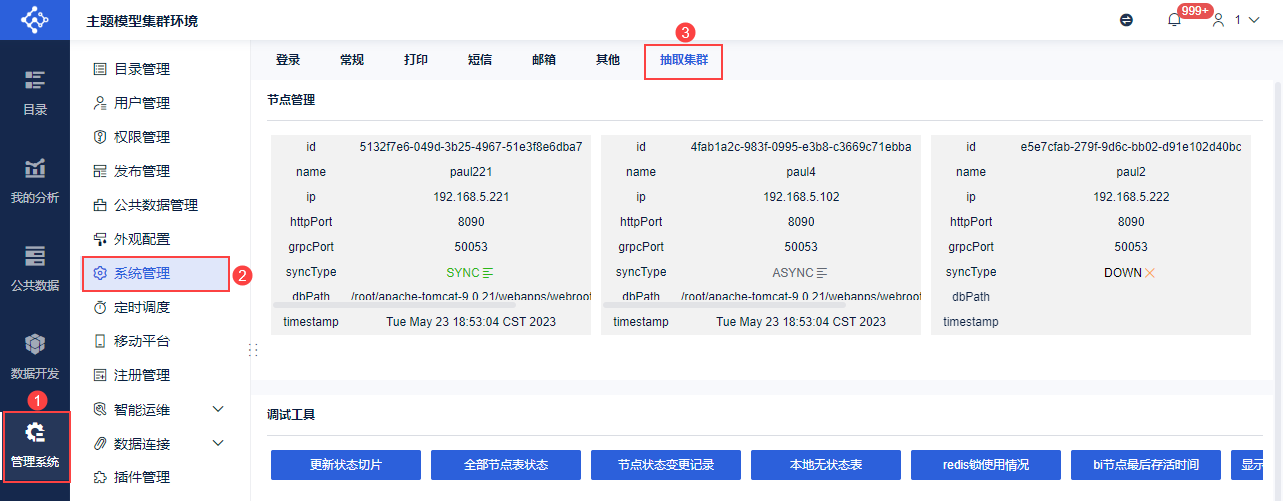
Администратор входит в FineBI и нажимает "System Management > Управление системой > Извлечь кластер", чтобы просмотреть информацию об узле.
SYNC - это синхронизированный узел, а ASYNC - асинхронный узел, конкретные инструкции см. в разделе: извлечение интерфейса управления кластером.
Пользователи могут пытаться добавлять, обновлять и запрашивать извлеченные базовые таблицы и наборы данных Self-service, и если никаких отклонений не происходит, это означает, что кластер извлечения успешно построен.
15. Следующие шаги
| следующий шаг | инструкции |
|---|---|
| Регистрация кластера | Если автономный проект был зарегистрирован изначально, то после перехода на многоузловой кластер его нужно будет зарегистрировать заново. |
| Руководство по усилению безопасности продукции | Справочная документация повышает безопасность продукции |
| Руководство по мониторингу эксплуатации и технического обслуживания | Справочная документация повышает стабильность эксплуатации и управления |
| Платформа для эксплуатации и технического обслуживания | Рекомендуется настроить инструменты Ops Platform для кластеров |