Оформление
Принцип объединения тематических моделей
1. Обзор
Изучив этот материал, вы поймете самую важную логику слияния в тематической модели. Это также самый важный принцип, который отличает тематическую модель от слияния слева направо и дает нам выигрыш в эффективности.
В этом посте также представлена логика слияния слева направо, чтобы сравнить ее с моделью темы и помочь вам лучше понять ее.
2. Логика слияния для лево-правых слияний
Слияние слева и справа - это слияние на уровне строк, которое объединяет таблицы путем совместного использования значений определенных столбцов. Давайте рассмотрим, как объединение слева направо объединяет данные.
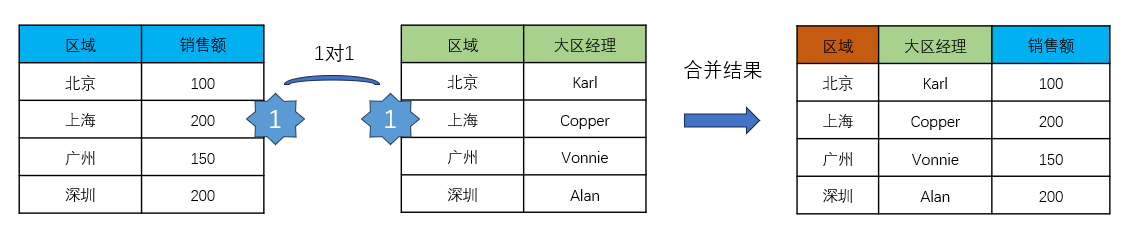
1) Слияние 1 к 1 очень простое, нам просто нужно объединить две таблицы по полю "регион" для левой и правой таблиц. Как показано на рисунке ниже:
2) Как происходит объединение N-to-1? В левой таблице есть две части данных для Пекина и две части данных для Гуанчжоу из-за добавления поля "Филиал".
Чтобы правая таблица была объединена с левой по признаку "регион", данные из Пекина и Гуанчжоу также нужно скопировать в две части данных. В результате объединения мы видим, что поле Region Manager раздуто, а ячейка с желтой меткой - это данные, которые были скопированы.
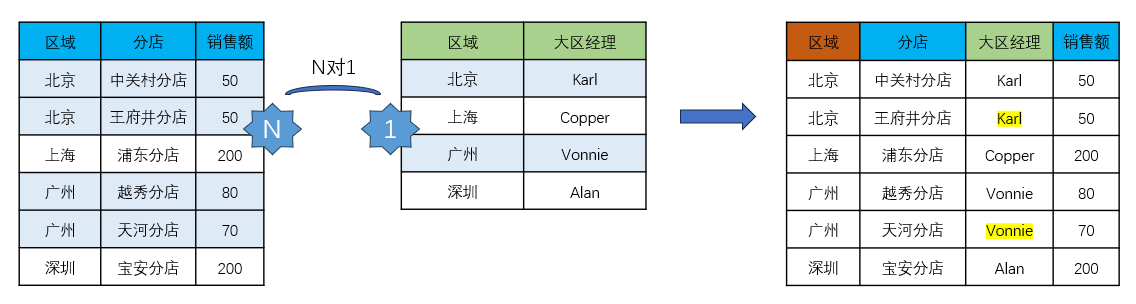
Размерные поля, такие как "Региональный менеджер", которые были скопированы выше, не влияют на наш анализ.
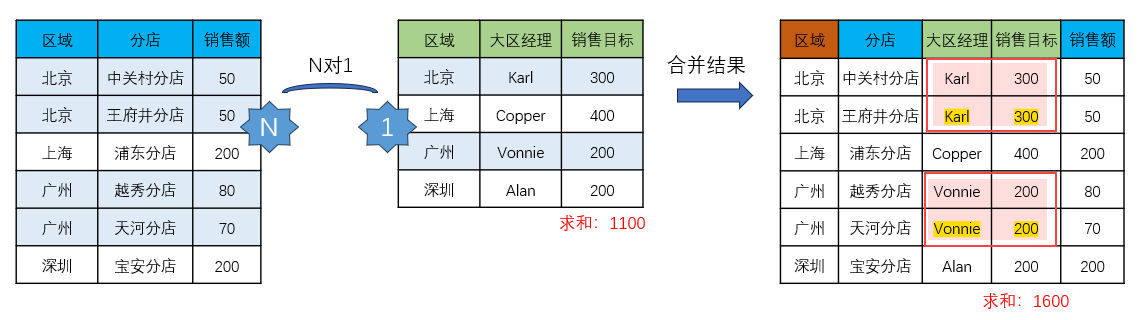
Однако если скопировать поля индикаторов, это повлияет на наши расчеты. Например, на изображении ниже поле "Цель продаж " также было скопировано, чтобы можно было установить соответствие.
В этот момент, если мы просуммируем столбец "Цель продаж" в таблице результатов, то обнаружим, что результат суммирования уже имеет неверное значение.
Подведем итог: повторение информации об измерениях не влияет на результаты, но повторение данных об индикаторах может вызвать проблемы с расчетами инфляции данных.
3) Эта репликация индикаторных полей приводит к полному хаосу, когда дело доходит до N to N.
При объединении слева и справа по полю "Регион" поле Beijing раздувается до 4 строк, вместе с ним копируется поле "Продажи, количество сотрудников", и в итогах стоят неправильные значения.
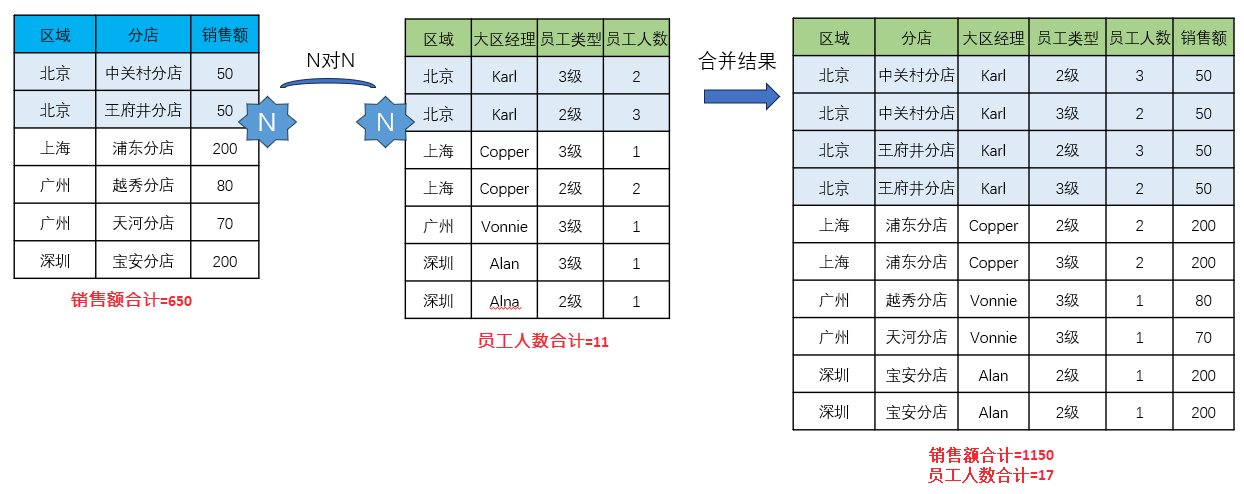
Таким образом, мы пришли к выводу, что объединение на уровне строк, такое как объединение слева направо (аналогичное объединению операторов SQL), приводит к репликации данных и раздуванию.
3. Логика консолидации для тематических моделей
Так в чем же заключается логика объединения в тематической модели и почему она не приводит к репликации и раздуванию данных?
Мы кратко изложим логику объединения в тематической модели в следующих двух пунктах:
- Привлекайте к объединению предметных моделей только те поля и связанные с ними поля, которые участвуют в анализе
- Выполните агрегирование перед объединением
Если разбить его на этапы, то их будет три:
① Система определяет, какие поля пользователь перетащил в компонент, и только перетащенные поля и связанные с ними поля участвуют в слиянии моделей тем;
② Последовательно агрегируйте таблицу данных по "Связанным полям" и "Измерениям, перенесенным из компонентов".
③ Объедините таблицы, полученные после агрегирования.
Возьмем, к примеру, следующий случай:
Чтобы узнать, достигли ли продажи в каждом регионе целевого показателя, в компоненте нужно использовать поля "Регион, Продажи, Целевой показатель продаж":
① Для участия в тематической модели система принимает только три поля "Регион, Продажи, Цель продаж";
② Агрегируйте две таблицы, смоделированные с помощью размеров, перетащенных в компонент по "региону";
③ Объедините две таблицы, полученные в результате агрегирования по "региону", чтобы получить итоговую таблицу;
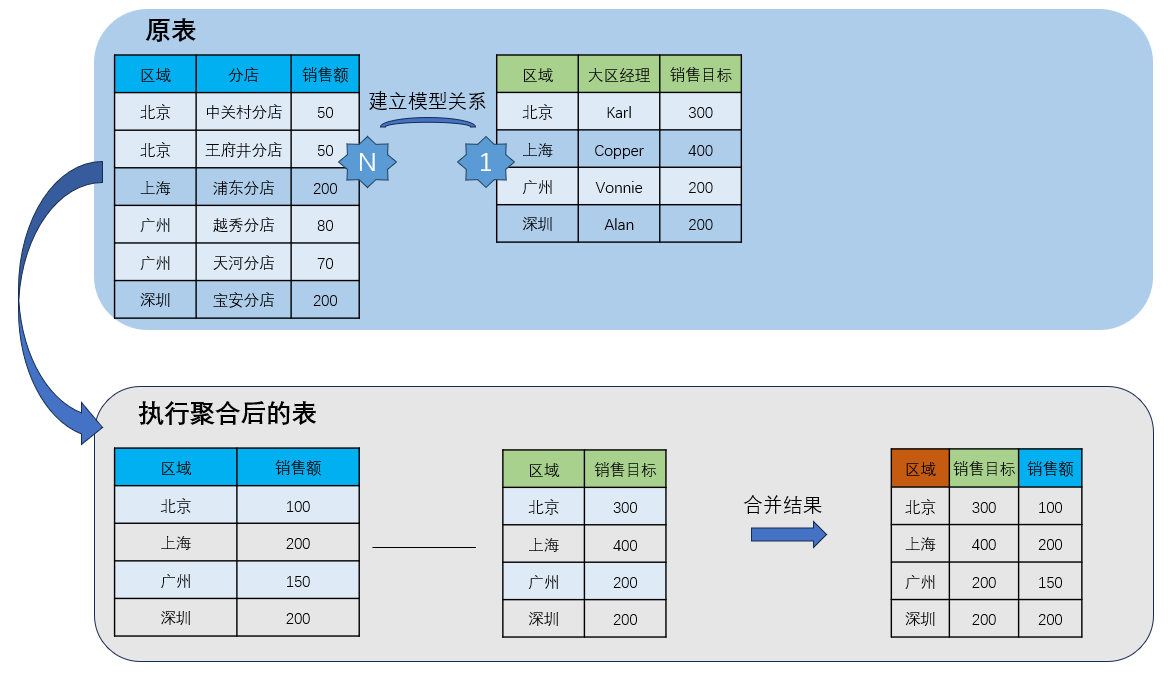
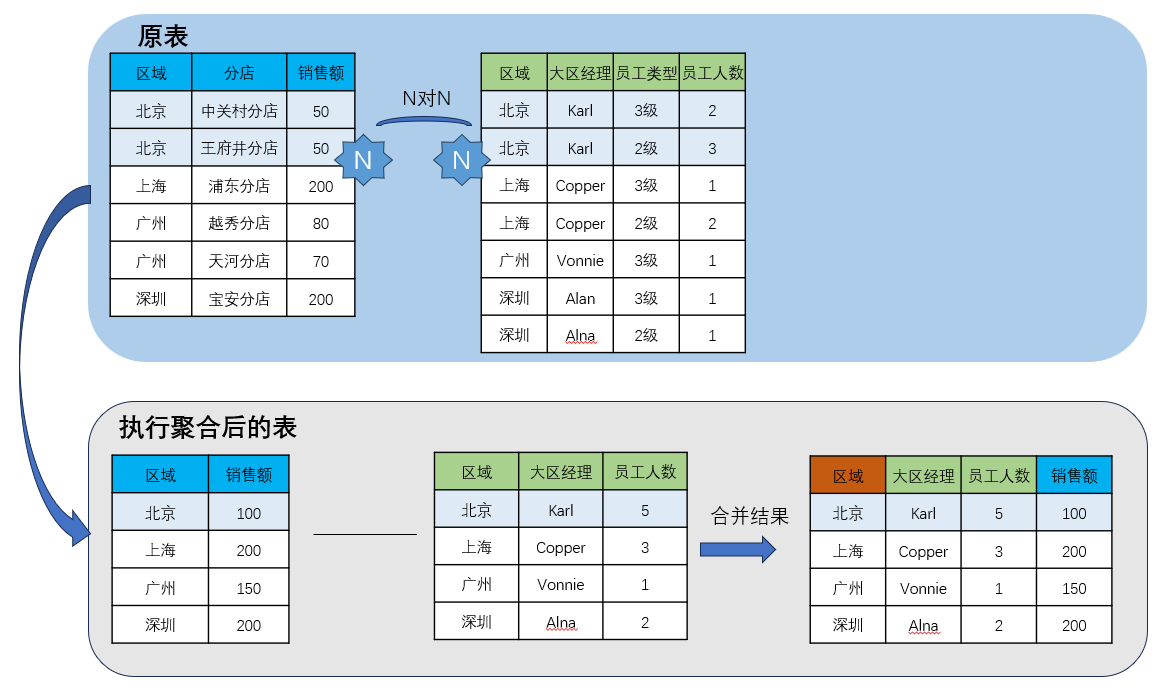
Посмотрите на другой случай N-to-N:
Чтобы узнать количество продаж на душу населения в команде каждого регионального менеджера, в компоненте нужно использовать поля "Региональный менеджер, Продажи, Количество сотрудников".
① Система принимает для участия в тематической модели только "Региональный менеджер, продажи, количество сотрудников" и связанное с ним поле "Регион";
② Агрегируйте две таблицы, которые были смоделированы измерением "Региональный менеджер", перетащенным в компонент;
③ Объедините две таблицы, полученные в результате агрегирования по связанному полю "регион", чтобы получить итоговую таблицу;
Получив результат, мы используем sum_agg(sales)/sum_agg(number of people) в компоненте, чтобы найти продажи на душу населения.
4. Как обрабатывается модель с несколькими таблицами
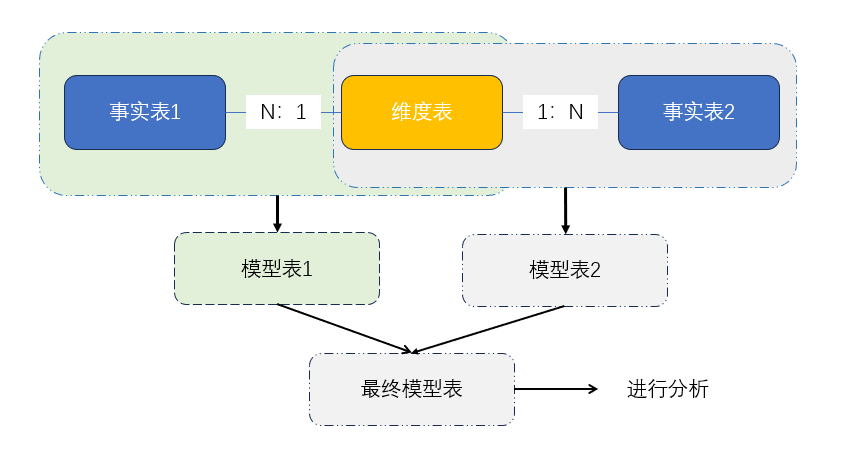
Если в модели более двух таблиц, то получите результаты моделирования по две, а затем попросите выдать результаты моделирования.
Например, если мы хотим использовать для анализа поля в "Таблице фактов 1" и "Таблице фактов 2", как можно объединить эти две таблицы?
Система будет следовать логике объединения тематической модели, чтобы получить результаты моделирования "Таблица фактов 1, таблица измерений" и "Таблица фактов 2, таблица измерений", и использовать полученные результаты моделирования для объединения их в итоговую таблицу, которую мы хотим использовать, и которую нам удобно анализировать.
5. Далее: Как моделирование тем обеспечивает целостность данных
Все мы знаем, что объединение слева и справа выполняется путем выбора "left merge, right merge, union merge, intersection merge", чтобы определить, какую часть данных нам нужно сохранить.
Однако субъектная модель не требует от нас выбора, так как же она обеспечивает целостность данных?
Как тематическая модель обеспечивает целостность данных, вы узнаете сами.